데브옵스
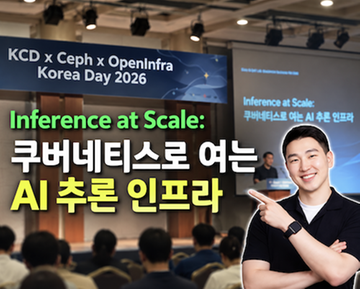
쿠버네티스로 여는 AI 추론 인프라
두줄요약
쿠버네티스와 AWS EKS를 활용해 LLM 추론 인프라를 안정적으로 운영하는 방법을 설명했습니다. 특히 KV 캐시를 고려한 라우팅과 prefill/decode 분리를 통해 성능과 비용을 함께 개선하는 흐름을 다뤘습니다.
핵심 내용
- AI 컴퓨팅의 무게중심이 학습에서 추론으로 이동하며, 도메인 특화 모델과 대규모 추론 인프라 수요가 커진 흐름
- 쿠버네티스가 분산 운영, 오토스케일링, 서비스 디스커버리, 선언적 운영 측면에서 추론 인프라의 표준으로 자리잡는 배경
- LLM 추론에서 KV 캐시 미스와 랜덤 분산의 한계를 줄이기 위한 AI 라우터 llm-d, prefill/decode 분리, EKS와 Karpenter 활용 방식
구조와 흐름
- 자기회귀 추론과 KV 캐시, prefill과 decode의 성격 차이 설명
- 일반 Service 기반 부하 분산의 캐시 미스 문제와 inference-aware routing 필요성 정리
- 대규모 운영에서의 확장성, 관측성, 비용 최적화, 관리형 EKS 및 Auto Mode 소개
선택 이유
- Prefill은 연산 바운드, decode는 메모리 대역폭 바운드라 분리 운영이 유리한 점
- 쿠버네티스 네이티브 표준과 CNCF 프로젝트 기반 AI 라우팅을 결합할 수 있는 점
- AWS 관리형 기능으로 컨트롤 플레인 운영 부담을 줄이면서도 대규모 추론을 안정적으로 운영할 수 있는 점
성능/운영 포인트
- KV 캐시 히트율, TTFT, ITL, GPU 활용률, goodput 같은 추론 중심 지표의 중요성
- Karpenter의 노드 통합, Spot 활용, 오토스케일링으로 GPU 유휴 비용 절감
- EKS의 가속기 스케줄링, 울트라스케일 클러스터, 고속 인터커넥트 활용으로 대규모 운영 지원