백엔드
일본어 상품 검색 정확도 높이기: Elasticsearch + Kuromoji에서 OpenSearch + Sudachi로
두줄요약
Elasticsearch의 Kuromoji와 오래된 사전으로는 일본어 상품 검색 정확도에 한계가 있었습니다. OpenSearch와 Sudachi, Multi-field 전략으로 복합어·모델명·자동완성을 함께 개선했습니다.
문제 상황
- Elasticsearch 7.10.2 환경의 Kuromoji 기본 설정으로 일본어 상품명이 과도하게 분해되어 검색 정확도 저하 발생
- IPADIC 사전의 오래된 데이터로 신조어, 고유명사, 모델명 변형 대응 한계
- 영문·숫자 혼합 모델 번호와 전각·반각 구분자 혼용으로 검색 불일치 발생
원인 분석
- 상품명 검색 특성에 맞춘 analyzer 튜닝 부재
- 사용자 사전 추가 방식의 임시 대응으로는 빠른 도메인 변화 흡수 불가
- 형태소 분석만으로는 문자열 정규화와 접두사 자동완성 요구를 동시에 충족하기 어려움
해결 방법
- OpenSearch 2.15.0으로 전환하고 Sudachi analyzer 도입
- 복합어와 고유명사를 더 잘 유지하는 C 모드와 sudachi_split 활용
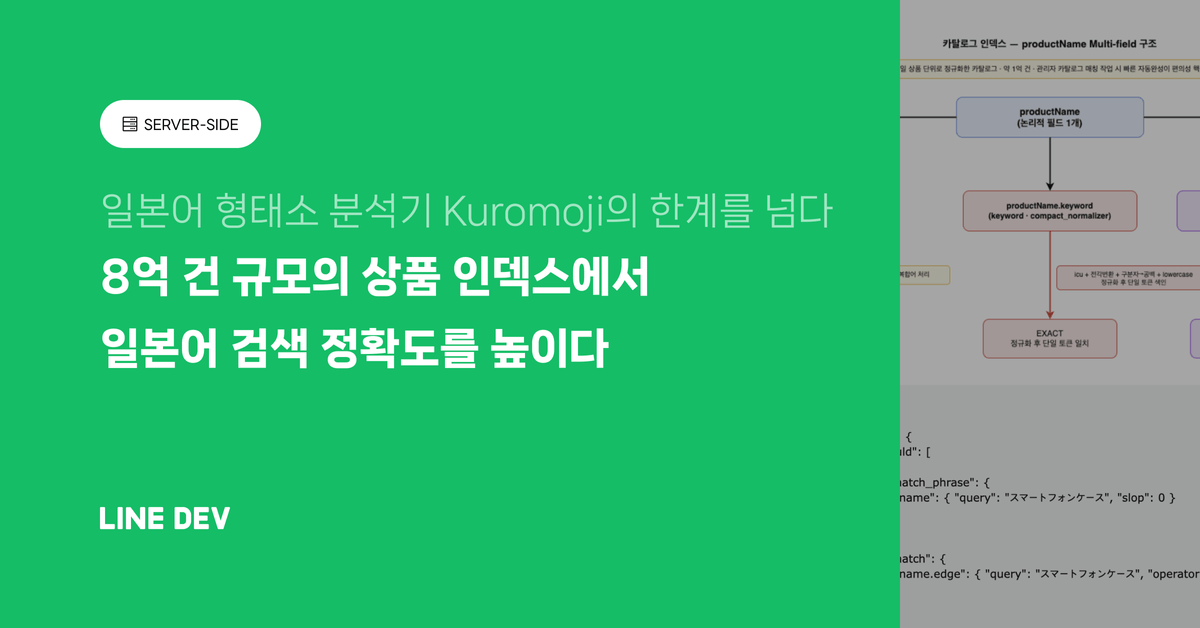
- Multi-field 전략으로 compact, edge, keyword 서브 필드 분리
- compact_product_name_analyzer와 edge N-gram으로 모델명 검색과 자동완성 보완
성능/운영 포인트
- 8억 건 상품 인덱스에는 Edge N-gram을 적용하지 않아 인덱스 팽창과 색인 지연 억제
- 1억 건 카탈로그 인덱스에만 edge 필드를 두고 자동완성 품질과 비용 균형 조정
- 검색어 길이와 영숫자 포함 여부에 따라 compact 필드 조건부 활성화