백엔드
[BigData] Spark 개요 정리
두줄요약
Spark의 개요와 주요 구성요소, 장점을 정리한 글입니다. 대용량 데이터 처리에서 Pandas보다 Spark가 더 적합한 성능 사례도 비교했습니다.
핵심 내용
- Spark를 대규모 데이터 처리용 통합 분석 엔진으로 정리
- Spark Core, Spark SQL, Spark Streaming, MLlib, GraphX 등 주요 구성요소 소개
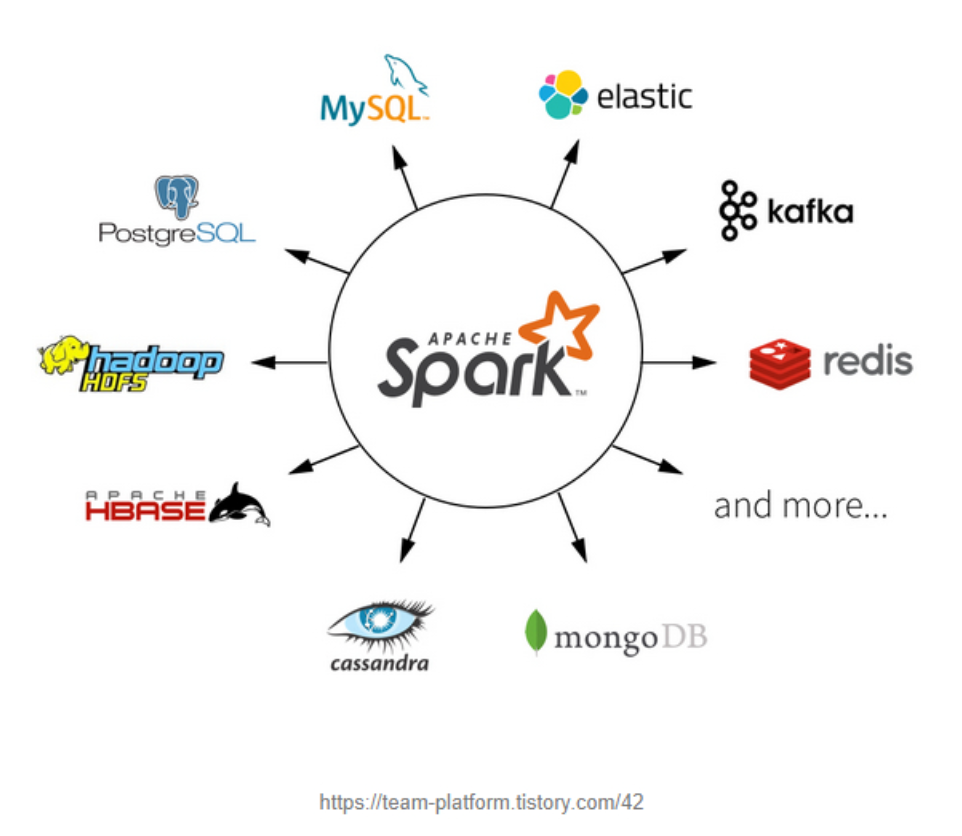
- Hadoop, Kubernetes 등 다양한 환경과 스토리지에 연결해 연산 수행
선택 이유
- Hadoop 맵리듀스 대비 빠른 처리 속도와 DAG 기반 최적화
- Scala, Python, R, SQL 등 다양한 언어와 상호작용 가능한 사용 편의성
- SQL, 스트리밍, 머신러닝, 그래프 처리를 하나의 애플리케이션에서 결합 가능
장단점
- 장점: 대용량 처리에 강점, 내결함성, 오픈소스 커뮤니티 지원
- 장점: Pandas보다 큰 데이터에서 읽기와 집계 성능 우위
- 단점: 저장소가 아니라 연산 엔진 중심으로 동작
적용해볼 점
- 10GB 이상 대용량 데이터는 Pandas보다 Spark 활용 검토
- 구조화 데이터는 Spark SQL과 DataFrame API 중심으로 처리
- 배치와 스트리밍을 같은 방식으로 다루는 워크플로우 설계