

딥러닝 모델 서비스 A-Z 2편 - Knowledge Distillation
대형 BERT 기반 대화 모델을 Knowledge Distillation으로 경량화한 사례를 소개했습니다. 임베딩·로짓 증류로 약 3배 추론 속도와 높은 정확도를 확보했습니다.
#Knowledge Distillation#BERT
000

대형 BERT 기반 대화 모델을 Knowledge Distillation으로 경량화한 사례를 소개했습니다. 임베딩·로짓 증류로 약 3배 추론 속도와 높은 정확도를 확보했습니다.

EMNLP 2020의 주요 키워드와 자연어 생성·대화·지식 활용 연구 흐름을 정리했습니다. 응답 생성, 임베딩, 상식 질의응답 등 7편의 논문 핵심 아이디어를 리뷰했습니다.
준지도학습의 기본 개념과 주요 가정, 대표 기법들을 정리한 소개 글입니다. 레이블 부족 문제를 줄이는 방법이지만, 데이터와 모델 특성에 맞는 선택이 중요했습니다.

이루다 베타 테스트에서 리텐션·대화량·사용자층·대화 주제를 분석해 제품 가능성을 검증했습니다. 일상 대화 기술 고도화와 관계형 콘텐츠, 게임 기능으로 반복 사용을 강화했습니다.
PyTorch로 커스텀 이미지 분류 데이터셋과 VGG 기반 학습기를 구성했습니다. 학습·평가·모델 저장과 GPU 가속, 학습률 스케줄링 흐름을 설명합니다.

GPT-3를 57개 분야 문제로 평가한 벤치마크와 43.9% 정답률을 살펴봤습니다. 모델 규모와 과제 특화 학습이 성능·효율에 미치는 영향을 정리했습니다.

루다는 자유 대화와 이벤트 대화를 결합해 사용자와의 친밀한 관계 형성을 설계했습니다. Pingpong FLOW의 한계는 페르소나·주제 전환·개인화 시나리오로 보완했습니다.
PyTorch와 MNIST로 지도학습 Trainer의 필수 구성 요소와 학습 흐름을 설명했습니다. 학습·평가 루프와 정확도 측정, 모델 체크포인트 저장 예시를 제공했습니다.
NER은 비정형 텍스트에서 개체명을 분류해 문맥에 맞는 검색·뉴스 분류에 활용하는 기술입니다. 포털 사례를 바탕으로 임베딩, BiLSTM, CRF로 구현 흐름을 설명했습니다.
이스트소프트와 자회사가 디지털 뉴딜 AI 정부 사업 총 100억 원 규모를 수주했습니다. 데이터 구축, 연구개발, AI 솔루션 공급으로 사업이 구성되었습니다.

핑퐁팀의 2020년 여름 머신러닝 세미나 발표자료를 모아 공유했습니다. NLP 표현·평가와 검색, 편향, 대조 학습 관련 연구를 다뤘습니다.
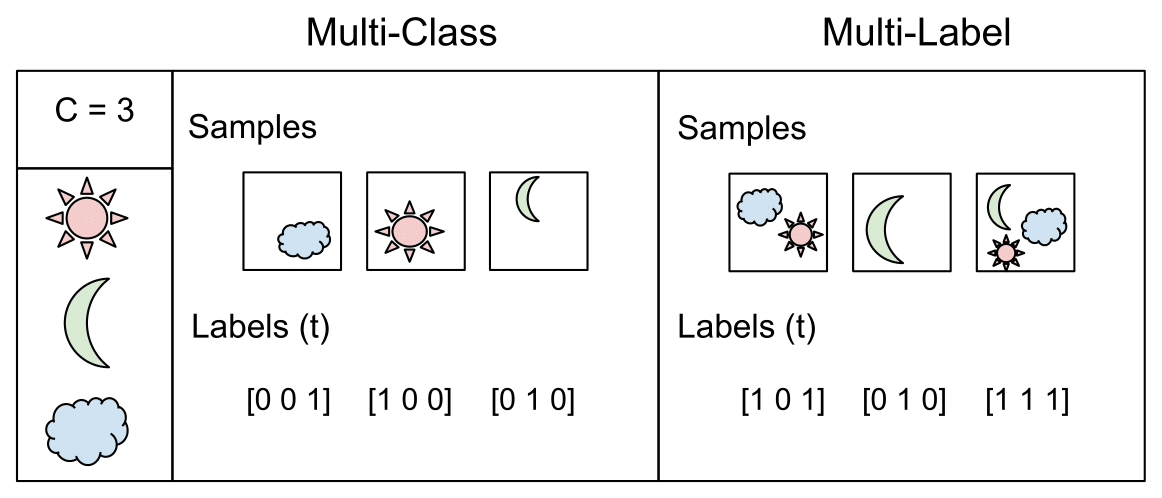

Multi-label 분류에서 Prec@k와 Rec@k를 높이는 최적 점수 순위의 차이를 설명했습니다. 목표 지표에 따라 OVA·PAL 또는 정규화 reduction을 선택해야 함을 정리했습니다.
객체 탐지용 이미지 증강에서 Bounding Box를 함께 변환하는 좌표 연산을 설명했습니다. Resize·반전·회전별 계산과 회전 후 경계 보정 방법을 제시했습니다.
ICML 2020 논문으로 범주형 확률에 베이지안 관점을 적용한 분류 학습 방법을 소개했습니다. 오버 컨피던스를 줄이고 예측 불확실성을 더 잘 표현하며 분류 성능도 향상시켰습니다.