옮기는 것보다 증명이 어렵다
클레임 검색 색인을 변경 알림 방식에서 데이터베이스 변경 로그 기반 CDC로 전환했습니다. 누락·값·지연 관점에서 새 색인의 정확성을 검증하는 과정을 다룹니다.
#CDC#검색#데이터베이스
3200
클레임 검색 색인을 변경 알림 방식에서 데이터베이스 변경 로그 기반 CDC로 전환했습니다. 누락·값·지연 관점에서 새 색인의 정확성을 검증하는 과정을 다룹니다.
KIMS가 가시성이 낮은 국제 MO 메시지 인증 문제를 해결한 여정을 소개했습니다. 국제 MO 메시지 전환율을 90%대까지 높였습니다.
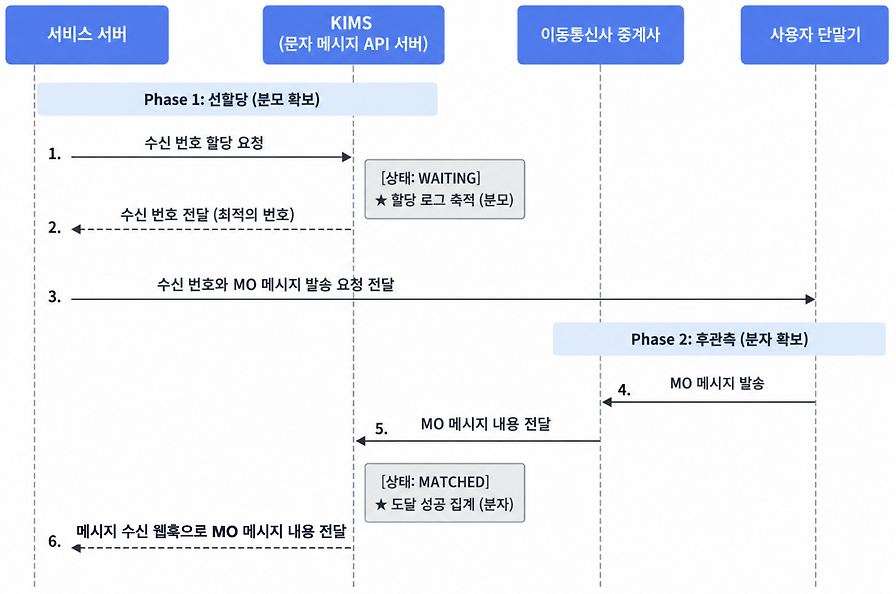
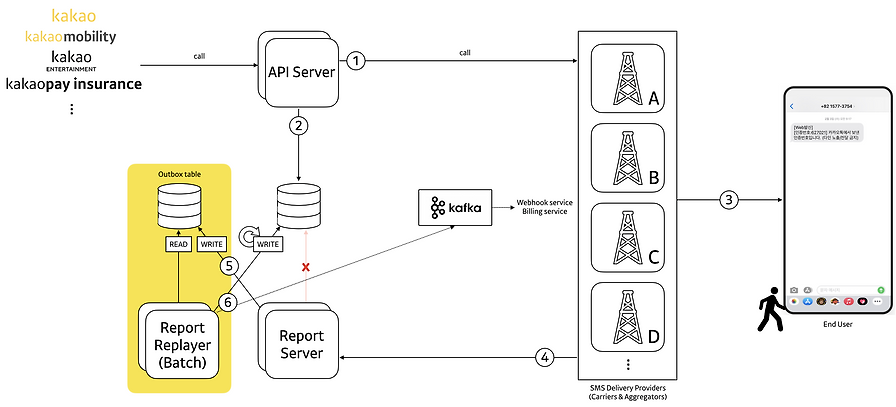
카카오 메시징 시스템의 경쟁 조건 문제와 안티 패턴 제거 과정을 다룬 기술 사례입니다. 메시지 리포트가 사라지는 문제를 비유로 설명합니다.
MongoDB 새 GA 버전이 공개될 때 업그레이드를 검토하는 운영 관점을 소개했습니다. 안정성을 중시하며 MongoDB 8.0 업그레이드 이유를 정리한 글입니다.

MySQL의 DATETIME과 TIMESTAMP 데이터 타입을 비교·분석하는 글입니다. 다만 발췌만으로는 구체적인 차이와 결론을 충분히 확인하기 어렵습니다.
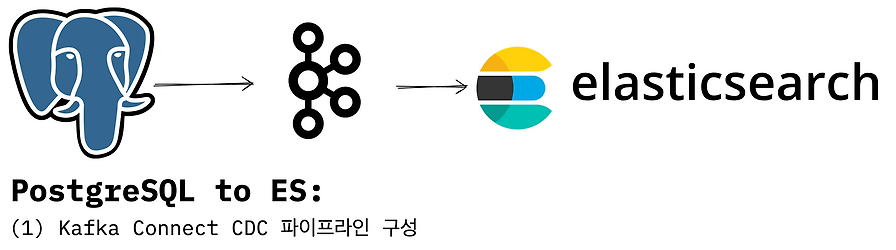
PostgreSQL 데이터를 Elasticsearch로 동기화하는 Kafka Connect CDC 파이프라인 구성 글입니다. 10년 넘게 운영한 레거시 시스템의 검색 연동 맥락을 소개합니다.
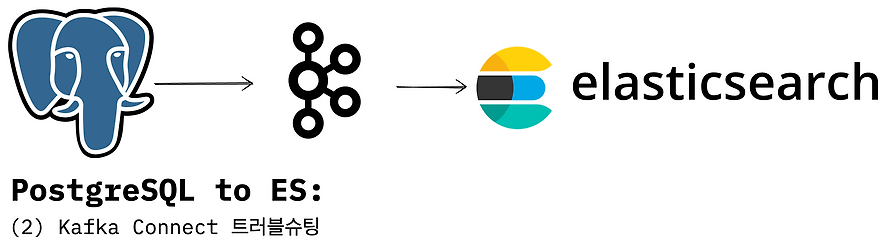
PostgreSQL에서 ES로의 CDC 파이프라인을 Kafka Connect로 구성한 뒤의 트러블슈팅 글입니다.
대규모 MySQL 운영 환경에서 고가용성을 위한 새로운 HA 표준 개발 사례를 다뤘습니다. 기존 MHA와 MySQL Orchestrator를 바탕으로 운영 표준화를 시도했습니다.
MySQL의 JSON 데이터 타입 저장 구조와 성능 차이를 비교하는 글입니다. 5.7.8부터 지원된 JSON 타입의 특징과 일반 문자열 저장 방식의 차이를 다룹니다.
MySQL 8.0의 Instant DDL Algorithm을 소개하는 글입니다. MySQL이 웹서비스 개발자들에게 널리 쓰여 온 배경도 함께 언급했습니다.
MySQL InnoDB의 Redo Log와 WAL 개념을 개요 수준에서 설명한 글입니다. 트랜잭션 무결성과 영속성 관점의 로그 관리 흐름을 정리했습니다.
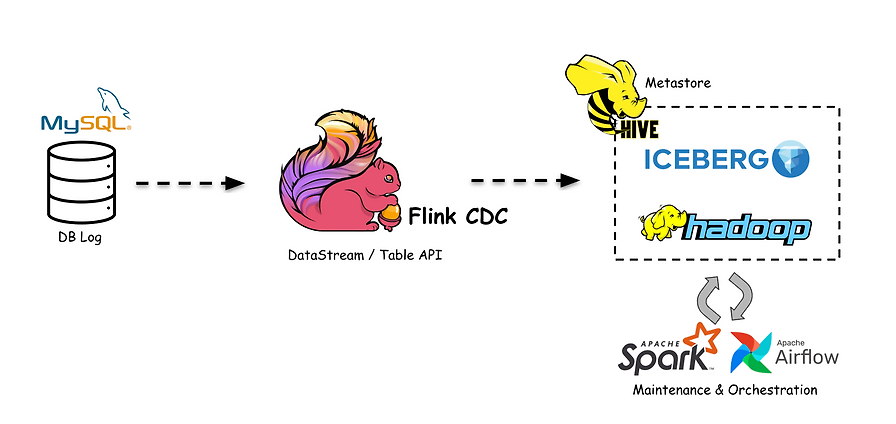
CDC 파이프라인 정합성 검사 Spark 잡의 코드 설계 배경을 소개했습니다. 대규모 데이터 응집 환경에서 검증용 잡을 어떻게 구성할지 다루는 글입니다.
CDC 파이프라인 정합성 검사 Spark 잡의 최적화 방법을 다룬 후속 글입니다. 앞선 코드 설계편에 이어 Spark 잡 성능 개선과 운영 관점을 소개했습니다.
MySQL의 caching_sha2_password 인증 플러그인을 소개하는 글입니다.
MySQL ALTER DDL 수행 방식을 이해하기 위한 글의 개요를 소개했습니다.
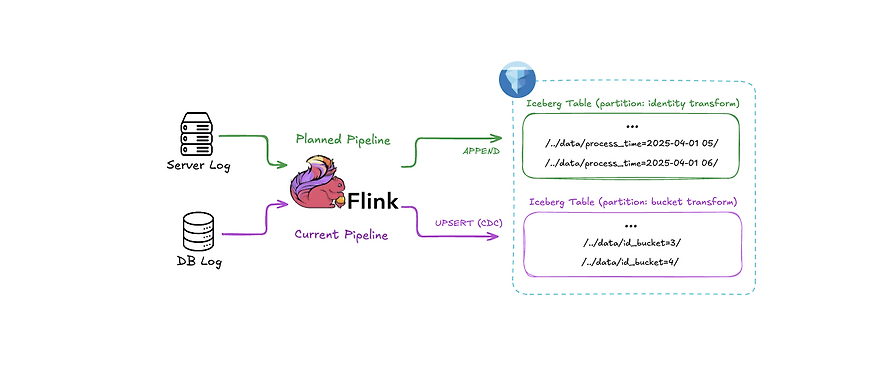
Iceberg 테이블로 DB 로그와 서버 로그를 적재·운영하며 얻은 경험을 정리한 글입니다. 로그 유형별 운영 전략과 실무 교훈을 중심으로 다뤘습니다.
API의 case를 추가 배포 없이 통일하는 방법을 다룬 글입니다. 백엔드 운영 중 응답 형식 정리와 배포 부담 완화 사례를 공유했습니다.

Apache Iceberg와 Flink CDC를 다루는 심층 탐구 글입니다. 발췌만으로는 구체적 내용 확인이 어려워 핵심 주제만 요약했습니다.