
Nota AI가 제안하는 Transformer 모델을 AWS Inferentia/Trainium에 손쉽게 배포하는 방법
Hugging Face Transformer 모델을 AWS Inferentia/Trainium에 포팅하는 과정을 검증했습니다. return_dict=False 설정으로 tracing 오류를 줄여 12개 모델 모두 배포 가능함을 확인했습니다.
#AWS#Transformer#LLM
4000


Hugging Face Transformer 모델을 AWS Inferentia/Trainium에 포팅하는 과정을 검증했습니다. return_dict=False 설정으로 tracing 오류를 줄여 12개 모델 모두 배포 가능함을 확인했습니다.
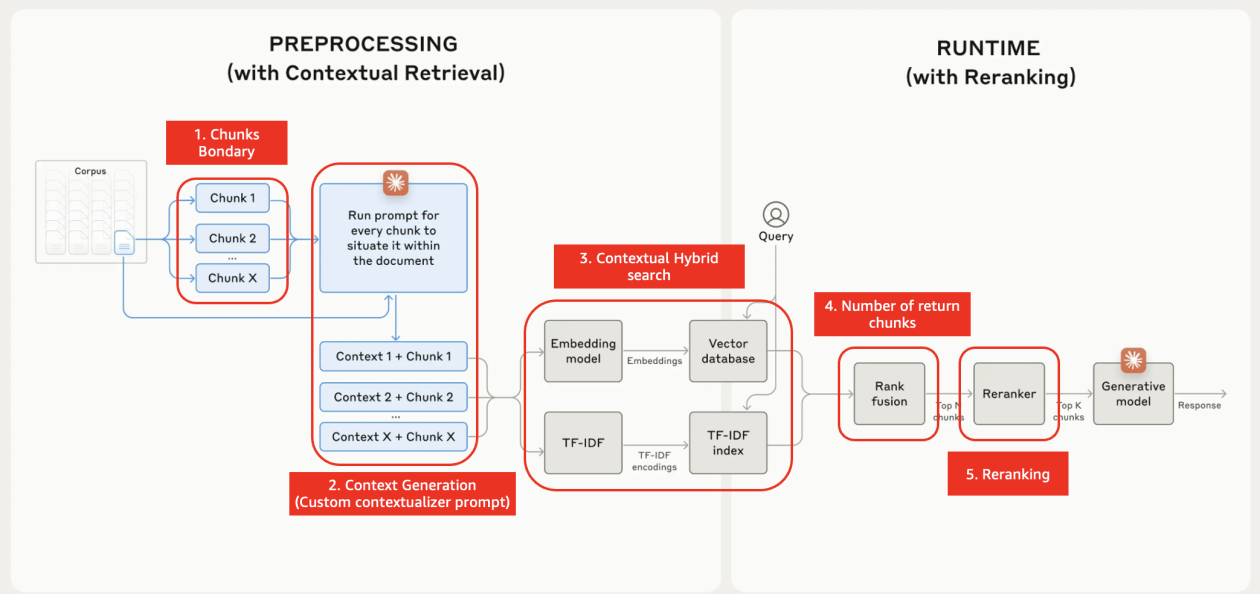
Amazon Bedrock에서 Contextual Retrieval로 RAG 검색 정확도를 높이는 방법을 설명했습니다. 전처리 컨텍스트 생성, 하이브리드 검색, 리랭킹, 프롬프트 캐싱까지 실무 구성을 함께 다뤘습니다.
Amazon Bedrock과 AWS Config로 규제 요구사항을 규칙에 자동 매핑하는 도구를 소개했습니다. 수동 관리의 한계를 줄이기 위한 프롬프트 설계와 운영 포인트도 함께 설명했습니다.

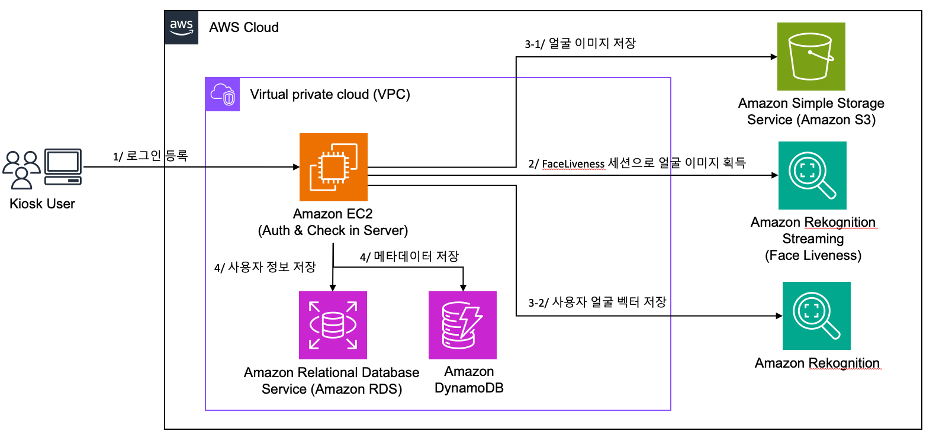
Amazon Rekognition Face Liveness로 무인 키오스크의 얼굴 등록과 로그인 흐름을 구현한 사례를 다뤘습니다. SAGA 패턴과 스냅샷 기반 인식으로 일관성과 저사양 기기 호환성도 함께 확보했습니다.
Amazon Bedrock과 Amazon OpenSearch로 헤지펀드용 Company Screener Agent를 구현한 사례를 소개했습니다. 금융 특화 임베딩과 하이브리드 검색으로 종목 선별, 요약, 검증을 자동화한 효과를 설명했습니다.

Amazon Bedrock과 Claude 3 Haiku로 연말정산 Q&A 챗봇을 구축해 문의 대응을 개선했습니다. 구조화 데이터와 프롬프트 최적화를 통해 직접 문의를 약 40% 줄이고 생산성을 높였습니다.

AWS Step Functions와 Amazon Bedrock으로 IAM Policy를 자동 생성·검증·할당하는 워크플로를 소개했습니다. 임시 권한 부여와 자동 회수로 최소 권한 원칙과 운영 효율성을 높이는 방법을 다뤘습니다.

Amazon Bedrock 사용자 지정 모델로 DeepSeek-R1 Distill Llama를 배포하는 방법을 안내했습니다. 서버리스 호스팅, 비용 구조, 버전 관리와 모니터링 포인트도 함께 정리했습니다.

Amazon Bedrock의 지연 시간 최적화 추론이 LLM 응답성 개선에 어떻게 기여하는지 정리했습니다. TTFT, OTPS, E2E 지표와 함께 프롬프트·아키텍처 최적화 방법도 살펴보았습니다.
Amazon Bedrock의 비정형 데이터 처리 기능과 활용 사례를 정리했습니다. 멀티모달 처리와 GraphRAG로 RAG 품질을 높이는 방법을 소개했습니다.

Amazon Bedrock과 Amazon Neptune으로 GraphRAG 애플리케이션을 구축하는 방법을 소개했습니다. LlamaIndex와 NL2GraphQuery를 활용해 지식 그래프 검색과 개인화 추천을 연결했습니다.

SK하이닉스가 AWS 환경에서 RAG 플랫폼을 구축하고 성능을 평가한 사례를 소개했습니다. 데이터셋 크기와 인덱스 메모리가 검색 지연과 TTFT에 미치는 영향을 분석했습니다.
