
[Nota AI Server] 온프레미스 LLM 구축, GPU 사기 전에 확인해야 할 것
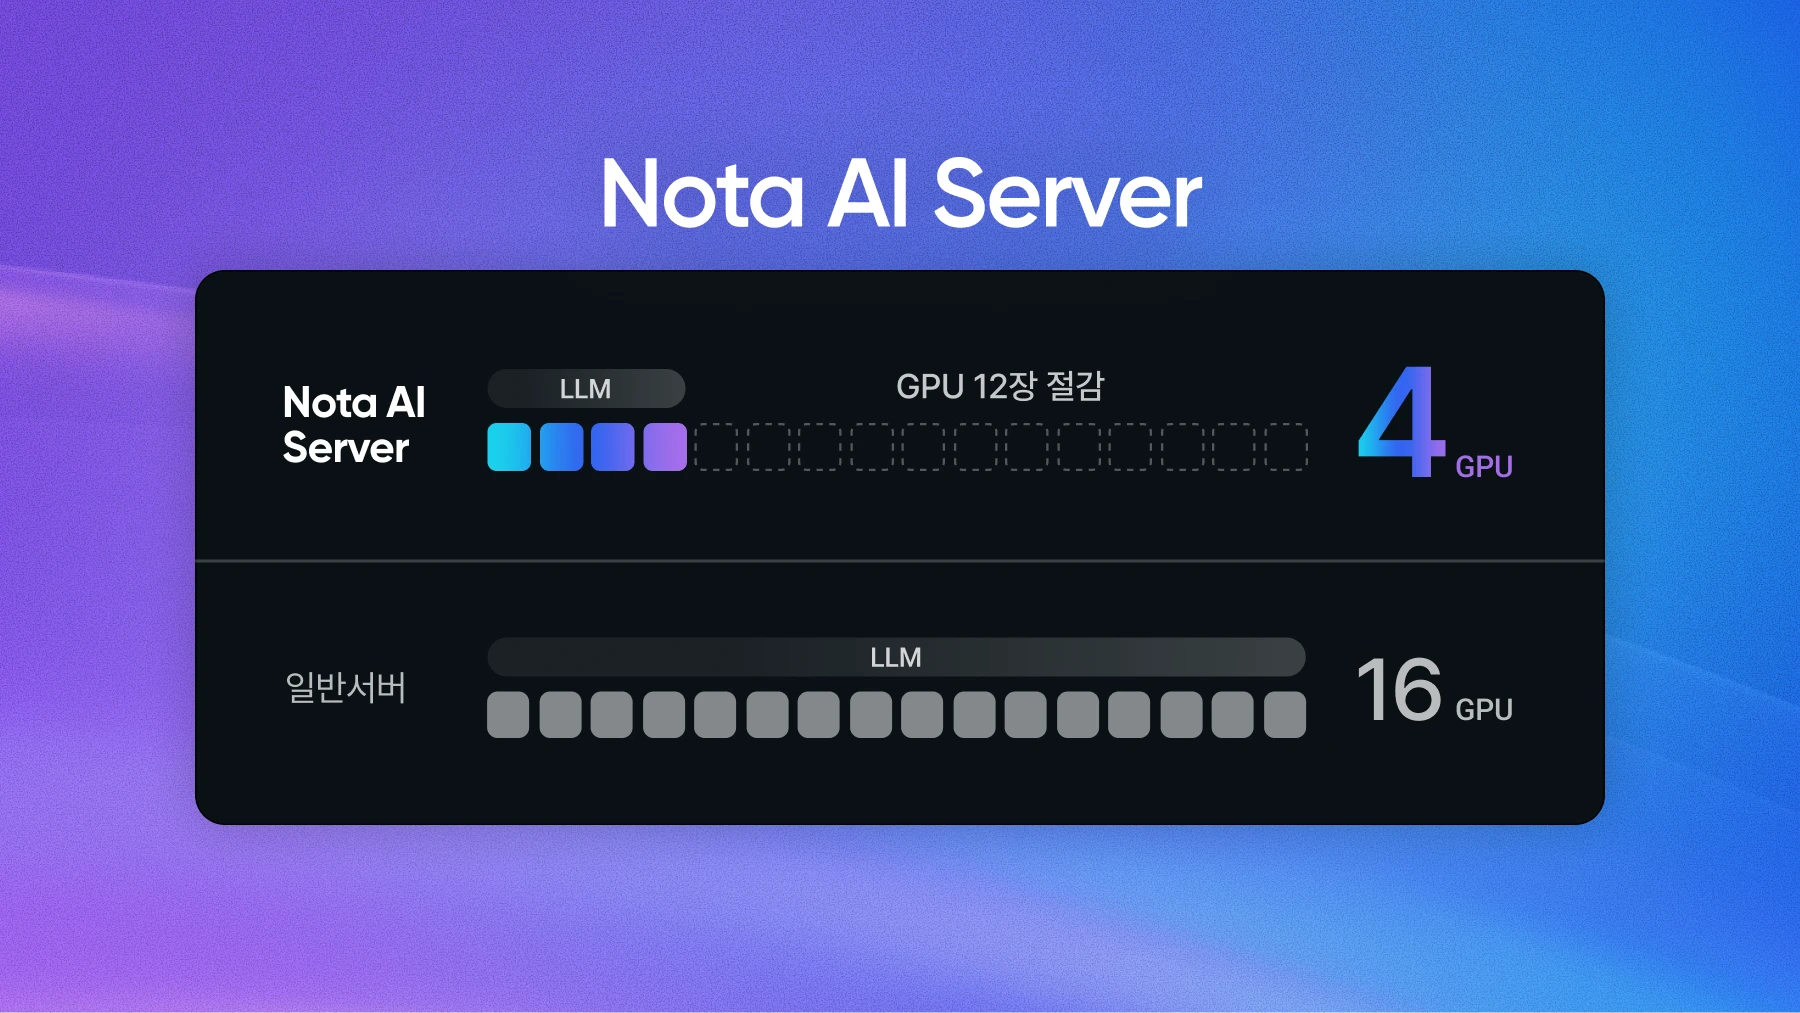
온프레미스 LLM의 GPU 수는 모델 크기뿐 아니라 양자화·가지치기와 KV 캐시 조건을 함께 고려해야 합니다. Nota AI Server는 최적화와 서빙 구성을 사전 검증해 GPU 절감 구성을 제공합니다.
#LLM#MoE
900
온프레미스 LLM의 GPU 수는 모델 크기뿐 아니라 양자화·가지치기와 KV 캐시 조건을 함께 고려해야 합니다. Nota AI Server는 최적화와 서빙 구성을 사전 검증해 GPU 절감 구성을 제공합니다.
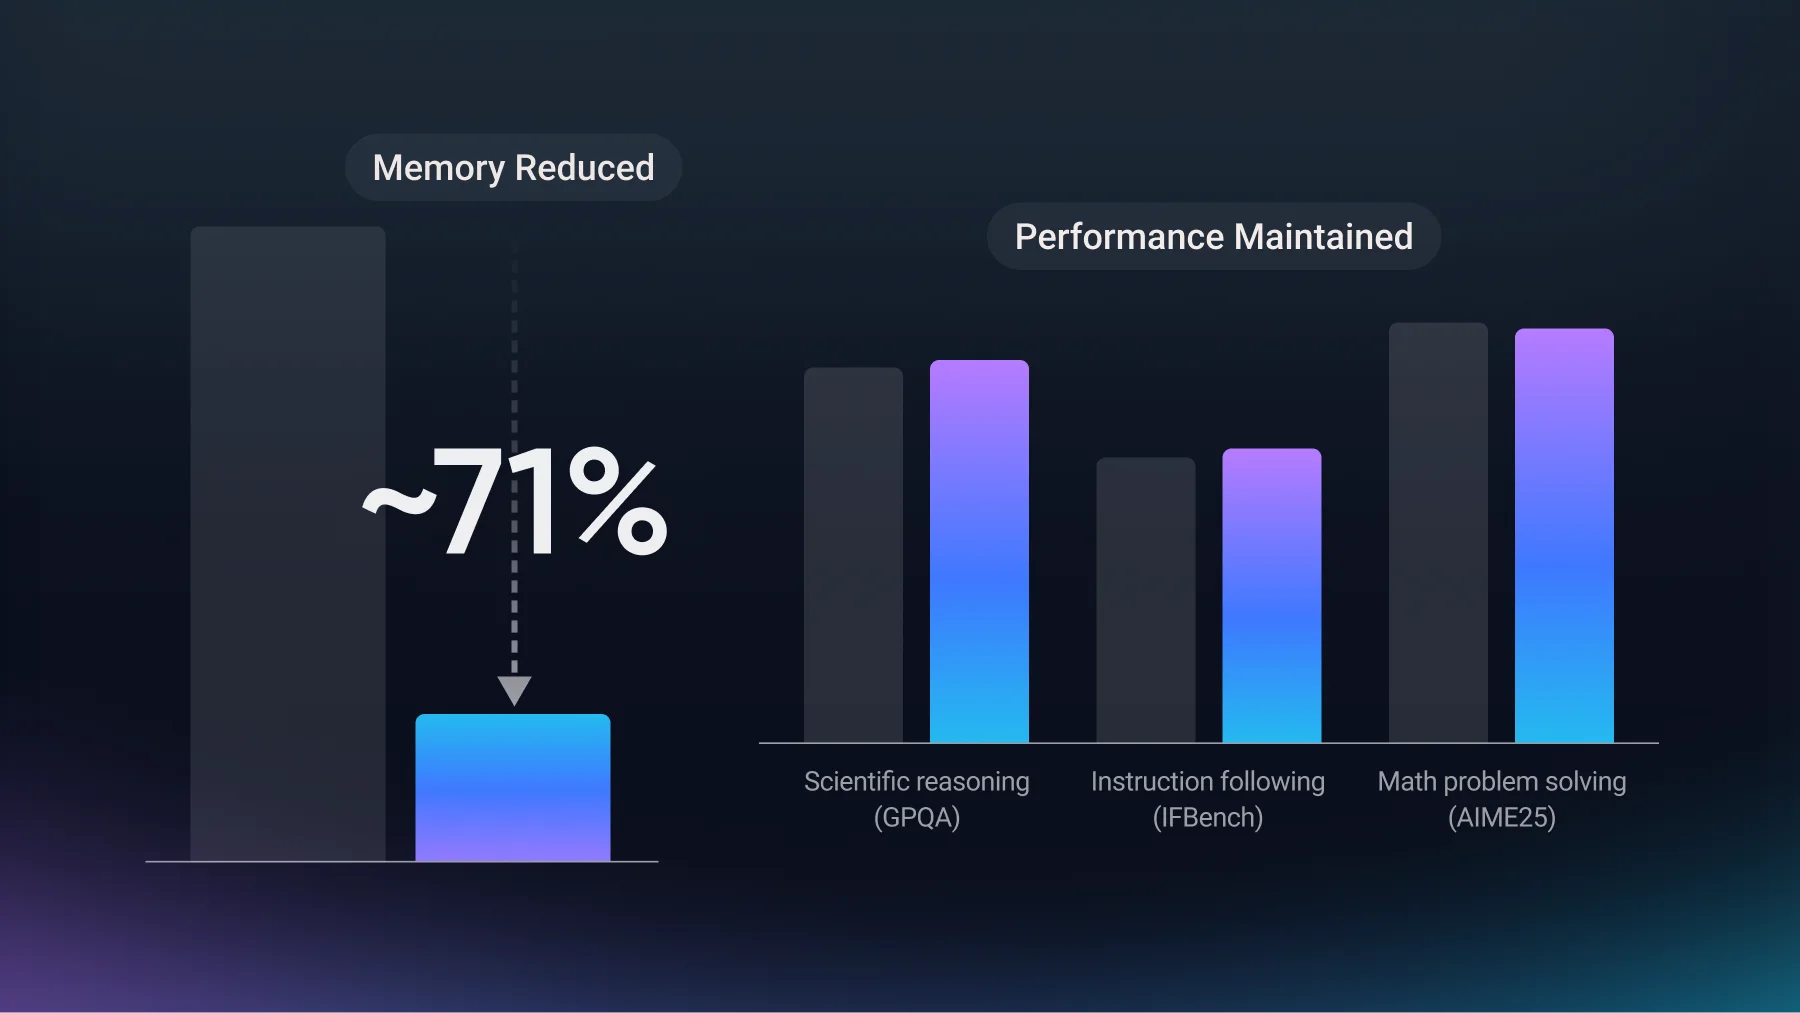
K-EXAONE-236B MoE의 집중 이상치를 오프라인 변환으로 제어해 NVFP4로 양자화했습니다. 추가 커널 없이 vLLM에서 서빙하며 BF16 수준 정확도와 약 3.5배 압축을 제시했습니다.


비동기 GRPO 인프라와 TIS 보정으로 rollout·학습 간 확률 불일치를 안정화했습니다. 리워드 해킹을 완화해 DPO 대비 이용시간과 리텐션을 개선했습니다.
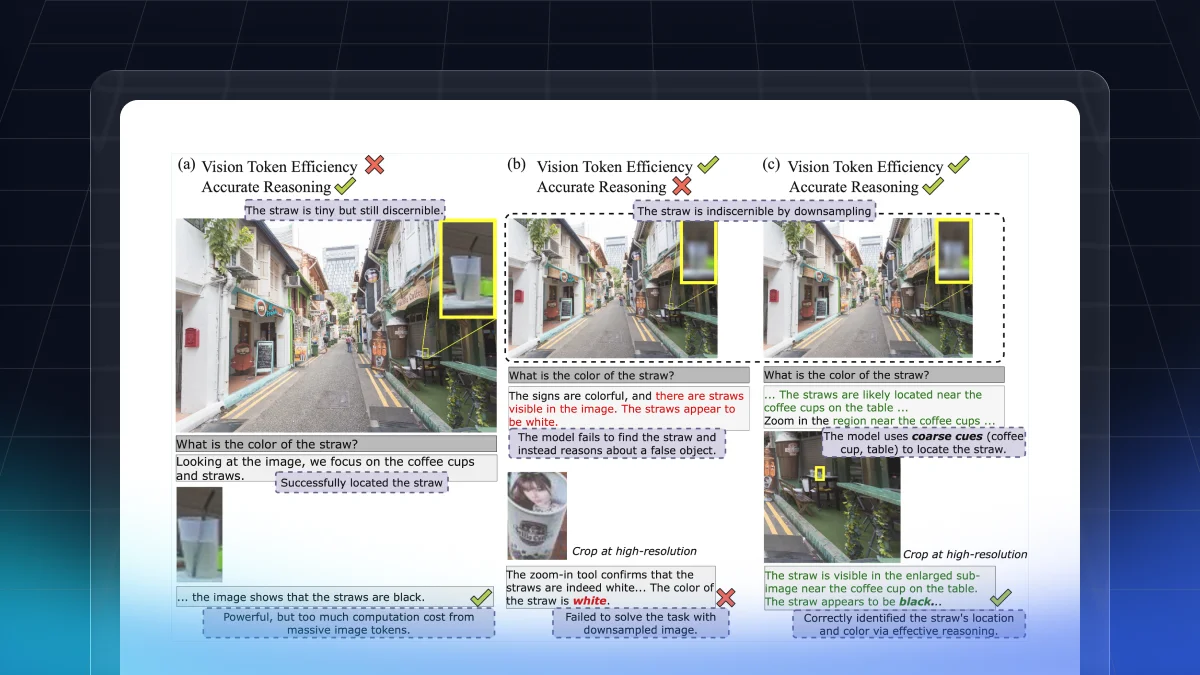
ERGO는 질의와 장면 문맥으로 중요한 영역을 먼저 찾는 2단계 비전-언어 추론을 제안했습니다. 강화학습 보상 설계로 비전 토큰을 줄이면서 정확도와 실제 지연 시간을 개선했습니다.
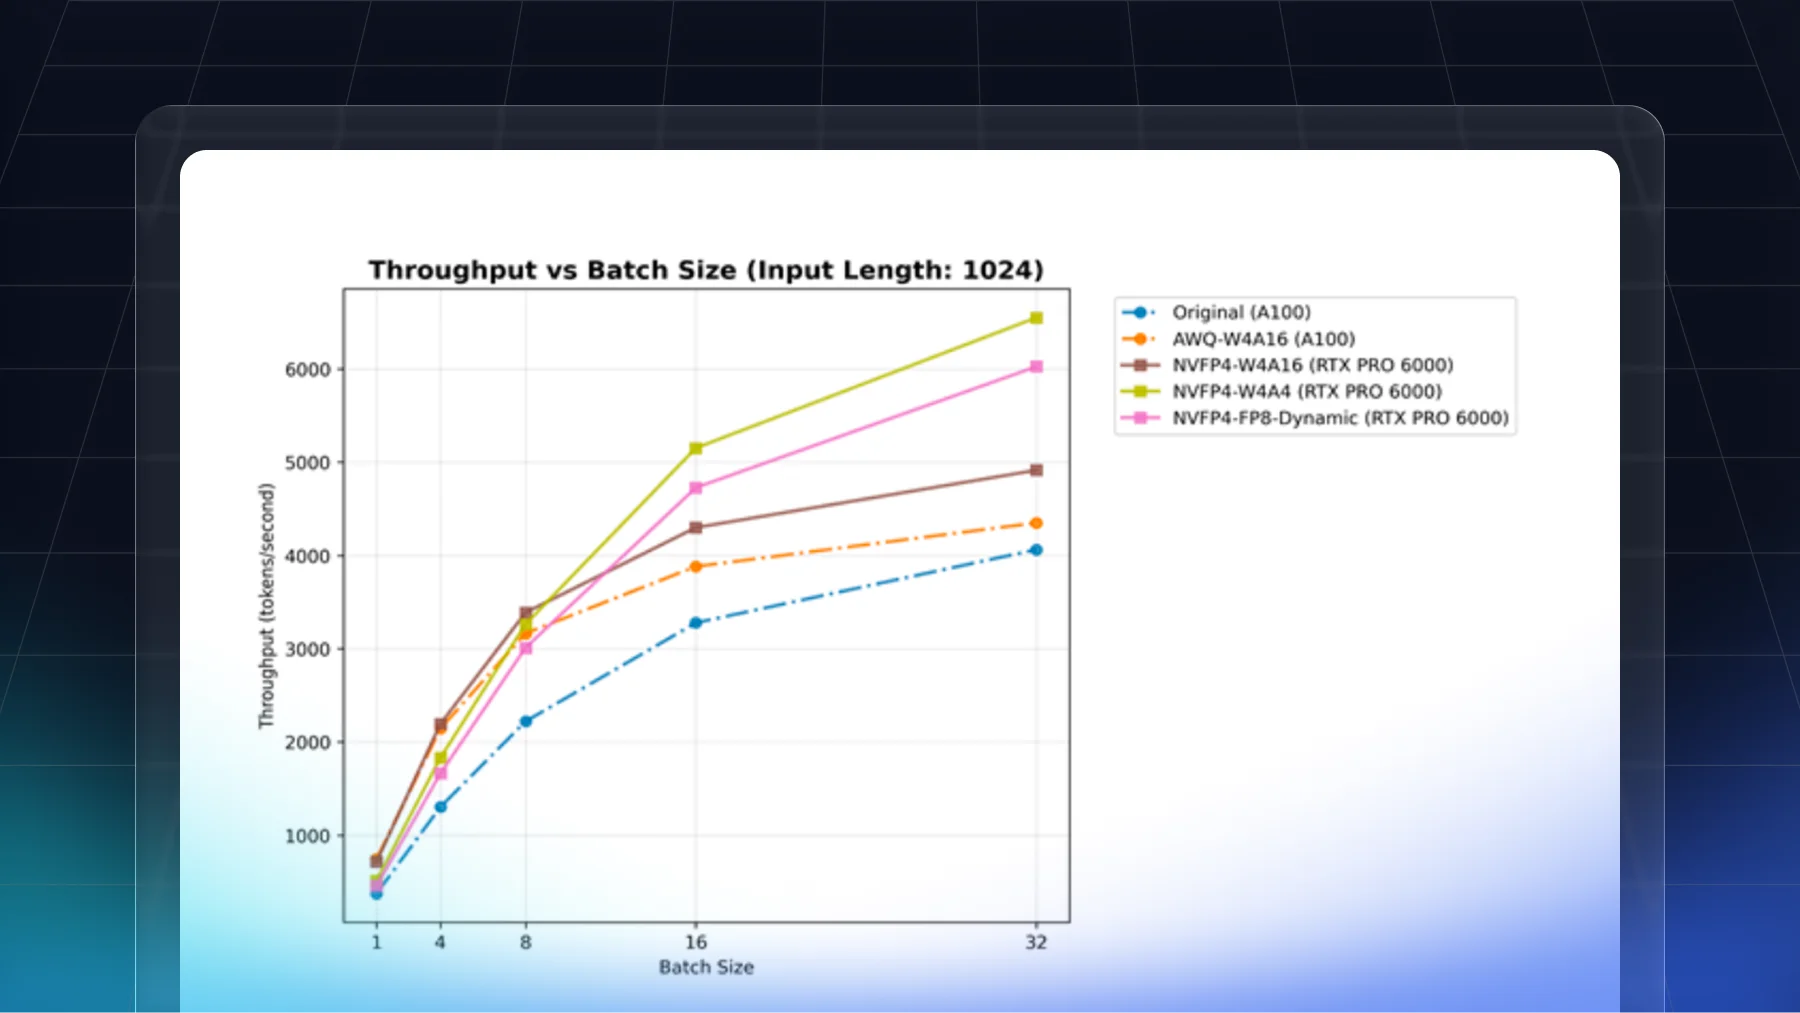
Blackwell용 NVFP4의 2단계 스케일링 구조와 LLM 추론 실측 결과를 분석했습니다. RTX PRO 6000에서 A100 대비 최대 2배 처리량과 미미한 정확도 차이를 확인했습니다.

vLLM의 PagedAttention과 Continuous Batching을 코드 흐름 중심으로 분석했습니다. KV 캐시 블록 관리, 스케줄링, CUDA 기반 Single Query Attention을 설명합니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.