
AI 테스트의 허수를 걸러내기
AI 테스트의 허수를 걸러내기
AI가 만든 테스트에서 검증 없이 통과하는 허수 패턴 8가지를 분석했습니다. 정규식, expect 집계, 장애 주입, 뮤테이션 테스트로 탐지 방법을 제시합니다.
#test#Playwright
7400
AI가 만든 테스트에서 검증 없이 통과하는 허수 패턴 8가지를 분석했습니다. 정규식, expect 집계, 장애 주입, 뮤테이션 테스트로 탐지 방법을 제시합니다.
Claude Code와 Playwright로 467개 웹 화면의 테스트 지도를 만들고 회귀 테스트 공백을 분석했습니다. 사람 검토와 고장 주입 검증을 거쳐 3.5일 동안 신규 테스트 114개를 추가했습니다.
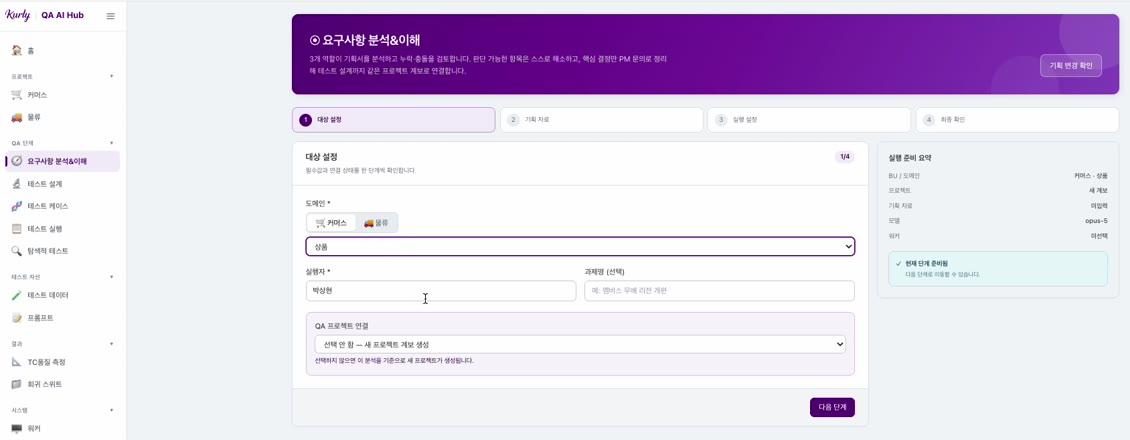
QA AI Hub로 기획서 분석부터 자연어 TC 실행, Jira 결함 등록까지 연결했습니다. 정답 TC·도메인 정책·이중 게이트로 생성 품질과 운영 신뢰도를 높였습니다.
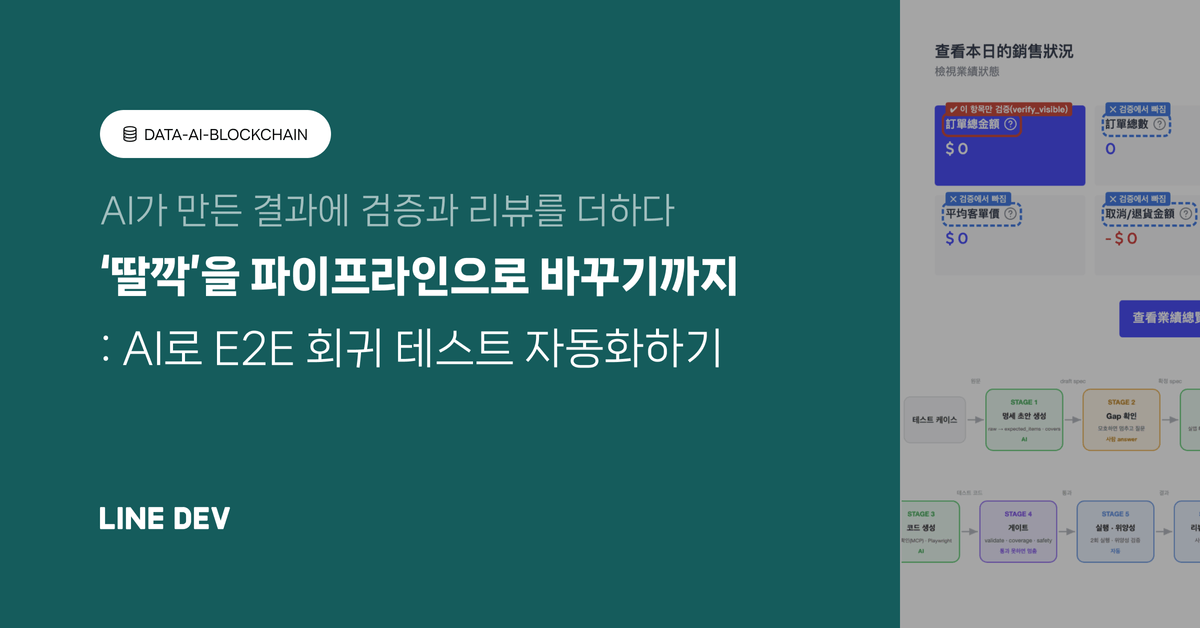
AI 생성 E2E 테스트의 위양성을 줄이기 위해 명세·게이트·변형 검증·리뷰 패킷 파이프라인을 구축했습니다. 수동 회귀 테스트 98개를 자동화하고 범위를 196개로 확대했습니다.
전시어드민의 사용자 행동 로그를 구축해 공통 컴포넌트와 개선 과제의 우선순위를 정했습니다. AI·MCP·Playwright로 분석과 QA를 자동화해 운영 효율과 검증 안정성을 높였습니다.
AI 코드 생성 확산에 맞춰 테스트와 운영 분석까지 자동화하는 AX 개발 흐름을 제안했습니다. 기존 테스트 도구와 AI를 연결해 운영 문제를 테스트로 환류하는 방식을 설명합니다.

AI 에이전트와 280건의 해외투어 QA 티켓을 재현·조사·기록 중심으로 처리한 방식을 공유했습니다. 원인 확정 전 수정 금지와 메모리·커밋 규칙으로 재작업을 줄였습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
무신사 Retail Platform QA팀의 회귀 테스트 자동화 여정을 다뤘습니다. Playwright, Slack 봇, AI 기반 TC 생성기로 테스트 시간을 크게 줄인 사례입니다.
외부 웹 변경에 취약한 할인 적용 배치를 LangGraph 기반 AI 에이전트로 복구·분석·PR 생성까지 자동화했습니다. LLM은 화면 판단에만 제한하고, 검증·권한·루프·동시성 제어는 코드와 사람 검토로 보완했습니다.
AI가 코드를 더 빨리 만들수록 검증이 병목이 된다고 설명했습니다. Playwright E2E와 에이전트를 조합해 결정론적인 자가개선 테스트 루프를 구축하는 방법을 소개했습니다.

AI 에이전트가 작성한 코드를 검증하기 위한 Playwright 기반 E2E 테스트 하네스 구축 사례를 공유했습니다. 에이전트가 테스트 작성과 수정까지 맡는 워크플로우를 소개했습니다.


AI가 만든 PR의 동작 검증을 E2E와 데모 녹화로 자동화해 리뷰의 초점을 설계 판단으로 옮겼습니다. 또한 반복 실행 가능한 Acceptance 인프라와 그 한계까지 함께 정리했습니다.

PR 리뷰의 첫 질문인 동작 확인을 E2E와 데모 녹화로 자동화했습니다. 그 결과 리뷰어가 설계와 구조 검증에 더 집중하도록 전환했습니다.
Issue 도메인을 독립 실행 가능한 standalone-app으로 조립해 핵심 로직만 빠르게 검증하는 구조를 소개했습니다. 프로덕션 Adapter만 교체하고 시드 데이터, Swagger, React 프론트엔드를 묶어 AI 협업 검증 환경을 만들었습니다.