

산업용 IoT의 표준, MQTT
산업용 IoT에서 MQTT의 Publish/Subscribe 구조와 QoS, Topic 기반 관리 방식을 소개했습니다. 제한된 네트워크 환경에서도 확장성과 실시간성을 확보하는 활용 포인트를 정리했습니다.
#MQTT#IoT
4600
산업용 IoT에서 MQTT의 Publish/Subscribe 구조와 QoS, Topic 기반 관리 방식을 소개했습니다. 제한된 네트워크 환경에서도 확장성과 실시간성을 확보하는 활용 포인트를 정리했습니다.
에이아이트릭스가 2년 연속 코리아 AI 스타트업 100에 선정됐습니다. 병원 응급상황 조기 예측 솔루션을 바탕으로 헬스케어 AI 성장을 이어가고 있습니다.
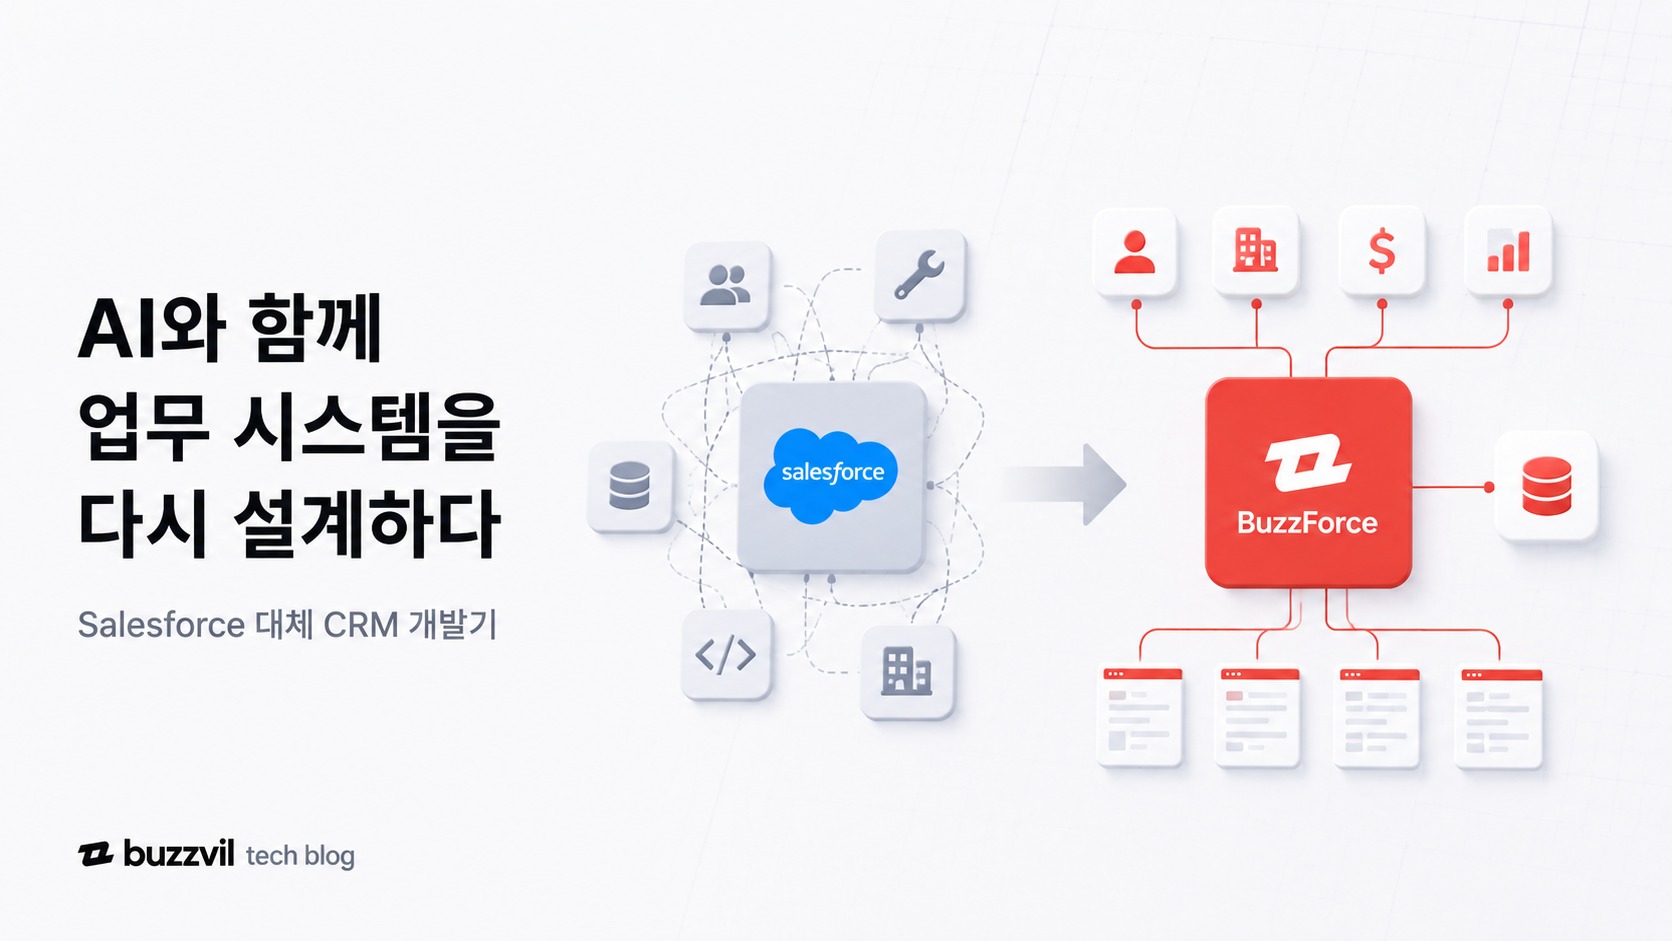
Salesforce의 연동·정합성 병목을 해결하기 위해 AI와 사용자 인터뷰를 결합해 자체 CRM을 개발했습니다. 관계형 데이터 모델과 유스케이스 중심 화면으로 업무 전환과 정산 효율화를 추진했습니다.

GA 매니저가 AI와 함께 사내 인사·회의실 정보를 모아 조회 시스템을 만들었습니다. 반복 문의를 줄이고 보안을 고려한 슬랙·캘린더 연동 방식도 정리했습니다.
AI에게 기능만 요청하면 조건문이 늘어나기 쉽다고 설명했습니다. 개념을 1급 시민으로 다루게 해야 설계와 운영까지 연결된다고 말했습니다.


terraform plan만으로는 인프라의 실제 동작을 확인할 수 없다는 문제를 다뤘습니다. 로컬 클러스터 검증과 재현 가능한 선언으로 apply 전 신뢰도를 높이는 방법을 소개했습니다.


사내 ERP 회계 데이터를 활용해 Agentic AI 프로토타입을 구축한 과정을 정리했습니다. Strands Agents SDK와 Kiro로 역할 분리, Context 관리, 데이터 추출과 후속 작업 연결을 검증했습니다.

실제 운영 데이터로 Iceberg와 Hive를 비교해 비용과 속도 차이를 검증했습니다. 큰 테이블부터 옮기고 SQL 패턴을 바꿔야 효과가 커졌습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

OpenSearch 3.3과 derived source로 미리캔버스 검색의 stored fields 병목과 세그먼트 병합 문제를 해결했습니다. 신규 클러스터 도메인 스위칭으로 무중단 전환하고 레이턴시와 IOPS를 크게 개선했습니다.

미리캔버스는 OpenSearch에서 시맨틱 벡터와 비주얼 벡터를 함께 쓰는 듀얼 벡터 검색을 도입했습니다. BM25 선필터와 메모리 최적화 인스턴스 전환으로 성능과 정확도를 함께 개선했습니다.
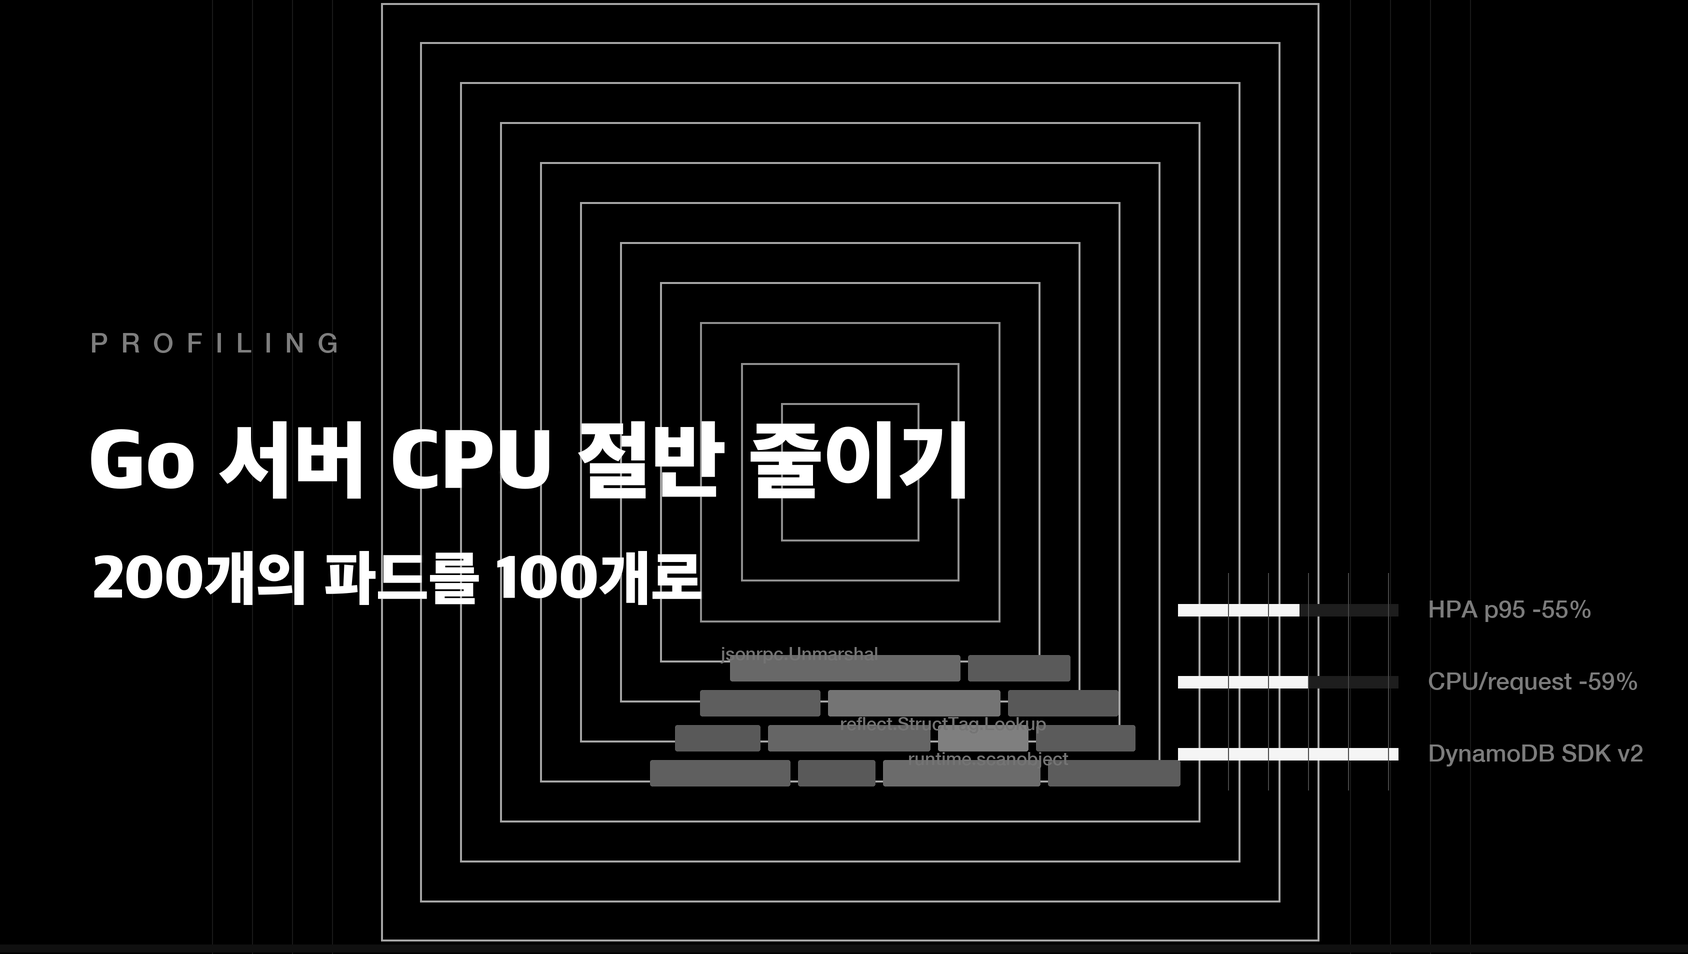
Pyroscope로 DynamoDB 응답 역직렬화의 CPU 병목을 확인하고 AWS SDK v2 기반 래퍼로 전환했습니다. 요청당 CPU를 59% 줄여 피크 타임 HPA 파드를 245개에서 109개로 낮췄습니다.
RTZR STT API 전사 결과와 문단 임베딩으로 자동 챕터·타임스탬프 생성 과정을 소개했습니다. C99 기반 문맥 변화 탐지와 명사 키워드로 대표 발화를 선택했습니다.
AI를 개인 생산성 도구가 아니라 조직의 공통 지식 기반으로 확장하는 방법을 설명했습니다. 서비스 설계도와 코드, 데이터, 정책을 연결해 문제정의와 유지보수 속도를 높이는 사례를 소개했습니다.
DynamoDB managed GSI의 핫 파티션을 피하기 위해 인덱스 테이블 분리와 전파 파이프라인 구현 과정을 다뤘습니다. 운영 중에는 버스트 제어와 SQS 적체를 조정해 안정적으로 변경분을 반영했습니다.