


Amazon Bedrock과 Amazon Neptune으로 지식 그래프를 활용한 GraphRAG 애플리케이션 구축하기
Amazon Bedrock과 Amazon Neptune으로 GraphRAG 애플리케이션을 구축하는 방법을 소개했습니다. LlamaIndex와 NL2GraphQuery를 활용해 지식 그래프 검색과 개인화 추천을 연결했습니다.
#GraphRAG#Amazon Bedrock
5700
Amazon Bedrock과 Amazon Neptune으로 GraphRAG 애플리케이션을 구축하는 방법을 소개했습니다. LlamaIndex와 NL2GraphQuery를 활용해 지식 그래프 검색과 개인화 추천을 연결했습니다.

SK하이닉스가 AWS 환경에서 RAG 플랫폼을 구축하고 성능을 평가한 사례를 소개했습니다. 데이터셋 크기와 인덱스 메모리가 검색 지연과 TTFT에 미치는 영향을 분석했습니다.


자동차 매뉴얼 검색을 위한 도메인 특화 RAG 데모 시스템을 개발했습니다. LLM과 메타 정보를 결합해 출처가 보이는 응답과 더 나은 사용자 경험을 제공했습니다.

AOP와 Redis로 실시간 에러 알림 시스템을 구축한 사례를 다루었습니다. 기존 배치 기반 알림의 한계를 줄이고 장애 대응성과 중복 알림 제어를 개선했습니다.

HWP 포맷의 내부 구조와 문서 정보 저장 방식을 살펴보았습니다. File Header와 DocInfo, BodyText 등 주요 스트림의 역할도 함께 설명했습니다.

전용 코디네이터 노드를 통해 OpenSearch에서 조정 작업과 데이터 처리를 분리하는 방법을 설명했습니다. 색인·검색 성능 향상과 VPC IP 절감, 운영 지표 점검 방법도 함께 정리했습니다.
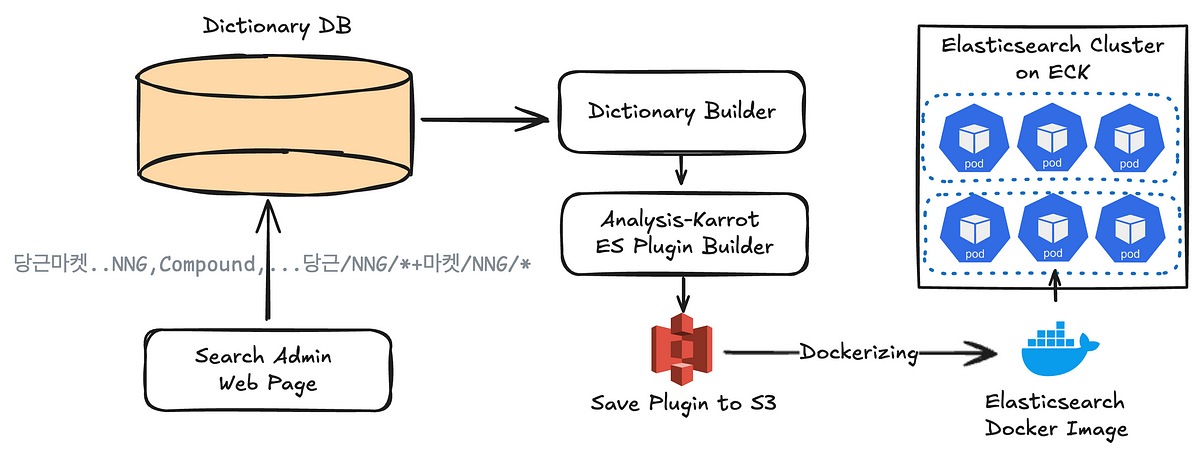
검색 형태소 분석 사전의 배포 과정을 Elasticsearch 재배포 없이 바꾸려는 개선 과정을 다뤘습니다. 메모리 증가 문제를 겪은 뒤 경량화와 버전별 사전 관리로 운영 가능성을 확보했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
Exposed와 MySQL 조합에서 발생한 SQLSyntaxErrorException의 원인을 단계적으로 추적했습니다. 임시 해결책보다 근본 원인을 찾는 디버깅 접근을 다뤘습니다.
SRE 관점에서 SLI, SLO, SLA의 차이와 필요성을 설명하고 사용자 여정 기반으로 신뢰성을 정량화하는 방법을 소개했습니다. 또한 오류 예산을 활용해 안정성과 개발 속도를 함께 관리하는 운영 방향을 정리했습니다.
AWX를 활용해 배포 자동화 툴을 구축한 사례와 구성 요소를 정리했습니다. 또한 Kubernetes 연동, 무중단 배포, 운영 시 고려사항까지 함께 살펴봤습니다.

프론트엔드 테스팅을 위해 Cypress 기반 E2E 테스트를 도입한 과정을 소개했습니다. 테스트 자동화 시작을 위한 실무 적용 사례를 다뤘습니다.

리브랜딩 후 사용자에게 오류처럼 보이던 UI icon을 폰트 기반 디자인과 명확한 가이드로 개선했습니다. 그 결과 VOC가 감소하고 아이콘 제작 리소스도 크게 줄었습니다.

LLM 파인튜닝에서 Optimizer, 학습률, 스케줄러, Warmup, 정밀도 선택 기준을 실험 결과로 정리했습니다.메모리와 안정성을 함께 고려해 AdamW 계열과 BF16, 1e-4 근처 학습률을 중심으로 검증하는 방법을 제시했습니다.

Amazon ElastiCache가 Valkey 8.0을 지원하며 더 빠른 스케일링과 개선된 메모리 효율을 제공했습니다. 서버리스 확장 속도와 노드 기반 클러스터의 메모리 사용량이 모두 개선되었습니다.