
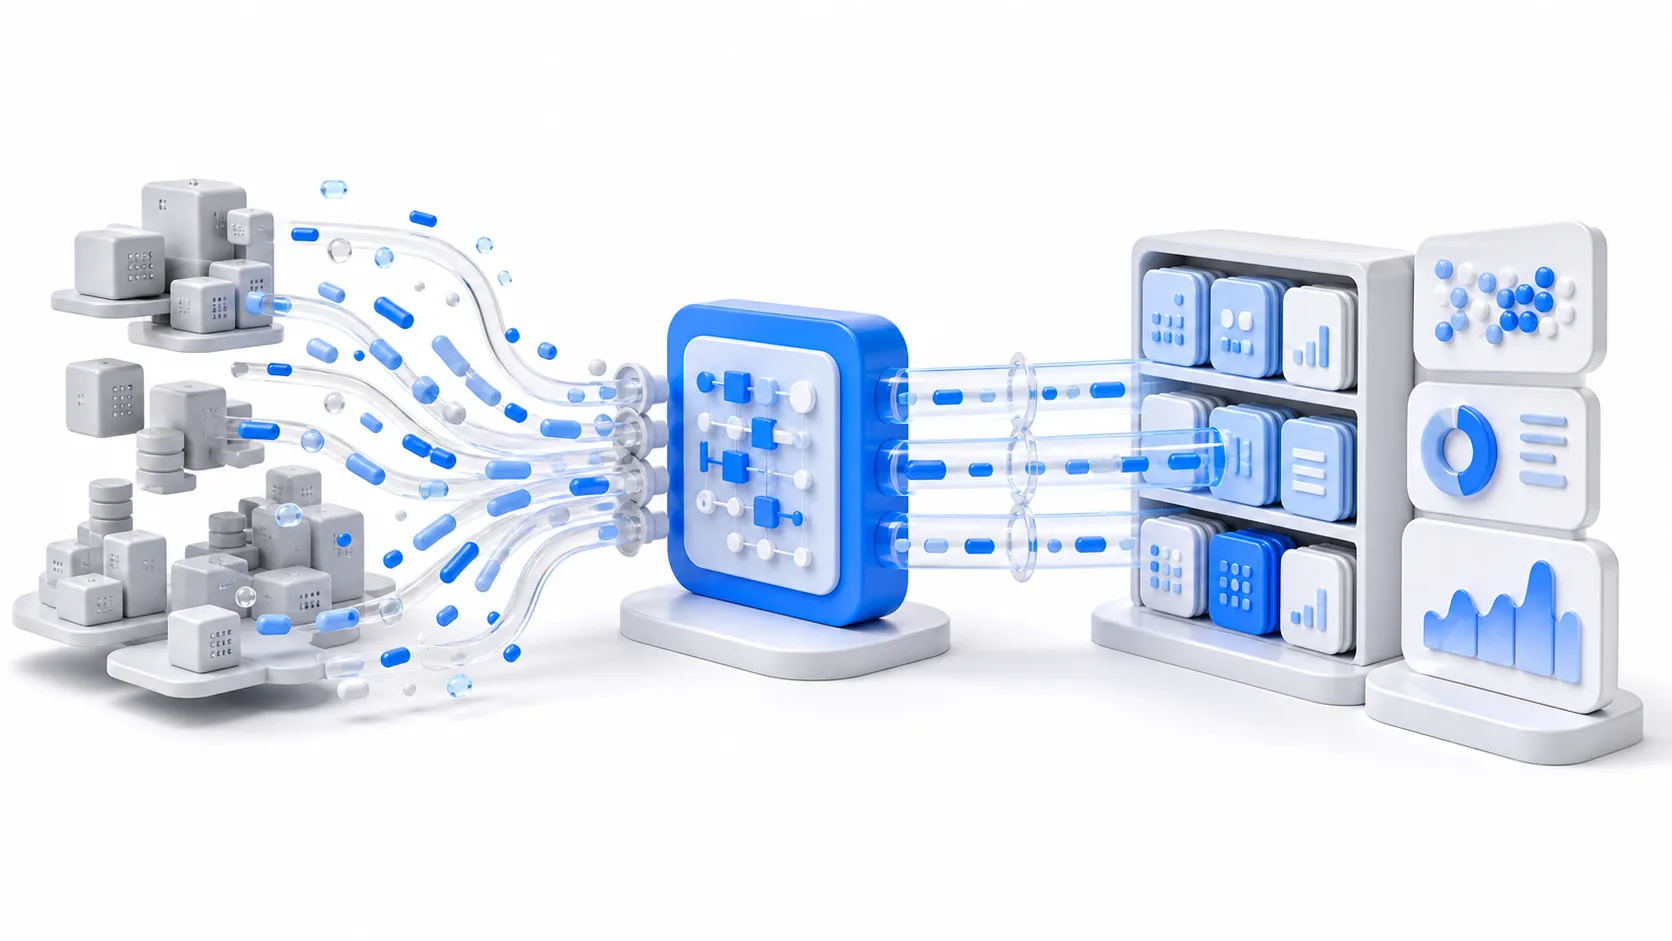
로그 파이프라인 개선기 - 기존 파이프라인 문제 정의 및 해결 방안 적용
MSK와 커스텀 Consumer로 로그 파이프라인을 스트리밍 구조로 전환했습니다. 데이터 컨트랙트로 스키마를 통합 관리하고 신선도를 약 3분으로 단축했습니다.
#Kafka#MSK
200
MSK와 커스텀 Consumer로 로그 파이프라인을 스트리밍 구조로 전환했습니다. 데이터 컨트랙트로 스키마를 통합 관리하고 신선도를 약 3분으로 단축했습니다.
기존 로그 배치 파이프라인의 분류 비효율, 낮은 신선도, 스키마 관리 부재를 정리하고 개선 방향을 설명했습니다. MSK와 Kafka Consumer, Protobuf, Schema Registry를 활용한 준실시간 구조로 전환한 과정을 소개했습니다.


여기어때의 사내 동호회 문화를 운영자와 참여자 인터뷰로 소개했습니다. 취미를 통해 동료와의 관계를 넓히고 새로운 즐거움을 찾는 경험을 담았습니다.
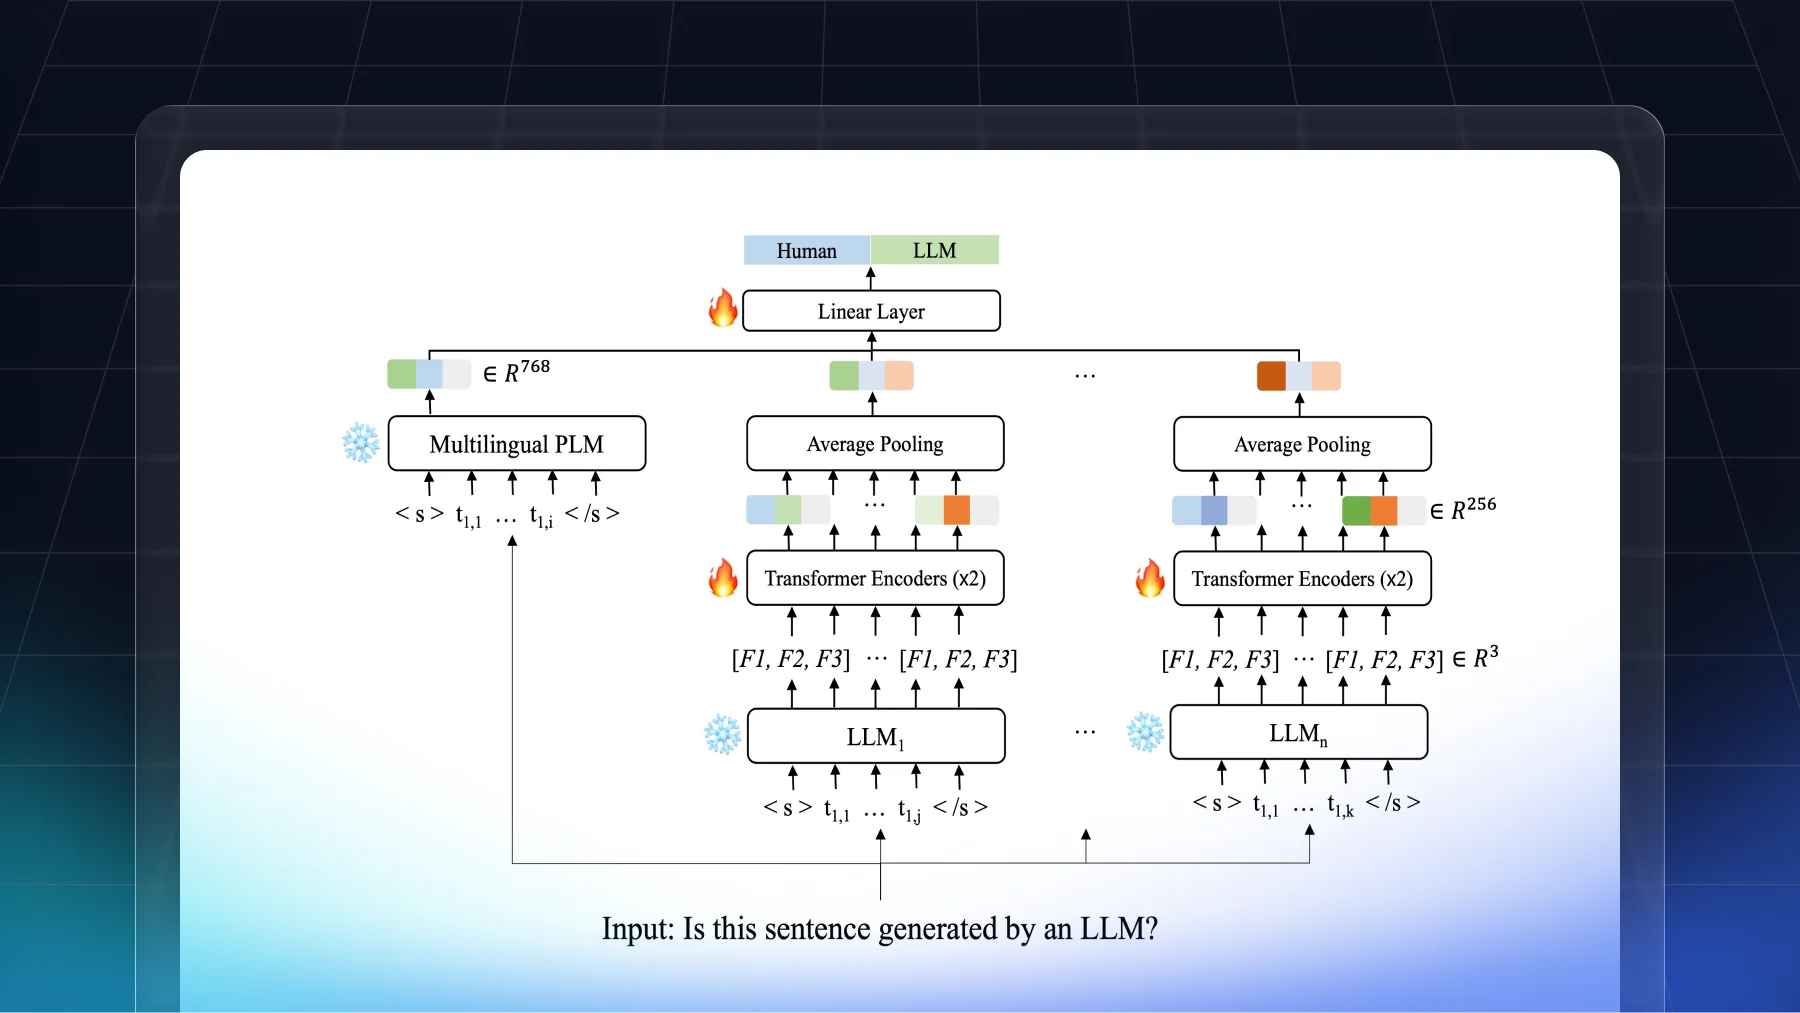
미학습 언어에서 성능이 떨어지는 다국어 LLM 생성 텍스트 탐지 문제를 다뤘습니다. 토큰 확률 분포와 의미 임베딩을 결합해 경진대회 3위를 기록했습니다.
Redis 분산 락과 스프링 AOP로 입하 확정 처리 API의 동시성 이슈를 해결했습니다. 또한 @Transactional과의 실행 순서 문제와 커넥션 사용 이슈를 @Order로 정리했습니다.


JUnit5 Vintage 엔진에 클래스 단위 병렬 실행을 도입한 과정을 설명했습니다. ForkJoinPool 대신 fixed thread pool과 CompletableFuture를 사용해 5.12 버전에 반영했습니다.

배달의민족은 GPT와 RAG를 활용해 상품 카탈로그 속성값 생성 자동화를 시도했습니다. 평가 모델을 보완해 작업 효율을 높이고 정확도도 개선했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
SmartThings 기록 시스템의 DB를 HBase에서 OpenSearch로 교체한 사례를 소개했습니다. 성능 개선과 비용 절감을 목표로 전환을 진행했습니다.
인도 디지털 대출 시장의 성장 배경과 핵심 동인을 정리했습니다. 부실 대출 리스크와 규제 변화 속에서도 투자 기회가 크다고 보았습니다.

Cursor의 Rules 기능으로 iOS 개발용 AI 동작을 프로젝트 단위로 제어하는 방법을 소개했습니다. 규칙을 적용한 뒤 오류와 중복 작업이 줄어든 경험도 공유했습니다.

광고 수익화에서는 리텐션과 LTV를 함께 봐야 한다는 점을 설명했습니다. 광고 실험의 효과를 수익뿐 아니라 사용자 유지와 획득 효율까지 연결해 해석하는 방법을 다뤘습니다.
Kafka 소비 시 JSON 역직렬화 설정이 왜 기대대로 동작하지 않는지 과정을 따라가며 분석했습니다. 헤더 타입 정보와 타입 매핑, trusted packages, target type 우선순위를 조정해 해결했습니다.

파트너센터 개선 과제에서 데이터 정합성과 회귀 테스트 중심의 검증 과정을 소개했습니다. Postman과 브라우저스택을 활용해 화면 값 차이와 기기별 이슈를 확인한 사례를 정리했습니다.

피그마 디자인을 React 컴포넌트로 바로 변환하는 플러그인 구현 과정을 소개했습니다. 사내 규칙을 반영한 자동화로 수작업을 줄이고 생산성을 높인 사례입니다.