
백엔드
Kafka Connect로 DB 데이터 쉽게 연동하기

두줄요약
Kafka Connect와 JDBC Source Connector로 DB 데이터를 Kafka에 연동하는 구조와 증분 쿼리 모드를 설명했습니다.\n쿼리 기반 CDC의 누락 사례와 지연 옵션을 통한 완화 방법을 정리했습니다.
구조와 흐름
- Kafka Connect의 Worker·Connector·Task 기반 데이터 파이프라인과 thread 단위 Task 처리
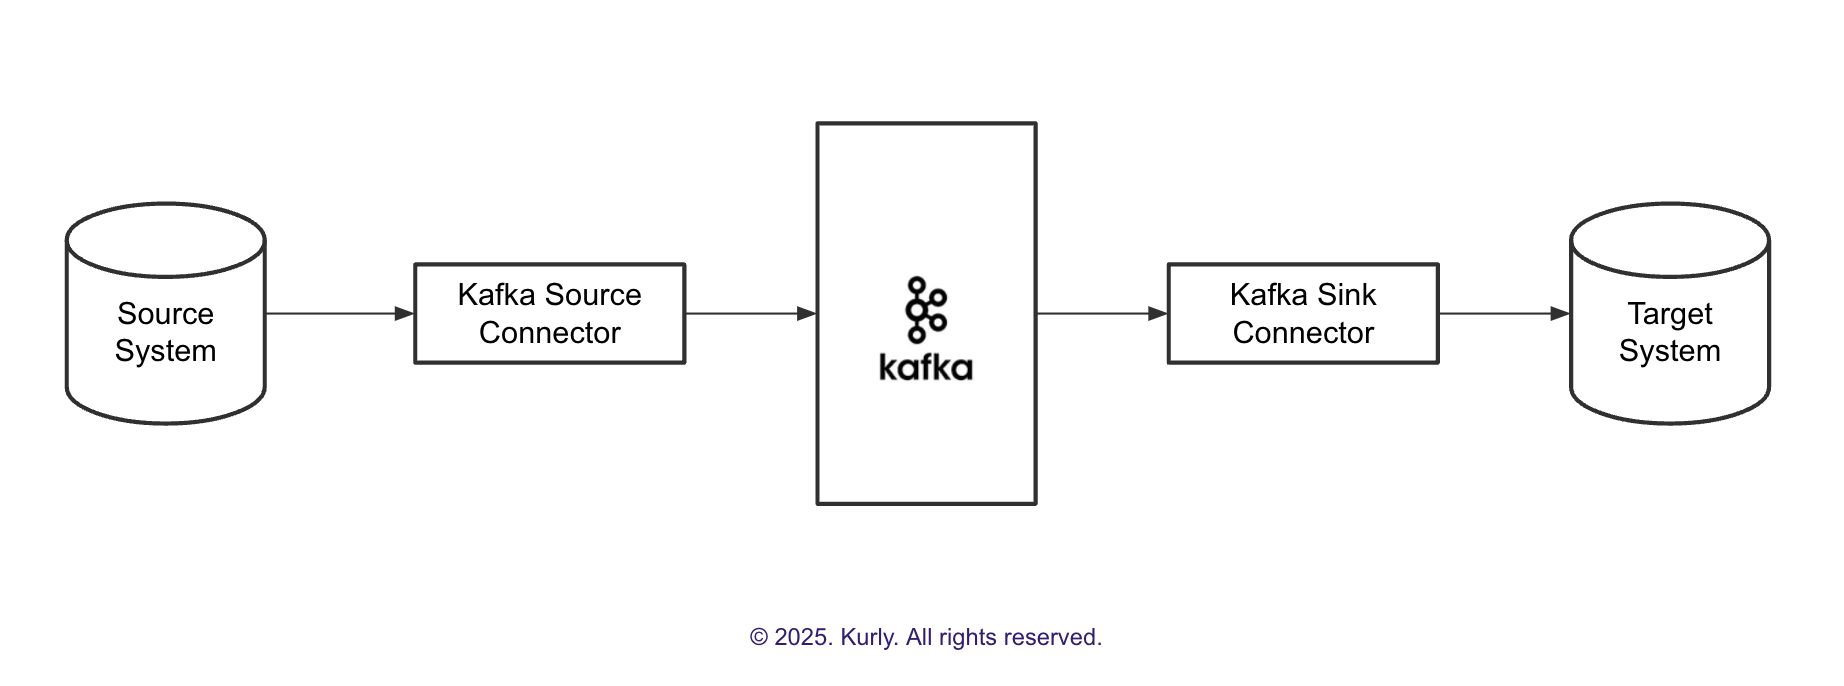
- Source Connector의 DB→Kafka 적재, Sink Connector의 Kafka→타겟 DB 적재 구조
- SMT의 메시지 내용 변환과 Converter의 JSON·Avro 포맷 변환 분리
선택 이유
- JSON 설정만으로 구성하는 반복적 데이터 연동 파이프라인
- JDBC Source Connector의 Bulk·Custom Query·증분 쿼리 모드 지원
- DB 설정 변경이 어려운 환경에서 테이블 읽기 권한만으로 적용 가능한 쿼리 기반 CDC
트레이드오프
- 로그 기반 CDC의 짧은 지연·높은 변경 충실도 대비 복잡한 권한·로그 분석 설정
- 쿼리 기반 CDC의 이식성·낮은 구축 비용 대비 폴링 지연과 변경 이벤트 누락 가능성
- 삽입 위주 로그성 테이블 또는 최신 상태만 필요한 데이터에 적합한 JDBC Source Connector
주의할 점
- 증분 모드의 PK 또는 timestamp 컬럼 의존성과 delete·update 감지 한계
- 폴링 사이 다중 변경, 긴 트랜잭션·지연 적재에 따른 timestamp 순서 역전 및 누락 위험
- timestamp.delay.interval.ms를 통한 누락 완화와 적재 지연 증가 간 균형

