
데브옵스
로그 파이프라인 개선기 - 기존 파이프라인 문제 정의 및 해결 방안 적용
두줄요약
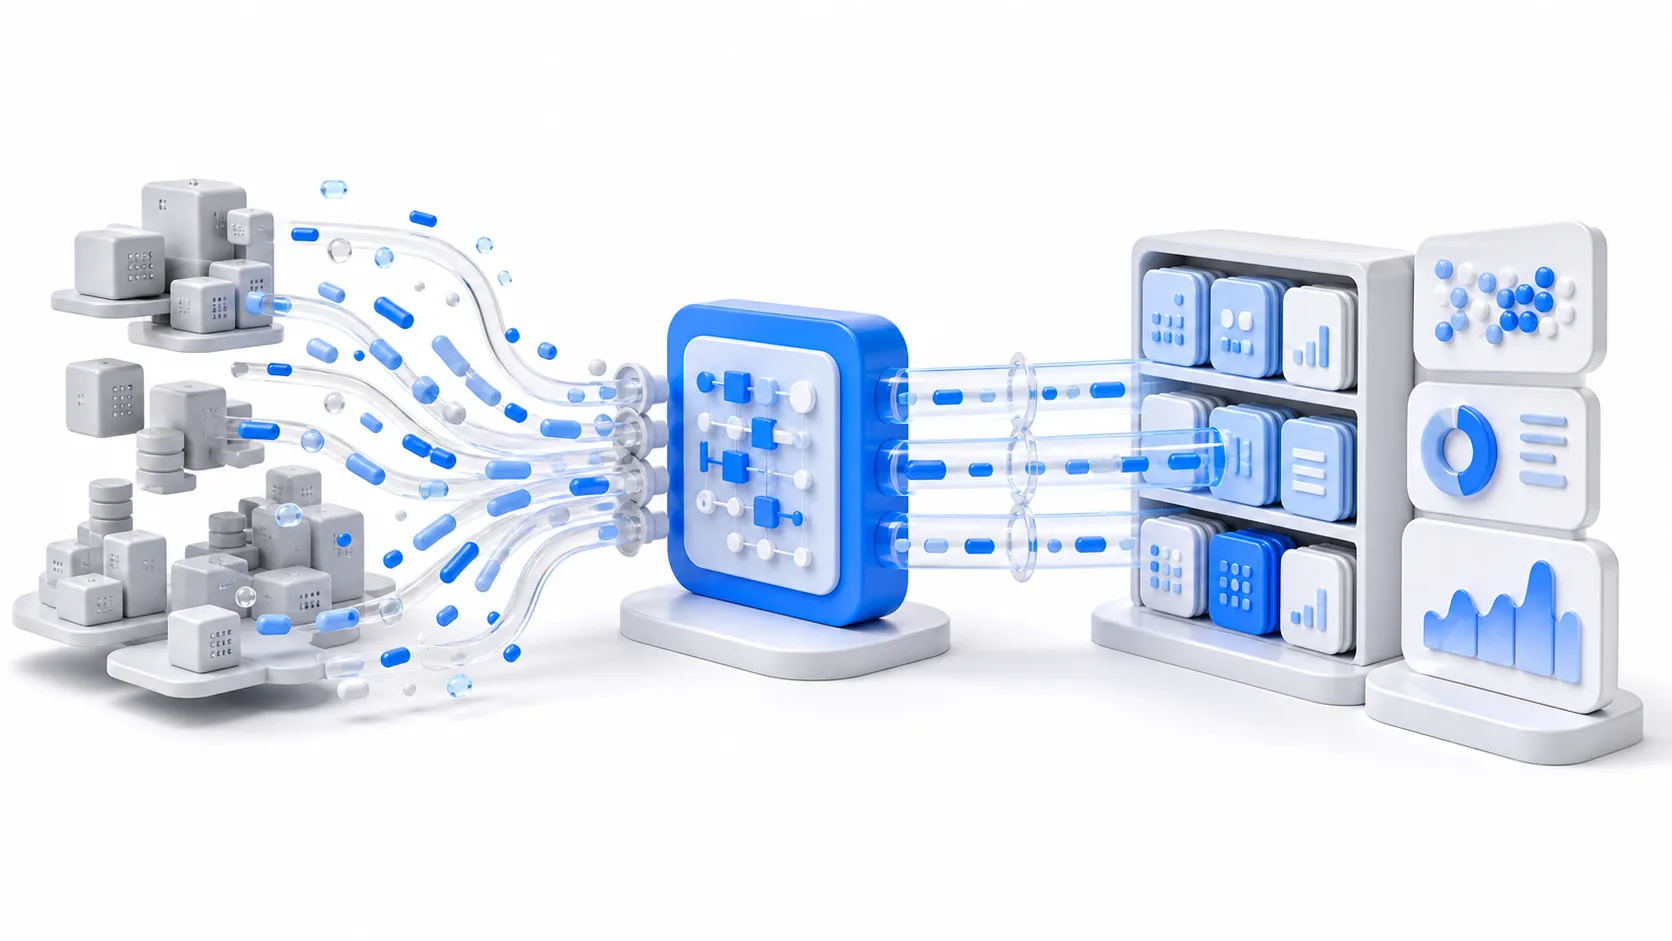
MSK와 커스텀 Consumer로 로그 파이프라인을 스트리밍 구조로 전환했습니다. 데이터 컨트랙트로 스키마를 통합 관리하고 신선도를 약 3분으로 단축했습니다.
문제 상황
- S3→GCS 분류 과정의 전체 로그 처리와 중복 저장으로 인한 비효율 및 단일 장애 지점
- Airflow 배치 처리로 인한 1~2시간 수준의 데이터 신선도
- 공통 스키마 저장소 부재와 수동 BigQuery 스키마 변경에 따른 유지보수 병목
해결 방법
- KDS·Firehose·Airflow 중심 구조를 MSK와 커스텀 Python Consumer 기반 스트리밍 구조로 전환
- Consumer에서 타입별 선별·가공·파티셔닝 후 GCS 단일 원천 저장소에 적재
- Protobuf, Buf, Schema Registry와 PR 리뷰·GitHub Actions 검증을 통한 데이터 컨트랙트 도입
구조와 흐름
- Producer의 Protobuf 직렬화 메시지를 MSK로 전송하고 Consumer가 역직렬화·분류·DLQ 처리
- GCS 외부 테이블과 일 배치 내부 테이블을 BigQuery View로 결합한 준실시간 조회 구조
- 타입·시간 등 복수 필드 기반 파티셔닝과 버퍼·적재 대상 설정을 지원하는 범용 Consumer
성능/운영 포인트
- 데이터 신선도 1~2시간에서 약 3분 수준으로 단축
- External Table 성능 한계를 일 배치 내부 테이블 적재로 보완
- Python ProtobufDeserializer의 Writer/Reader Schema 교차 검증 부재와 모니터링·알림 강화 과제

