
데브옵스
Prometheus 모니터링 실무 적용기 1탄

두줄요약
Kubernetes와 기존 시스템을 통합 모니터링하기 위해 Prometheus와 Grafana를 도입했습니다. 데이터 보관 주기와 Persistent Volume 정책을 조정해 운영상 데이터 유실을 방지했습니다.
문제 상황
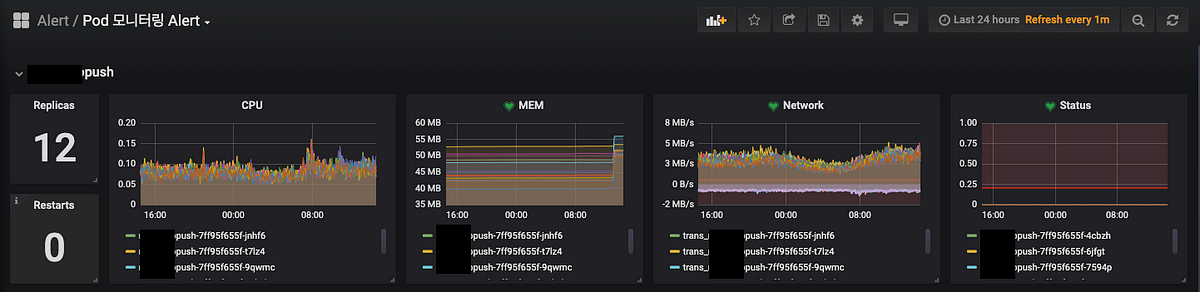
- Kubernetes 기반 차세대 거래 엔진과 기존 시스템을 아우르는 통합 모니터링 필요
- 베어메탈·클라우드·컨테이너 환경의 상태 파악과 장애 대비를 위한 추이 분석 요구
선택 이유
- Kubernetes 모니터링의 사실상 표준인 Prometheus와 Helm 기반 간편 설치
- OS 및 서드파티 exporter를 통한 다양한 플랫폼 메트릭 수집 가능성
- 시계열 저장소, pull 수집 방식, Grafana 연동을 통한 대시보드 구성 용이성
성능/운영 포인트
- AWS m5.2xlarge 환경에서 약 280개 Pod와 1분 수집 주기 운영 시 큰 리소스·데이터 증가 부담 미확인
- 메트릭 축적을 통한 리소스 사용량 분석, 임계치 설정, 이상 징후 탐지 활용
주의할 점
- 기본 데이터 보관 주기 15일로 인한 오래된 메트릭 자동 삭제
- Helm 재설치 시 Persistent Volume 삭제로 데이터 유실 경험
- Reclaim Policy를 Retain으로 변경해 Helm chart 삭제 후에도 볼륨 유지


