AI
LLM Agent란 무엇이고, 언제 필요한가? RAG와 비교하고 직접 구현해보기

두줄요약
문서 질문에는 RAG가 충분하고 DB 조회·계산이 필요한 질문에는 Agent가 높은 정확도를 보였습니다. 다만 복합 질문의 오류와 비용 증가를 고려해 권한 통제와 도구 호출 기록 검증이 필요합니다.
구조와 흐름
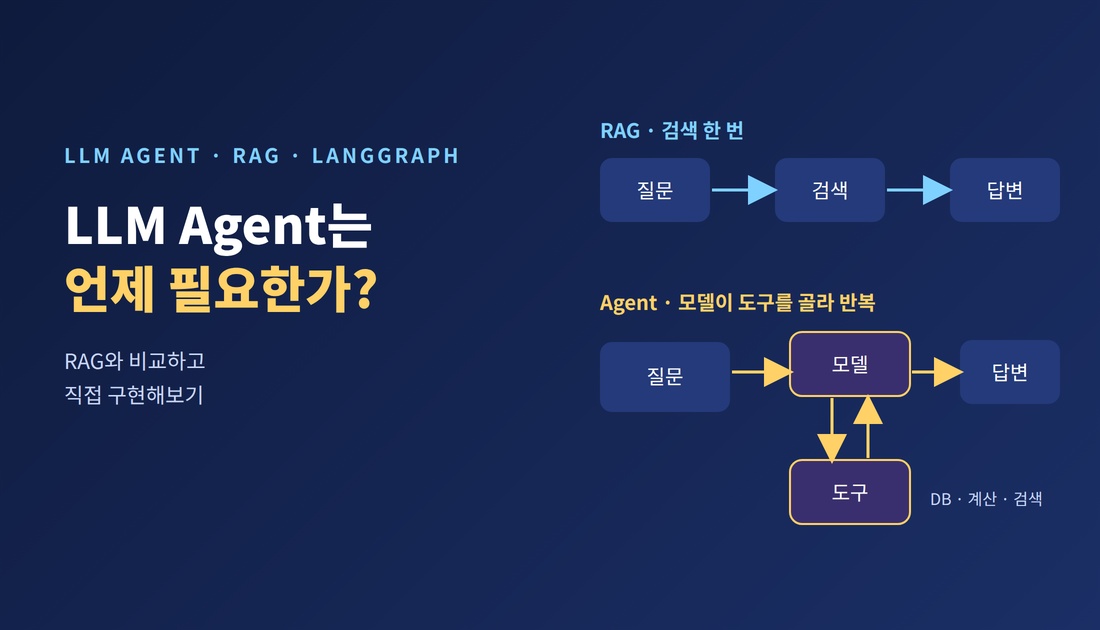
- RAG-only의 고정 검색 워크플로우와 모델이 검색·DB 조회·계산 도구 순서를 선택하는 Agent 루프 비교
- tool_calls 실행 결과를 role: tool 메시지로 누적하고, 최대 6단계로 루프 제한
- 규정 검색, 연차 DB 조회, 영업일 계산을 결합한 사내 HR 챗봇 실험 구성
성능/운영 포인트
- 30문항 기준 Agent 80%(24/30), RAG-only 43%(13/30)의 엄격 정확도
- 문서형 질문은 RAG-only 9/10, Agent 10/10으로 유사하지만 도구형 질문은 Agent 10/10, RAG-only 2/10
- Agent 평균 1,425토큰·3.50초, RAG-only 평균 458토큰·1.38초로 비용과 응답 시간 증가
주의할 점
- 복합 질문에서 Agent도 4/10에 그치며, 검색 누락·날짜 조건 추론 오류·근거 없는 숫자 생성 발생
- 직원 ID 같은 권한 파라미터를 모델 입력에서 제거하고 서버가 로그인 사용자 ID를 고정하는 방식
- 답변뿐 아니라 Tool 호출 기록 점검, 출처 표시, 복합 질문의 사람 확인 경로 필요
적용해볼 점
- 답이 문서에만 있으면 RAG부터 적용하고, DB·계산·외부 시스템 조회가 필요한 질문에 Agent 검토
- 문자열 일치, LLM Judge, 체크리스트 Judge를 병행해 평가 방식의 오판 점검
- LangGraph 전환과 안전망 추가만으로 정확도 향상을 기대하지 않고, 무한 루프·예외·반복 호출 방지 용도로 활용