
AI가 내 하루를 기억하게 하는 법 (1/2): 먼저, 기억할 곳을 만들었다 — 개인 LLM 위키

AI가 내 하루를 기억하게 하는 법 (1/2): 먼저, 기억할 곳을 만들었다 — 개인 LLM 위키
AI가 개인의 하루와 업무 맥락을 기억하도록 하기 위해 개인 LLM 위키를 만든 사례를 다뤘습니다. 먼저 기억할 곳을 마련하는 과정을 중심으로 소개했습니다.
#LLM#위키
10400

AI가 개인의 하루와 업무 맥락을 기억하도록 하기 위해 개인 LLM 위키를 만든 사례를 다뤘습니다. 먼저 기억할 곳을 마련하는 과정을 중심으로 소개했습니다.

Amazon EKS의 GPU 한 장에서 Gemma 4 31B를 vLLM으로 서빙할 때의 처리량과 지연 SLO 최적화 결과를 정리했습니다. NVFP4, prefix caching, speculative decoding, priority 스케줄링의 효과와 서빙 풀 분리 기준을 제시했습니다.
스크럼에서 반복되던 유저스토리 작성과 점수 참고 과정을 줄이기 위해 AI 기능을 도입한 과정을 공유했습니다. 생성과 검색을 분리하고, 실제 사용 중 드러난 문제를 바탕으로 구조를 계속 조정했습니다.

코드 작성 직후와 종료 직전에 규칙을 다시 주입하는 Stylepack으로 Coding Agent의 컨벤션 준수를 높인 사례를 다뤘습니다. 반복 리뷰 코멘트를 규칙화하고, 모양으로 잡히는 문제와 런타임 문제를 나눠 대응했습니다.

AI 에이전트가 스스로 수정하려면 먼저 테스트 결과를 믿을 수 있어야 했습니다. 그래서 테스트 격리와 실행 경로 통일로 오염과 환경 차이를 줄였습니다.
여러 AWS 콘솔과 CLI를 오가던 인프라 확인 문제를 읽기 전용 포털로 풀었습니다. 단일 프롬프트 대신 역할형 AI 에이전트로 업무를 나누는 접근을 다뤘습니다.
if(kakao)2026 첫째 날의 기술 세션 주제와 구성을 소개했습니다. AI 방향성 세션에서 Kanana SLM 개발 노하우를 공유합니다.

GS리테일이 전사 AI Gateway 위에 운영·거버넌스 계층을 더해 실사용을 견디는 플랫폼으로 확장했습니다. 사용자 온보딩, 예산 라우팅, 가드레일, 감사, 외부 도구 연동까지 Gateway 안에서 통제했습니다.

Rerank와 Weight 튜닝을 OpenSearch 검색 품질에 적용해 본 결과를 정리했습니다. 데이터 특성과 기존 성능에 따라 개선과 악화가 갈리므로, 측정 기반의 지속 평가가 중요했습니다.

토스 프론트엔드 팀은 문서를 찾는 대신 문서가 개발자에게 찾아오게 만드는 시스템을 구축했습니다. RAG 챗봇과 자동 문서화 봇으로 지식의 축적과 검색을 연결했습니다.

LG에너지솔루션이 ERCOT 전력거래 분석을 위해 Bedrock AgentCore 기반 에이전트를 구축했습니다. 내부 데이터, 웹 검색, 규제를 분리한 MCP와 Guardrails, CloudWatch로 품질과 보안을 확보했습니다.

AI가 만든 코드를 어드민 화면으로 보여 주기 위해 브라우저 기반 Preview Runtime을 구축한 과정을 소개했습니다. 가상 파일 시스템, esbuild-wasm, import map, 패키지 사전 빌드로 격리성과 속도를 함께 해결했습니다.

범용 번역 도구의 용어 불일치, 보안 우려, 반복 수정 문제를 짚었습니다. 조직 맥락을 학습한 Private LLM 기반 번역 AI 에이전트를 제안했습니다.
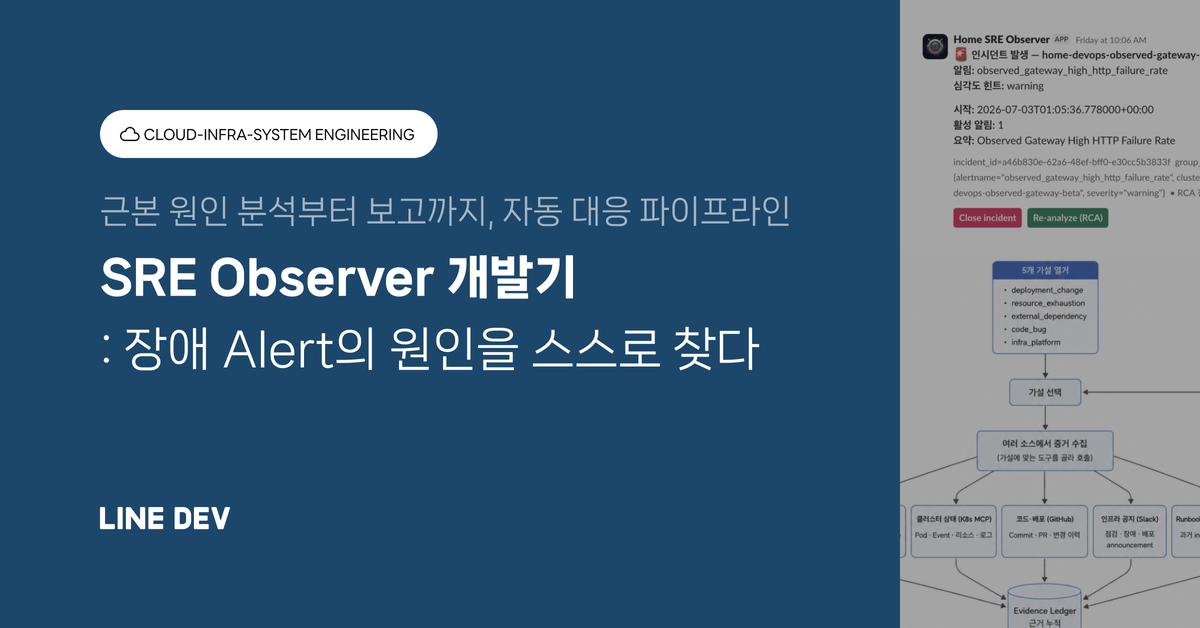
Alert를 자동으로 묶고 근본 원인까지 분석하는 SRE Observer 개발 과정을 소개했습니다. 근거 기반 가드레일과 승인 경계로 과신을 막고 대응 자동화를 설계했습니다.