
React Server Component와 Streaming으로 웹 성능 극대화하기: Next.js 실전 가이드
Next.js App Router에서 React Server Components와 Streaming을 활용해 데이터 패칭 패턴을 비교했습니다. loading.tsx와 Suspense, use 훅으로 체감 속도와 로딩 시간을 함께 개선하는 방법을 설명했습니다.
#React#Next.js#SSR
22100
Next.js App Router에서 React Server Components와 Streaming을 활용해 데이터 패칭 패턴을 비교했습니다. loading.tsx와 Suspense, use 훅으로 체감 속도와 로딩 시간을 함께 개선하는 방법을 설명했습니다.
Django REST Framework에서 django-modeltranslation으로 다국어 지원을 구현한 사례를 소개했습니다. DB 기반 번역 관리와 fallback 설정으로 유지 보수성과 사용자 경험을 높였습니다.

asyncio 없이 소켓과 selectors만으로 비동기 서버를 단계적으로 구현해보았습니다. 이를 통해 asyncio 이벤트 루프가 I/O 이벤트를 기다리고 처리하는 원리를 설명했습니다.
산타 세이의 브랜드 시각화 과정을 회고하며 음파를 기표로 선택한 과정을 정리했습니다. 패밀리 브랜드의 일관성과 서비스 고유성을 함께 담기 위한 조형 설계가 핵심이었습니다.
Santa SAY의 브랜드 정체성을 최소한으로 설계한 과정을 회고합니다. MVB 프로세스로 이해관계자 의견을 모으고, 산타와의 관계를 정리해 네이밍과 미션을 도출했습니다.
유튜브 퀴즈의 품질을 높이기 위해 좋은 질문의 기준을 세우고 라벨링 체계를 설계했습니다. 또한 전용 라벨링 툴과 QC 모델 학습 루프로 질문 생성 AI를 개선했습니다.
AI 교육 서비스의 챗봇 루미를 브랜딩하며 정서적 연결성과 친근한 아이덴티티를 설계했습니다. 캐릭터 대신 눈 기반 심볼과 로고로 차별화해 2주 만에 베타 런칭용 브랜드를 완성했습니다.

Quizium의 두 퀴즈 모드를 비교하며 학습 몰입도와 자유도를 검증했습니다. 유저 테스트에서 불편한 팝업 모드가 오히려 학습 효과 측면에서 더 선호되었습니다.

생성형 AI 제품은 일반 소프트웨어와 다른 개발 프로세스와 운영 지표가 필요했습니다. 비즈니스 목표와 모델 품질, 비용을 단계별로 연결해 관리하는 방법을 정리했습니다.
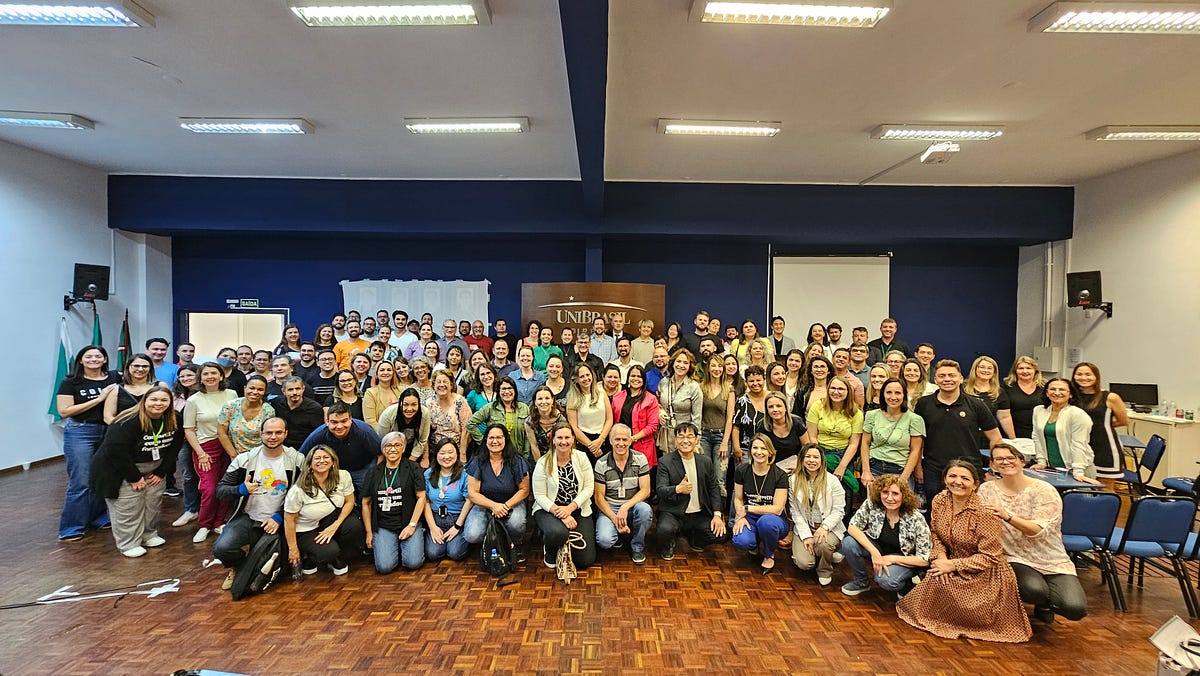
브라질 파라나주에서 Quizium을 100명의 교사들에게 소개하고 시연했습니다. 현지 피드백을 바탕으로 제품 개선과 글로벌 교육 혁신 방향을 점검했습니다.
INTERSPEECH 2023 참가와 포스터 발표 경험을 중심으로 음성 언어 처리 연구 동향을 정리했습니다. 데이터 부족, 음성 모델 활용, 벤치마크의 중요성을 다시 확인했습니다.

뤼이드 AI 뉴스레터 8월호는 EdSAFE AI Alliance 출범과 교육 AI의 신뢰·안전 기준 논의를 다뤘습니다. 에듀테크 수요와 AI 성능 측정 동향, 관련 논문·콘텐츠도 소개했습니다.
GNN 기반 GKT의 집계·업데이트·예측 구조와 그래프 구성 방식을 소개했습니다. 공개 데이터셋에서 DKT보다 높은 AUC와 학습 개념 관계의 해석 가능성을 확인했습니다.

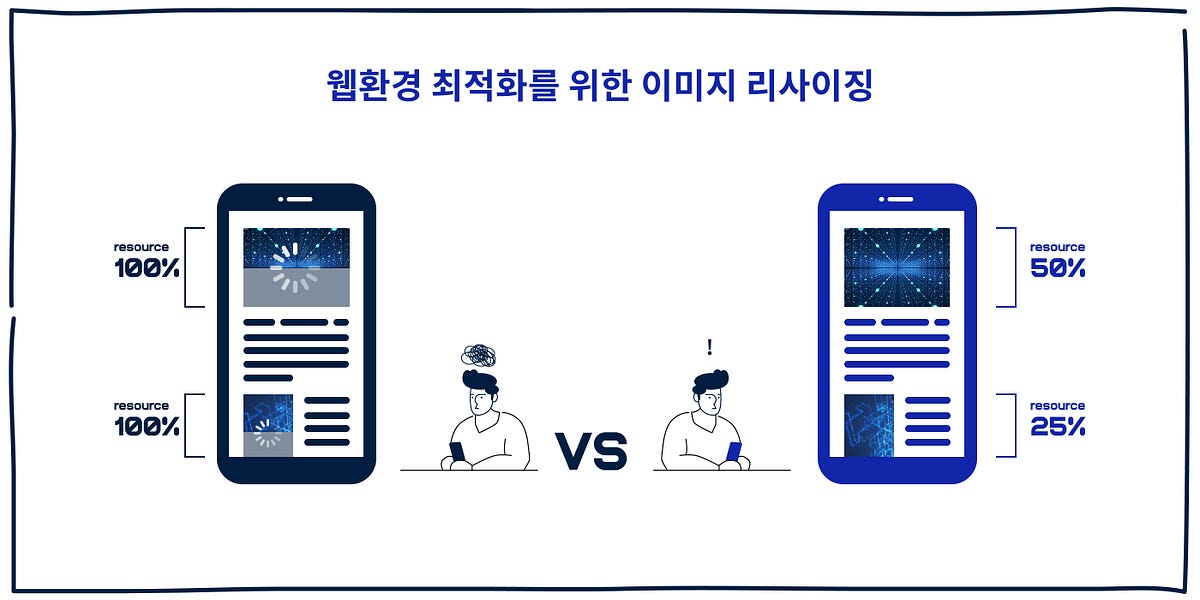
반응형 이미지의 srcSet·sizes 속성으로 기기와 레이아웃에 맞는 해상도를 제공합니다. 압축과 리사이징을 결합해 리소스 용량과 웹 성능을 개선했습니다.
ASU GSV Summit 참여 소식과 교육 AI 관련 연구 동향을 소개했습니다. AI 확산 원칙과 지식추적 알고리즘 연구도 함께 다뤘습니다.

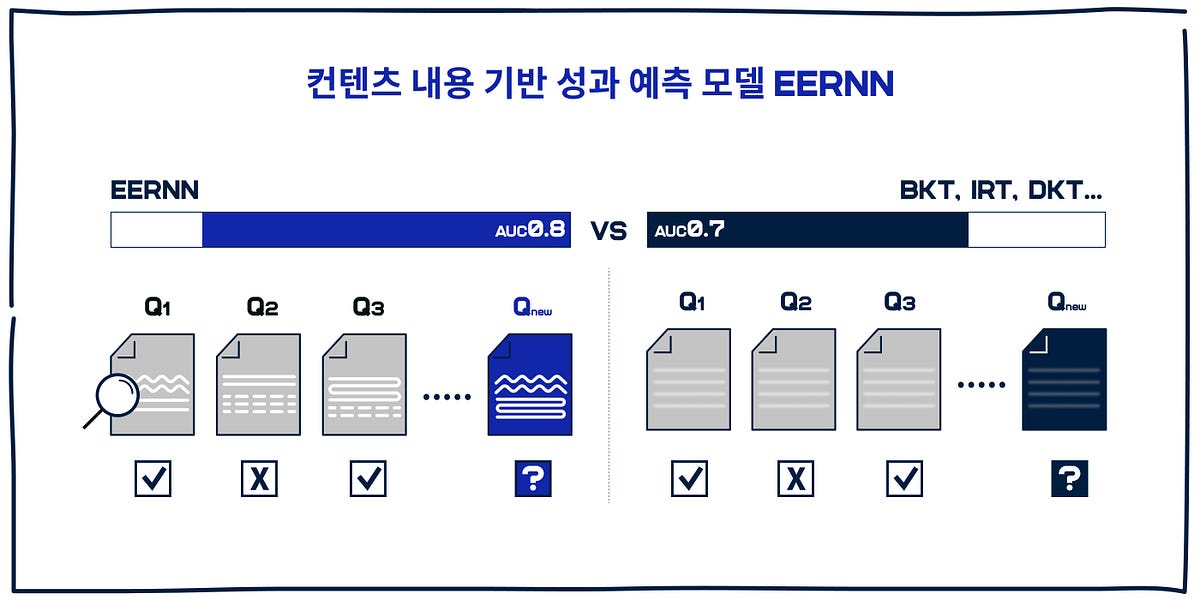
문제 텍스트를 임베딩해 학습자의 정오답을 예측하는 EERNN 구조를 소개했습니다. Attention 기반 과거 문제 연관성 활용과 실험 결과를 분석했습니다.
인간 이상의 지적 능력을 목표로 하는 범용 AI의 현실 가능성을 살펴봤습니다. 기술 공포보다 사회적 수용 준비가 선행돼야 함을 강조합니다.

AIEd 포럼을 중심으로 AI 기반 교육격차 해소와 교육 현장 도입 준비를 소개했습니다. AI 운영 자동화 오픈소스와 정오답예측 모델의 설명 가능성 연구도 다뤘습니다.

coRouter filter로 Spring WebFlux 요청·응답 로깅을 공통화한 과정을 소개했습니다. 요청 본문 재사용을 막던 프레임워크 버그를 수정해 Spring Framework에 반영했습니다.

Knowledge Tracing의 역할과 기존 단일 개념 문항 모델의 한계를 설명했습니다. 복수 개념을 반영하는 KTM의 구성과 성능 특성을 소개합니다.
