
Aurora MySQL 인덱스 DDL이 Reader 버퍼풀을 비운다?
Aurora MySQL에서 인덱스 DDL 수행 시 Reader 버퍼풀이 비워지는 현상을 다뤘습니다. 원인으로 지목된 엔진 결함과 3.14 릴리즈까지의 대응 과정을 소개합니다.
#Aurora#MySQL#인덱스
6800
Aurora MySQL 인덱스 DDL이 Reader 버퍼풀을 비운다?
Aurora MySQL에서 인덱스 DDL 수행 시 Reader 버퍼풀이 비워지는 현상을 다뤘습니다. 원인으로 지목된 엔진 결함과 3.14 릴리즈까지의 대응 과정을 소개합니다.
당근의 회원과 인증을 책임지는 Identity Service Team의 관점에서 인증이 어떻게 변화해 왔는지 소개하는 글입니다. 인증 관련 팀의 역할과 책임 범위를 개괄적으로 다루고 있습니다.
200개 이상 DB를 BigQuery로 옮기던 ELT 운영 문제를 DT Platform으로 분리·표준화했습니다. UI와 DSL, 자동 마이그레이션으로 리드타임과 리뷰 병목을 줄였습니다.
내부 PyPI 프록시 앞단에 얇은 프록시를 두어 CodeArtifact를 PyPI처럼 사용하도록 구성했습니다. 또한 PEP 691의 upload-time을 활용해 cooldown 정책을 중앙에서 적용했습니다.
이 글은 CRUD 중심 서버 설계의 한계를 보완하기 위해 이벤트 소싱과 Ventyd를 소개했습니다. 배포 추적과 게임 상태 관리 사례로 TypeScript 기반 도메인 로직 공유 방식을 설명했습니다.
당근이 User Activation을 전사 공통 데이터 레이어로 만든 배경과 구조를 설명했습니다. 상태와 전이 분석을 위해 신뢰성, 비용, 생산성을 함께 고려한 설계였습니다.
Karrot가 MongoDB 적재 방식의 한계를 해결하기 위해 CDC를 도입한 과정을 공유했습니다. 변경 로그 기반으로 BigQuery 적재를 구성하되, 초기 스냅샷은 별도 도구 활용을 검토했습니다.
MongoDB 덤프의 DB 부하와 SLO 문제를 해결하기 위해 CDC를 도입했습니다. Flink CDC와 Spark, 이중 테이블 구조로 적재와 스키마 변경, 정합성 검증을 묶었습니다.
Karrot 데이터팀이 BigQuery SQL 로그를 파싱해 컬럼 단위 데이터 계보를 구축한 과정을 소개했습니다. 테이블 단위 한계를 보완하고 영향 분석과 PII 추적을 정교하게 만든 사례입니다.
BigQuery 쿼리 로그를 SQL 파싱해 컬럼 레벨 리니지를 구축한 사례를 소개했습니다. 테이블·컬럼 의존 관계를 빠르게 추적해 데이터 신뢰성과 운영 효율을 높였습니다.
당근페이가 기존 카드망과 EMV QR 표준을 활용해 오프라인 QR 결제를 구현한 과정을 설명했습니다. 또한 세션 기반 QR 발급과 단말기 호환성 대응 등 실전 설계 포인트를 공유했습니다.

피드시스템의 반복 장애를 줄이기 위해 프로파일링과 메모리 최적화, 서킷 브레이커를 적용했습니다. 또한 PGO와 SLA/SLO/SLI 기반 모니터링으로 안정성과 성능을 함께 개선했습니다.

서버 로깅 포맷을 통일해 유저·요청 단위 추적과 호출 위치 확인이 쉬워지도록 개선했습니다. 메타데이터와 트레이스를 더해 디버깅과 모니터링 효율을 높였습니다.

DataHub로 메타데이터의 수집과 신선도 관리를 먼저 정비했습니다. 이후 DataWiki와 SSOT를 더해 도메인 맥락까지 담는 데이터 탐색 환경을 구축했습니다.

여러 경로로 모은 업체 정보의 중복을 병합으로 정리하고, 변경 이력을 바탕으로 대표 프로필의 값을 고도화했습니다. 필드별 정책을 분리해 더 합리적인 정보를 노출하도록 개선했습니다.
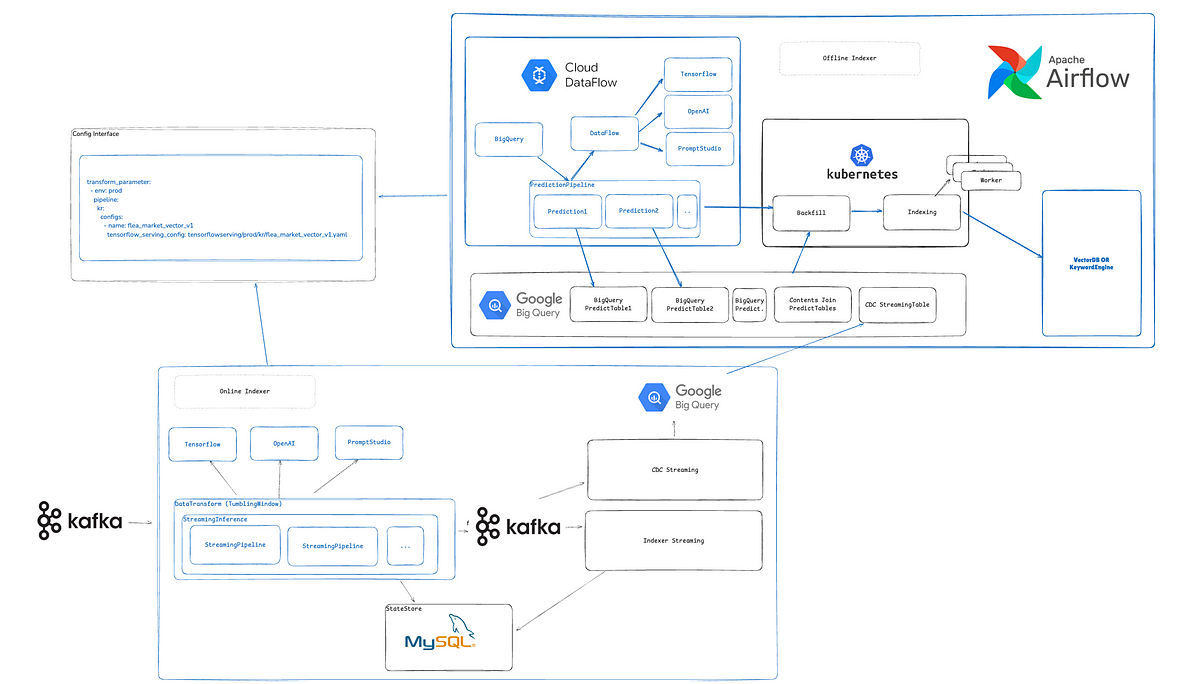
검색 색인 파이프라인의 생산성과 안정성을 높이기 위해 설정 기반 자동화, Offline Storage 활용, 배치 처리 구조를 도입했습니다. 이를 통해 대용량 이벤트와 풀색인 비용 문제를 줄이고 운영 효율을 개선했습니다.
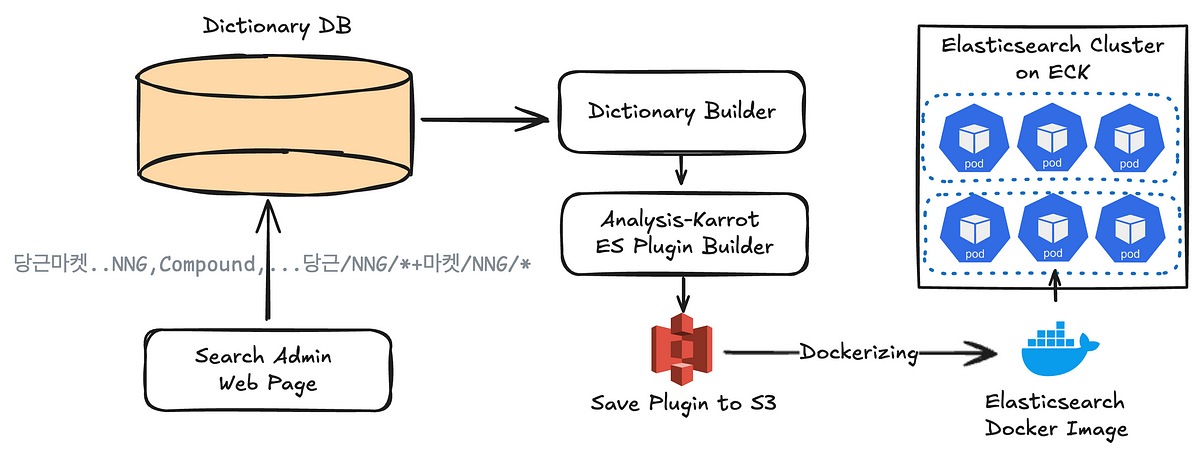
검색 형태소 분석 사전의 배포 과정을 Elasticsearch 재배포 없이 바꾸려는 개선 과정을 다뤘습니다. 메모리 증가 문제를 겪은 뒤 경량화와 버전별 사전 관리로 운영 가능성을 확보했습니다.
알림의 품질을 위해 방치, 오픈율, 피로도를 기준으로 모니터링 체계를 마련했습니다. 기준 미충족 알림은 슬랙과 알림 센터로 전달해 담당자가 바로 조치하도록 했습니다.
