백엔드
검색 형태소 분석 사전 배포 과정 개선하기
두줄요약
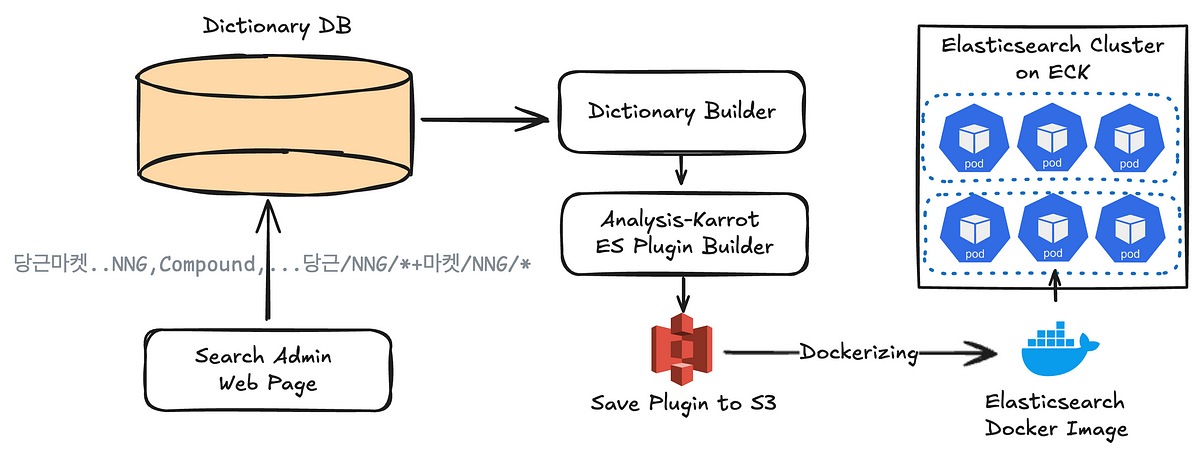
검색 형태소 분석 사전의 배포 과정을 Elasticsearch 재배포 없이 바꾸려는 개선 과정을 다뤘습니다. 메모리 증가 문제를 겪은 뒤 경량화와 버전별 사전 관리로 운영 가능성을 확보했습니다.
검색 형태소 분석 사전의 배포 과정을 Elasticsearch 재배포 없이 바꾸려는 개선 과정을 다뤘습니다. 메모리 증가 문제를 겪은 뒤 경량화와 버전별 사전 관리로 운영 가능성을 확보했습니다.
ML Engineer (검색 Relevance)
토스 · Seoul
검색 Relevance 모델의 레이블 설계부터 임베딩·랭킹 모델 학습, 데이터 파이프라인, 오프라인 평가와 A/B 실험까지 엔드투엔드로 담당합니다. 검색 도메인 실무 경험과 대규모 로그·행동 데이터 기반 데이터셋 구축, 임베딩·랭킹 모델 학습, LLM 활용 역량이 필요합니다.
[CC CTO] Search Engineer
다나와 · 경력 · 서울 가산(대륭)
다나와 검색 전반의 배치·API 개발, 형태소 분석기 운영, 대규모 데이터 색인 시스템 구축과 검색 성능 개선을 담당합니다. Java·Spring·Spring Boot, Linux 스크립팅 및 Elasticsearch·Lucene·Solr 등 검색엔진 경험이 필요합니다.
검색 플랫폼 개발자 (Back-end)
올리브영 · 경력 5년 이상 · CJ올리브영
올리브영 온·오프라인 통합 검색 서비스의 백엔드와 검색 마이크로서비스, 대규모 분산 검색 클러스터를 설계·운영합니다. Java/Kotlin, Spring Boot, OpenSearch/Elasticsearch 기반 상용 서비스 경험과 RESTful API·대규모 트래픽 아키텍처 이해가 필요합니다.
#Elasticsearch 주제를 다룬 다른 회사 글
Elasticsearch 한국어 분석기 Mecab-Ko, Nori, Fastcat의 색인 성능을 비교했습니다. 사전 수를 줄이면 색인 시간이 줄어들고, Nori는 상대적으로 느렸습니다.