
LG 에너지 솔루션의 Amazon DataZone을 활용한 데이터 거버넌스 혁신 전략
LG에너지솔루션이 Amazon DataZone으로 데이터와 ML 거버넌스를 통합한 사례를 소개했습니다. 데이터 자산화, 권한 관리, 품질 관리, 모니터링 체계를 함께 구축한 내용입니다.
#Amazon DataZone#데이터 거버넌스#AWS Glue
4700


LG에너지솔루션이 Amazon DataZone으로 데이터와 ML 거버넌스를 통합한 사례를 소개했습니다. 데이터 자산화, 권한 관리, 품질 관리, 모니터링 체계를 함께 구축한 내용입니다.
Amazon DataZone와 OpenLineage를 활용해 RDS View 테이블의 데이터 계보를 작성하는 방법을 소개했습니다. pg_get_viewdef와 SQL Parser로 입력·출력 테이블을 추출한 뒤 Lambda로 DataZone에 반영했습니다.

Hugging Face Transformer 모델을 AWS Inferentia/Trainium에 포팅하는 과정을 검증했습니다. return_dict=False 설정으로 tracing 오류를 줄여 12개 모델 모두 배포 가능함을 확인했습니다.

Neptune Database와 Neptune Analytics 간 동기화 방안을 설명했습니다. 특히 Neptune Streams, Lambda, EventBridge를 활용한 준 실시간 연동과 체크포인트 관리에 초점을 맞췄습니다.

대용량 MySQL DB를 Aurora MySQL로 옮길 때 MyDumper와 MyLoader를 활용한 멀티스레드 논리 마이그레이션 방법을 소개했습니다. 백업·복원 속도 개선 옵션과 벤치마크 결과, AWS DMS 대안까지 함께 설명했습니다.

포스코홀딩스는 다수 CCTV의 AI 추론 결과를 Kinesis와 Managed Apache Flink로 실시간 분석했습니다. CloudWatch 필터링, CEP 최적화, State Backend 조정으로 이벤트 감지와 운영 효율을 높였습니다.

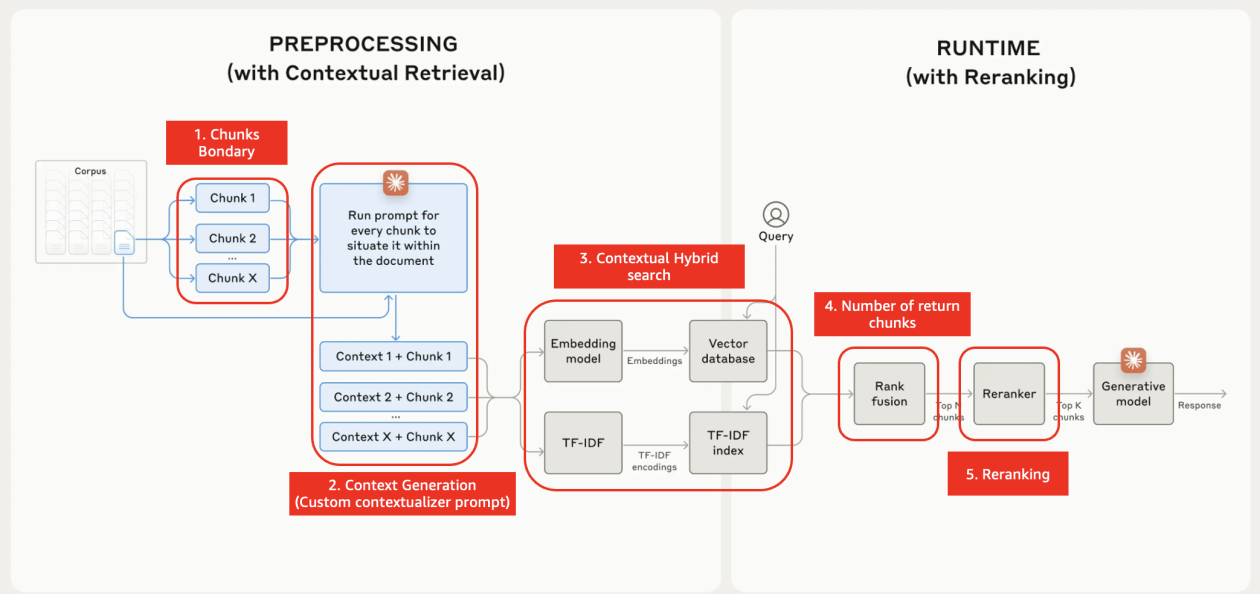
Amazon Bedrock에서 Contextual Retrieval로 RAG 검색 정확도를 높이는 방법을 설명했습니다. 전처리 컨텍스트 생성, 하이브리드 검색, 리랭킹, 프롬프트 캐싱까지 실무 구성을 함께 다뤘습니다.
Amazon Bedrock과 AWS Config로 규제 요구사항을 규칙에 자동 매핑하는 도구를 소개했습니다. 수동 관리의 한계를 줄이기 위한 프롬프트 설계와 운영 포인트도 함께 설명했습니다.

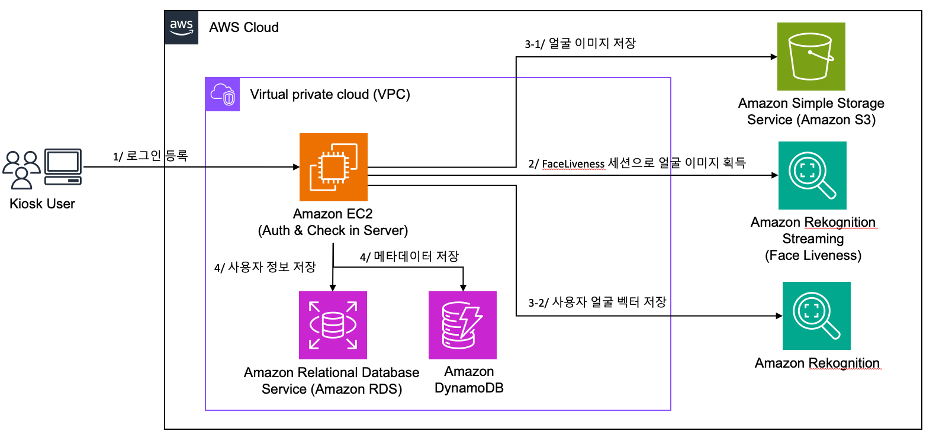
Amazon Rekognition Face Liveness로 무인 키오스크의 얼굴 등록과 로그인 흐름을 구현한 사례를 다뤘습니다. SAGA 패턴과 스냅샷 기반 인식으로 일관성과 저사양 기기 호환성도 함께 확보했습니다.
Amazon EBS CreateVolume의 리소스 수준 권한이 스냅샷까지 확장되었습니다. 기존 IAM 정책은 볼륨과 스냅샷을 함께 허용하도록 점검하고, DryRun으로 검증해야 합니다.
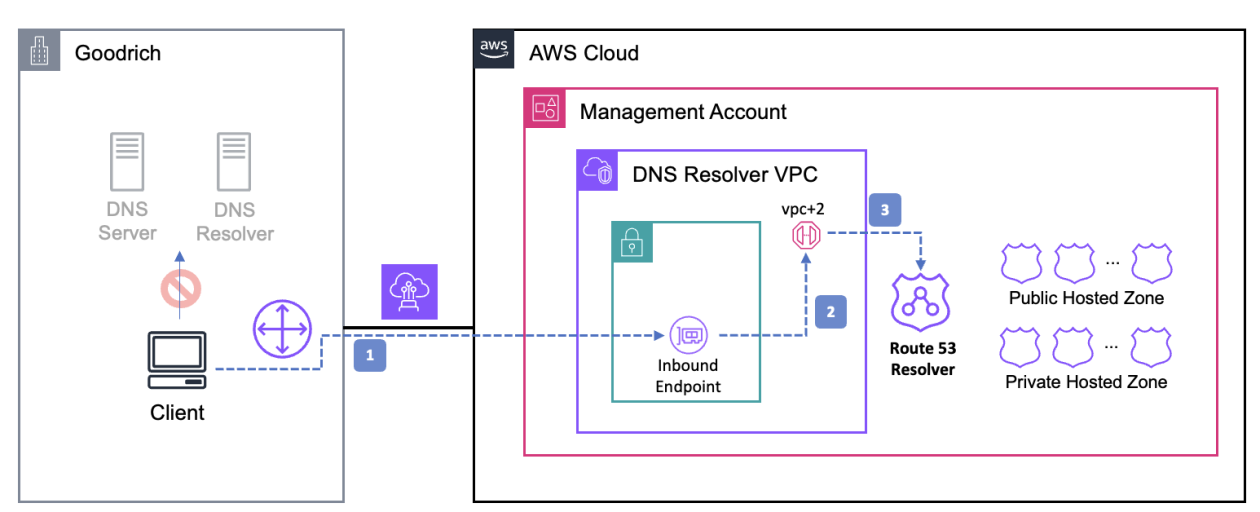
굿리치는 온프레미스 DNS를 Amazon Route 53으로 옮기며 공용·사설 도메인을 통합 관리했습니다. 무중단 전환을 위해 병행 운영과 단계적 이관, 모니터링 검증을 진행했습니다.
Amazon Bedrock과 Amazon OpenSearch로 헤지펀드용 Company Screener Agent를 구현한 사례를 소개했습니다. 금융 특화 임베딩과 하이브리드 검색으로 종목 선별, 요약, 검증을 자동화한 효과를 설명했습니다.

Amazon OpenSearch Service OR1 인스턴스의 내부 구조와 데이터 흐름을 설명했습니다. Amazon S3 기반 원격 저장과 물리 복제로 처리량, 내구성, 복구 효율을 높이는 방식을 다뤘습니다.
Amazon Bedrock과 Claude 3 Haiku로 연말정산 Q&A 챗봇을 구축해 문의 대응을 개선했습니다. 구조화 데이터와 프롬프트 최적화를 통해 직접 문의를 약 40% 줄이고 생산성을 높였습니다.

AWS Glue SAP OData 커넥터로 SAP 데이터를 S3에 적재하고 델타 토큰 기반 증분 로드를 구성하는 방법을 소개했습니다. 자재 마스터와 자재 그룹 텍스트를 조인해 Athena에서 분석하는 흐름도 함께 설명했습니다.
Amazon DocumentDB의 문서 압축 기능으로 저장 공간과 I/O 비용을 줄이는 방법을 소개했습니다. 샘플 데이터셋 기준 최대 34% 절감 사례와 적용 시 유의점을 함께 설명했습니다.
Amazon EKS Auto Mode로 쿠버네티스 클러스터의 컴퓨팅, 스토리지, 네트워킹 관리를 자동화하는 방법을 소개했습니다. 샘플 애플리케이션 배포와 자동 확장 사례를 통해 운영 오버헤드 감소와 가용성 향상을 설명했습니다.

AWS Step Functions와 Amazon Bedrock으로 IAM Policy를 자동 생성·검증·할당하는 워크플로를 소개했습니다. 임시 권한 부여와 자동 회수로 최소 권한 원칙과 운영 효율성을 높이는 방법을 다뤘습니다.
