국내 IT 기업 기술 블로그 최신 글

필터 1
Closing the GitHub Actions Monitoring Gap: Observing ARC Runners with an Exporter
당근마켓
데브옵스

Closing the GitHub Actions Monitoring Gap: Observing ARC Runners with an Exporter

ARC Runner와 GitHub Actions Job의 연결 및 대기 상태를 관측하는 exporter를 구축했습니다. 웹훅·S3 상태 보존·알림으로 대기 지연과 Runner 병목을 탐지했습니다.

#GitHub Actions#Kubernetes
1900
GitHub Actions 모니터링의 빈칸: Exporter로 ARC Runner 관측하기
당근마켓
데브옵스

GitHub Actions 모니터링의 빈칸: Exporter로 ARC Runner 관측하기

ARC Runner와 GitHub Actions Job의 대기·실행 상태를 관측하는 exporter 구조를 소개했습니다. 웹훅 순서 역전, 스냅샷 복원, 이벤트 누락 문제를 재전송과 리컨사일로 개선했습니다.

#GitHub Actions#Kubernetes
1500
인프라팀에 업무 요청이 들어오면 5분동안 벌어지는 일
아임웹
데브옵스

인프라팀에 업무 요청이 들어오면 5분동안 벌어지는 일

인프라 문의가 늘자 사람을 늘리지 않고, 같은 정보에서 시작하는 업무 요청 구조를 만들었습니다. 5분 내 자동 배정과 트리아지로 응답 지연과 미처리 문의를 줄이고, 장애 대응과 팀 생산성도 개선했습니다.

#인프라#Slack
4400
AI를 전제로 다시 설계하다, Tech-Verse 2026 참관기
라인
AI

AI를 전제로 다시 설계하다, Tech-Verse 2026 참관기

Tech-Verse 2026에서 AI 주도 개발과 AX 전환의 핵심 흐름을 살펴보았습니다. 모델보다 환경·검증·설계가 중요하다는 실무 관점을 중심으로 정리했습니다.

#LLM#MCP
6400
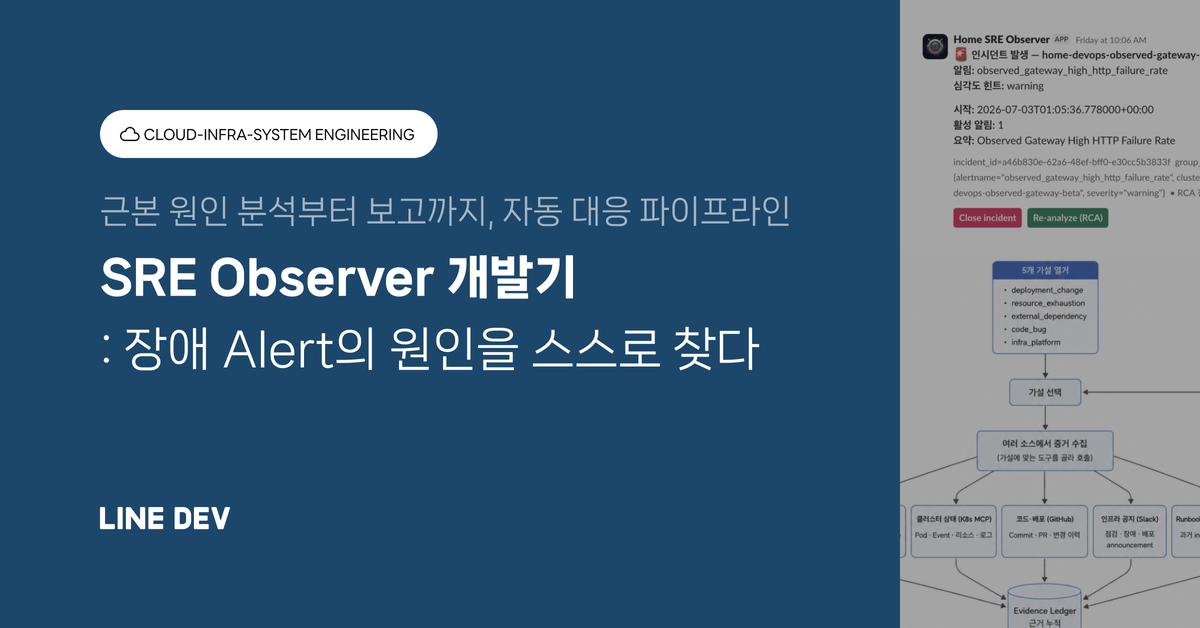
장애 Alert의 원인을 스스로 찾다: SRE Observer 개발기
라인
AI

장애 Alert의 원인을 스스로 찾다: SRE Observer 개발기

Alert를 자동으로 묶고 근본 원인까지 분석하는 SRE Observer 개발 과정을 소개했습니다. 근거 기반 가드레일과 승인 경계로 과신을 막고 대응 자동화를 설계했습니다.

#SRE#LLM
5200
삼성 계정 AIOps: AgentCore기반 멀티 에이전트 운영 자동화 여정
AWS
AI

삼성 계정 AIOps: AgentCore기반 멀티 에이전트 운영 자동화 여정

삼성계정 운영팀이 AgentCore 기반 멀티 에이전트 AIOps를 3계층 구조로 설계한 과정을 소개했습니다. 분석 자동화부터 관측, 평가, 가드레일까지 운영 가능한 자율화 토대를 구축했습니다.

#AIOps#LLM
2200
SRE 업무에 AI 녹여내기 — 2편: Alert Adviser로 장애 원인 분석 자동화
여기어때
AI

SRE 업무에 AI 녹여내기 — 2편: Alert Adviser로 장애 원인 분석 자동화

SRE 업무에 AI를 접목해 장애 원인 분석 자동화를 다룬 글입니다. 다만 본문은 접근 차단 안내만 확인되어 세부 내용은 확인되지 않았습니다.

#SRE#자동화
4900
쿠팡 파트너스

광고

개발자를 위한 서적을 확인해 보세요

이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

#개발서적#프로그래밍
SRE 업무에 AI 녹여내기 — 1편: Smart RI Calc로 인프라 비용 산정 자동화
여기어때
AI

SRE 업무에 AI 녹여내기 — 1편: Smart RI Calc로 인프라 비용 산정 자동화

SRE 업무에 AI를 접목해 인프라 비용 산정 자동화를 다룬 글입니다. 다만 본문 접근이 제한되어 Smart RI Calc의 세부 내용은 충분히 확인되지 않았습니다.

#SRE#AWS
3600
[구축사례] kt cloud PLATFORM Observability Alert 플랫폼 구축하기
KT 클라우드
아키텍처

[구축사례] kt cloud PLATFORM Observability Alert 플랫폼 구축하기

kt cloud가 Observability Alert 플랫폼을 구축한 사례를 정리했습니다. 조직별 격리, 통합관제 연계, 이력 관리를 위한 설계와 운영 포인트를 다뤘습니다.

#observability#Grafana
1700
플랫폼은 왜 계속 다시 설계되어야 할까 - Server Platform Team 이야기
라포랩스
기타

플랫폼은 왜 계속 다시 설계되어야 할까 - Server Platform Team 이야기

서버 플랫폼 팀이 조직 성장에 맞춰 플랫폼을 계속 재설계하는 이유를 소개했습니다. AI 시대의 분석·개발·운영 변화와 그에 따른 가드레일까지 함께 다뤘습니다.

#SRE#CI/CD
10500
AI 트리아지로 인입을 자동 분류하기
아임웹
AI

AI 트리아지로 인입을 자동 분류하기

인프라 인입 이슈를 AI 트리아지로 자동 분류하고 런북으로 라우팅하는 설계를 정리했습니다. 분류와 실행을 분리하고, 사용자 컨펌 전 외부 액션을 막는 안전한 운영 원칙을 소개했습니다.

#triage#SRE
1500
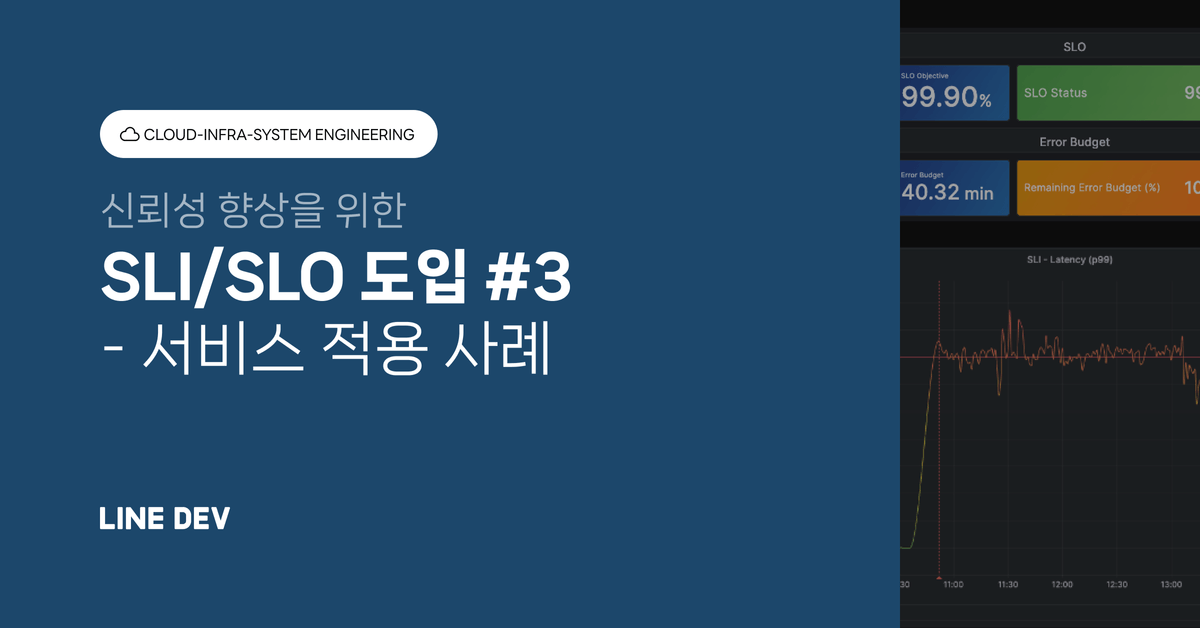
신뢰성 향상을 위한 SLO/SLI 도입 3편 - 서비스 적용 사례
라인
아키텍처

신뢰성 향상을 위한 SLO/SLI 도입 3편 - 서비스 적용 사례

SLI/SLO를 서비스 관점에서 정의하고 운영에 적용하는 방법을 정리했습니다. 오류 예산과 대시보드를 활용해 신뢰성과 개발 리소스 균형을 맞추는 사례를 소개했습니다.

#SRE#SLO
4800
라포랩스 직무 인터뷰 시리즈 Colon: Backend Chapter Leader
라포랩스
기타

라포랩스 직무 인터뷰 시리즈 Colon: Backend Chapter Leader

라포랩스 Backend Chapter Leader의 커리어와 팀 운영 방식, AI Native 전환 방향을 소개했습니다. 시니어 엔지니어의 역할을 팀 임팩트와 리더십 중심으로 설명했습니다.

#AWS#SRE
10000
SRE 팀의 반복 작업을 10분의 1로 줄인 SRE 봇 개발기
라인
데브옵스

SRE 팀의 반복 작업을 10분의 1로 줄인 SRE 봇 개발기

SRE 반복 작업과 문의 대응을 Slack 워크플로 중심의 봇으로 자동화한 개발기입니다. 배포와 일반 요청 처리 시간을 크게 줄이고 운영 가시성도 높였습니다.

#SRE#Slack
12600