
노
[넷츠프레소 AQ 딥다이브] K-EXAONE-236B 모델을 4비트(NVFP4)로 양자화하는 법
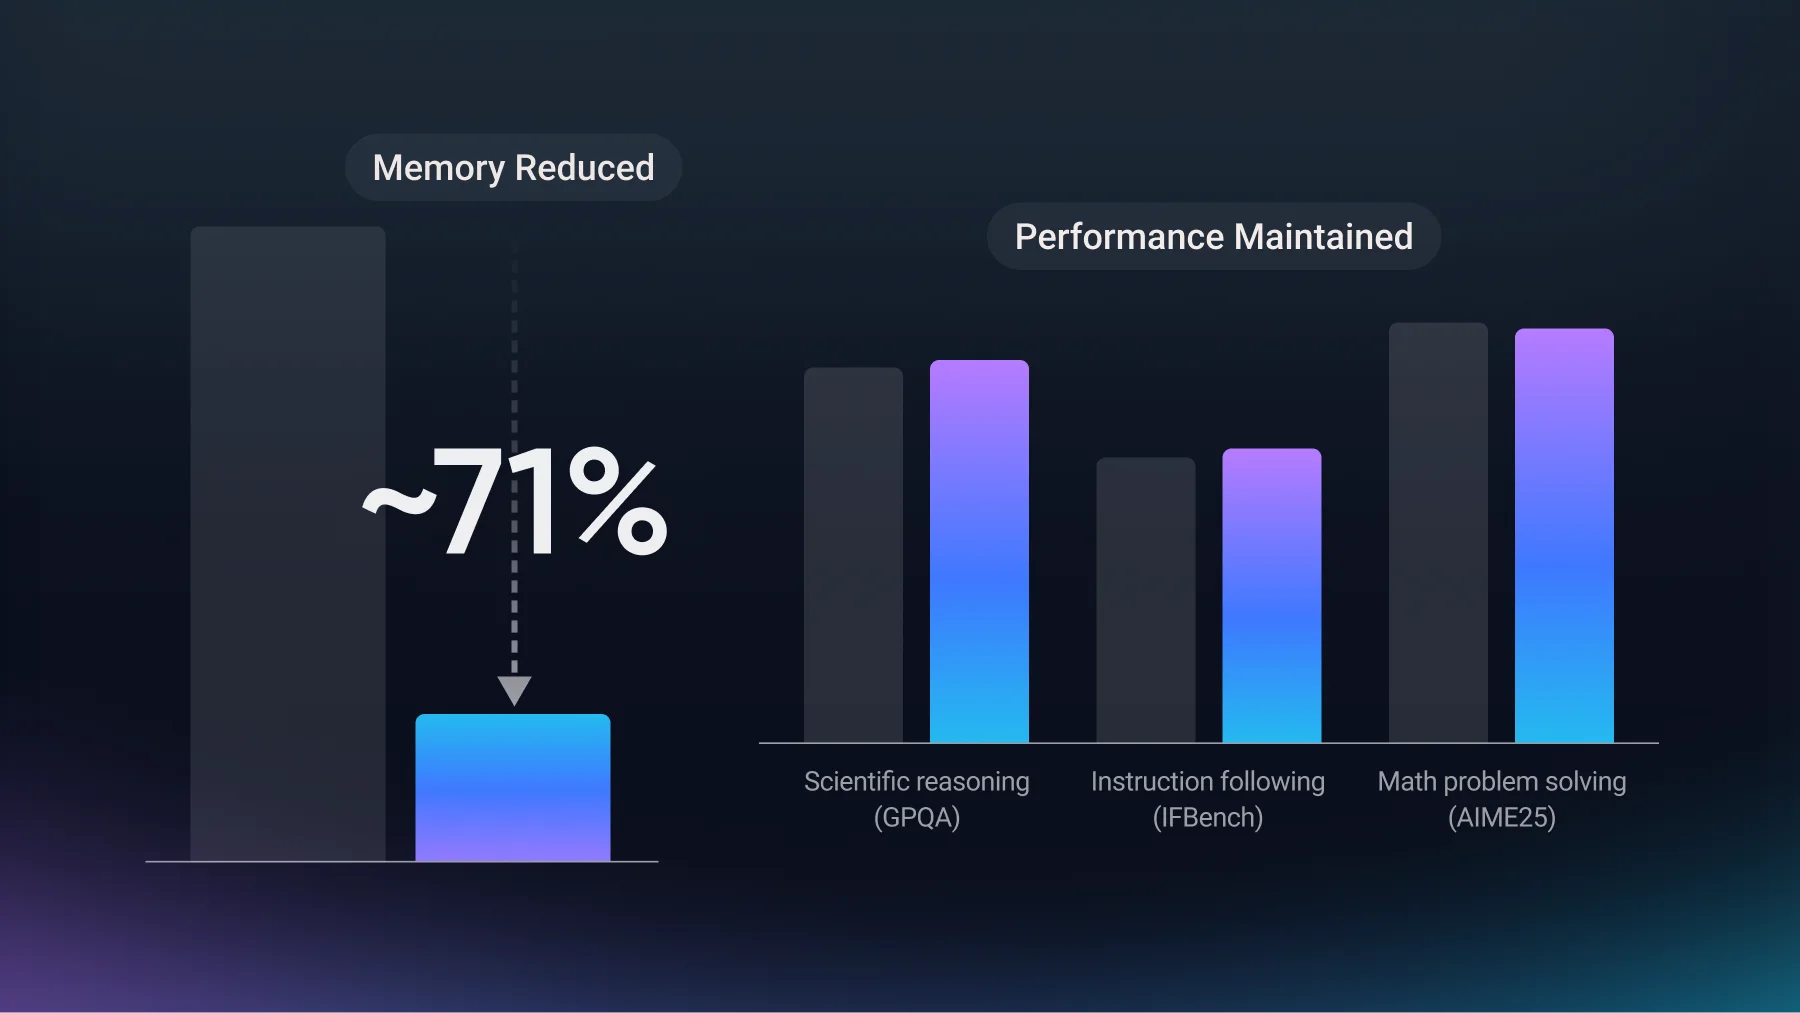
K-EXAONE-236B MoE의 집중 이상치를 오프라인 변환으로 제어해 NVFP4로 양자화했습니다. 추가 커널 없이 vLLM에서 서빙하며 BF16 수준 정확도와 약 3.5배 압축을 제시했습니다.
#LLM#MoE
000
새로운 기술 블로그가 추가되었어요
K-EXAONE-236B MoE의 집중 이상치를 오프라인 변환으로 제어해 NVFP4로 양자화했습니다. 추가 커널 없이 vLLM에서 서빙하며 BF16 수준 정확도와 약 3.5배 압축을 제시했습니다.
TurboQuant의 KV 캐시 양자화가 AI 메모리·전력 효율 경쟁의 핵심 신호임을 분석했습니다. 연구 단계인 만큼 실제 서빙 환경에서의 검증 필요성도 짚었습니다.
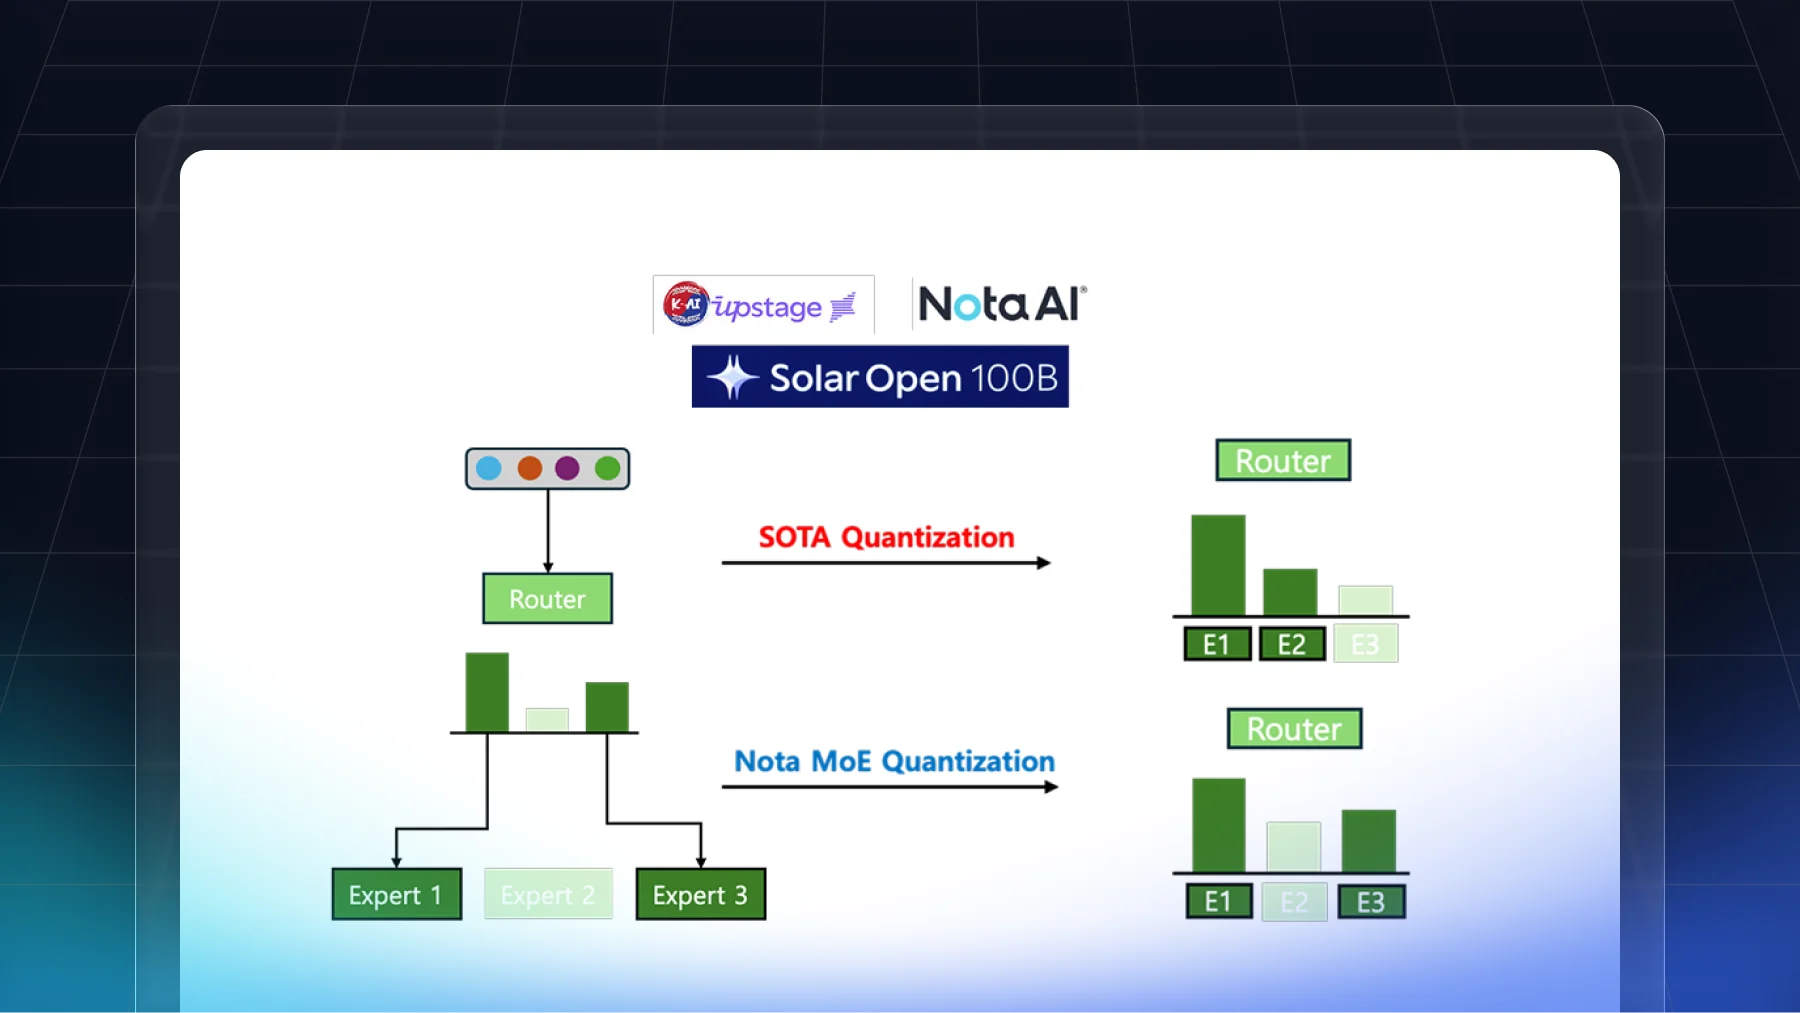
MoE 양자화의 재라우팅 문제를 줄이기 위한 NMQ 손실 함수를 소개했습니다. Solar-Open-100B에서 성능과 라우팅 일치도 개선을 확인했습니다.
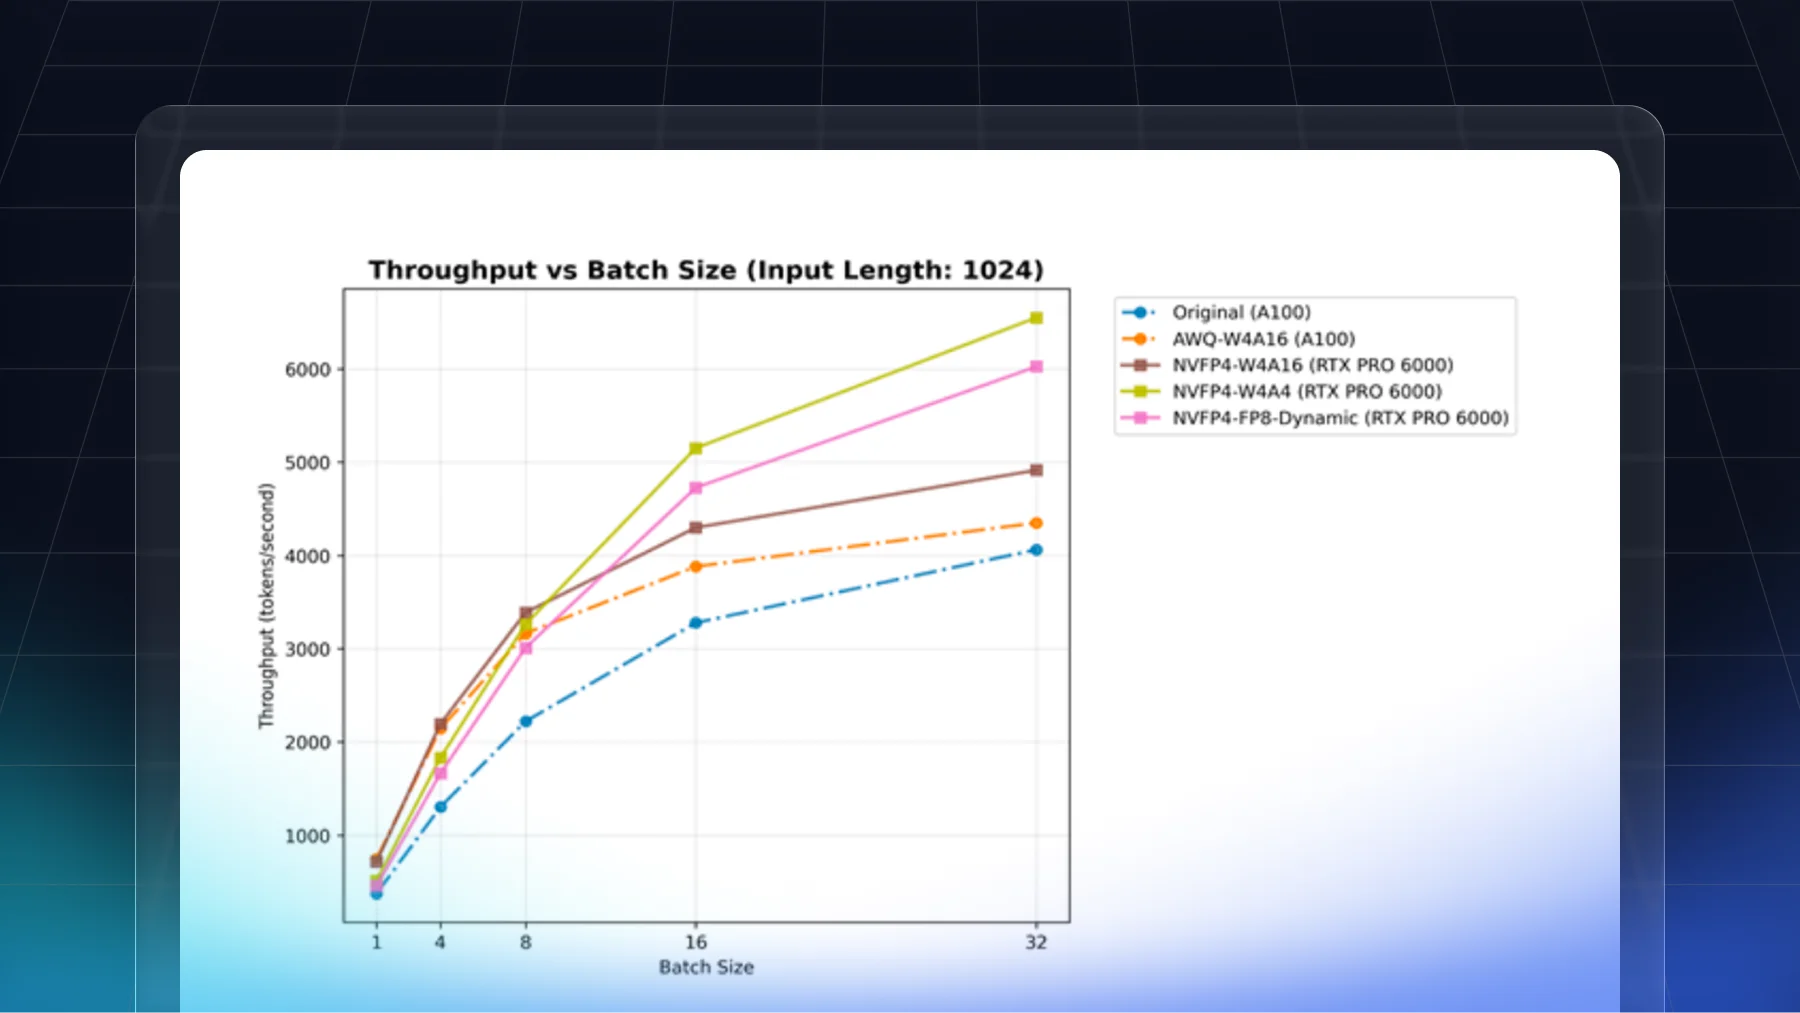
Blackwell용 NVFP4의 2단계 스케일링 구조와 LLM 추론 실측 결과를 분석했습니다. RTX PRO 6000에서 A100 대비 최대 2배 처리량과 미미한 정확도 차이를 확인했습니다.