


데이터 분석 라이브러리 개발기 (2) - 통합 테스팅과 문서화를 동시에 잡는 방법
MinIO와 pytest fixture로 S3 의존성 없는 PySpark 통합 테스트 환경을 구축했습니다.\npytest doctest와 Sphinx를 결합해 실행 가능한 API 문서를 유지했습니다.
#Python#PySpark
2800
새로운 기술 블로그가 추가되었어요
MinIO와 pytest fixture로 S3 의존성 없는 PySpark 통합 테스트 환경을 구축했습니다.\npytest doctest와 Sphinx를 결합해 실행 가능한 API 문서를 유지했습니다.


AWS Amplify Console로 Git 기반 자동 배포와 Pull Request별 테스트 환경을 구축했습니다. SPA Rewrite와 HTTPS, Rewrite Rule 적용 문제의 대응 방법도 공유했습니다.

후기 이미지 분류 모델 재훈련을 위해 이미지 정제와 수작업 라벨링 방식을 비교했습니다. SageMaker Ground Truth의 협업 장점과 대규모 작업 비용 부담을 검토했습니다.
훈련 이미지의 중복·손상 파일을 정리하고 수작업 분류 방식들을 비교했습니다. SageMaker Ground Truth로 협업 분류를 검토했지만 높은 과금이 도입 장벽이었습니다.


Travis CI로 React SPA 빌드 결과물을 S3와 CloudFront에 자동 배포하는 구성을 소개했습니다. 보안 키 관리, SPA 라우팅용 오류 페이지, 캐시 무효화와 Slack 알림 설정을 다뤘습니다.
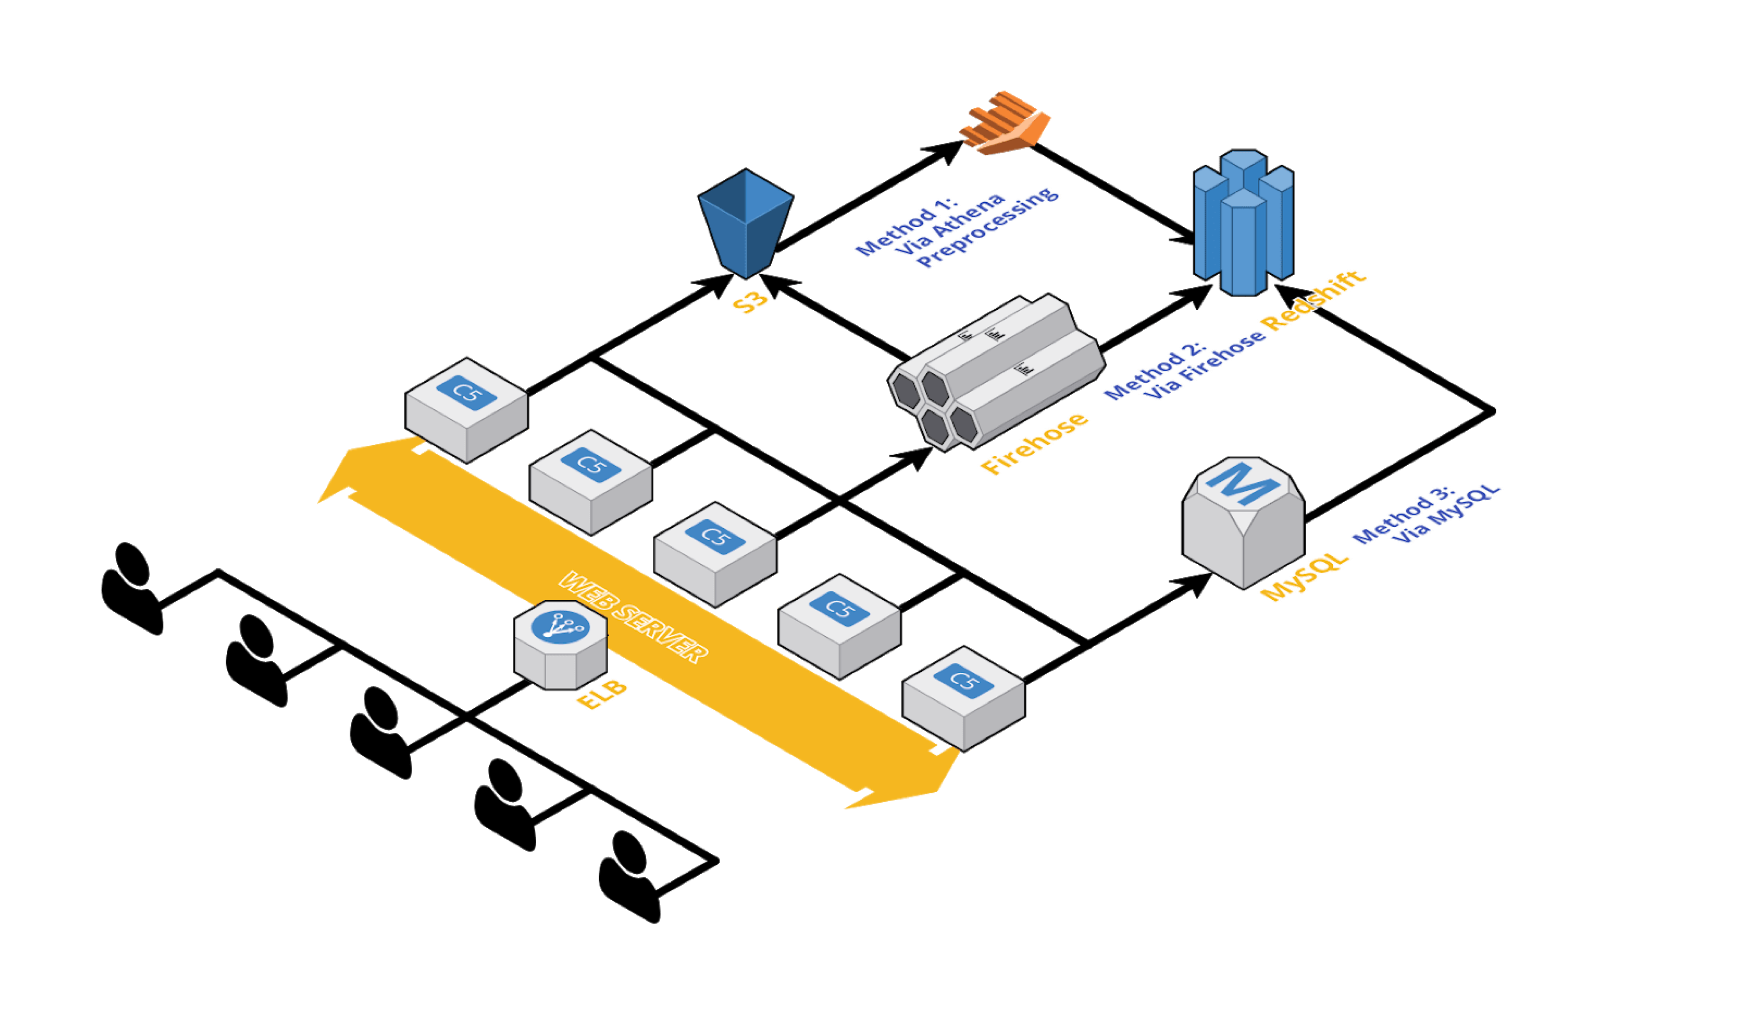
여러 국가의 유저 행동 및 광고 데이터를 다양한 저장소에서 수집하는 환경을 소개했습니다. 분석과 활용을 위해 분산 데이터를 한곳에 모으는 필요성을 설명합니다.


Spark 로그 저장 포맷을 JSON에서 Parquet로 전환하고 인코딩 옵션을 조정했습니다. 저장 용량을 74% 줄이고 쿼리 성능을 10~30배 높였습니다.
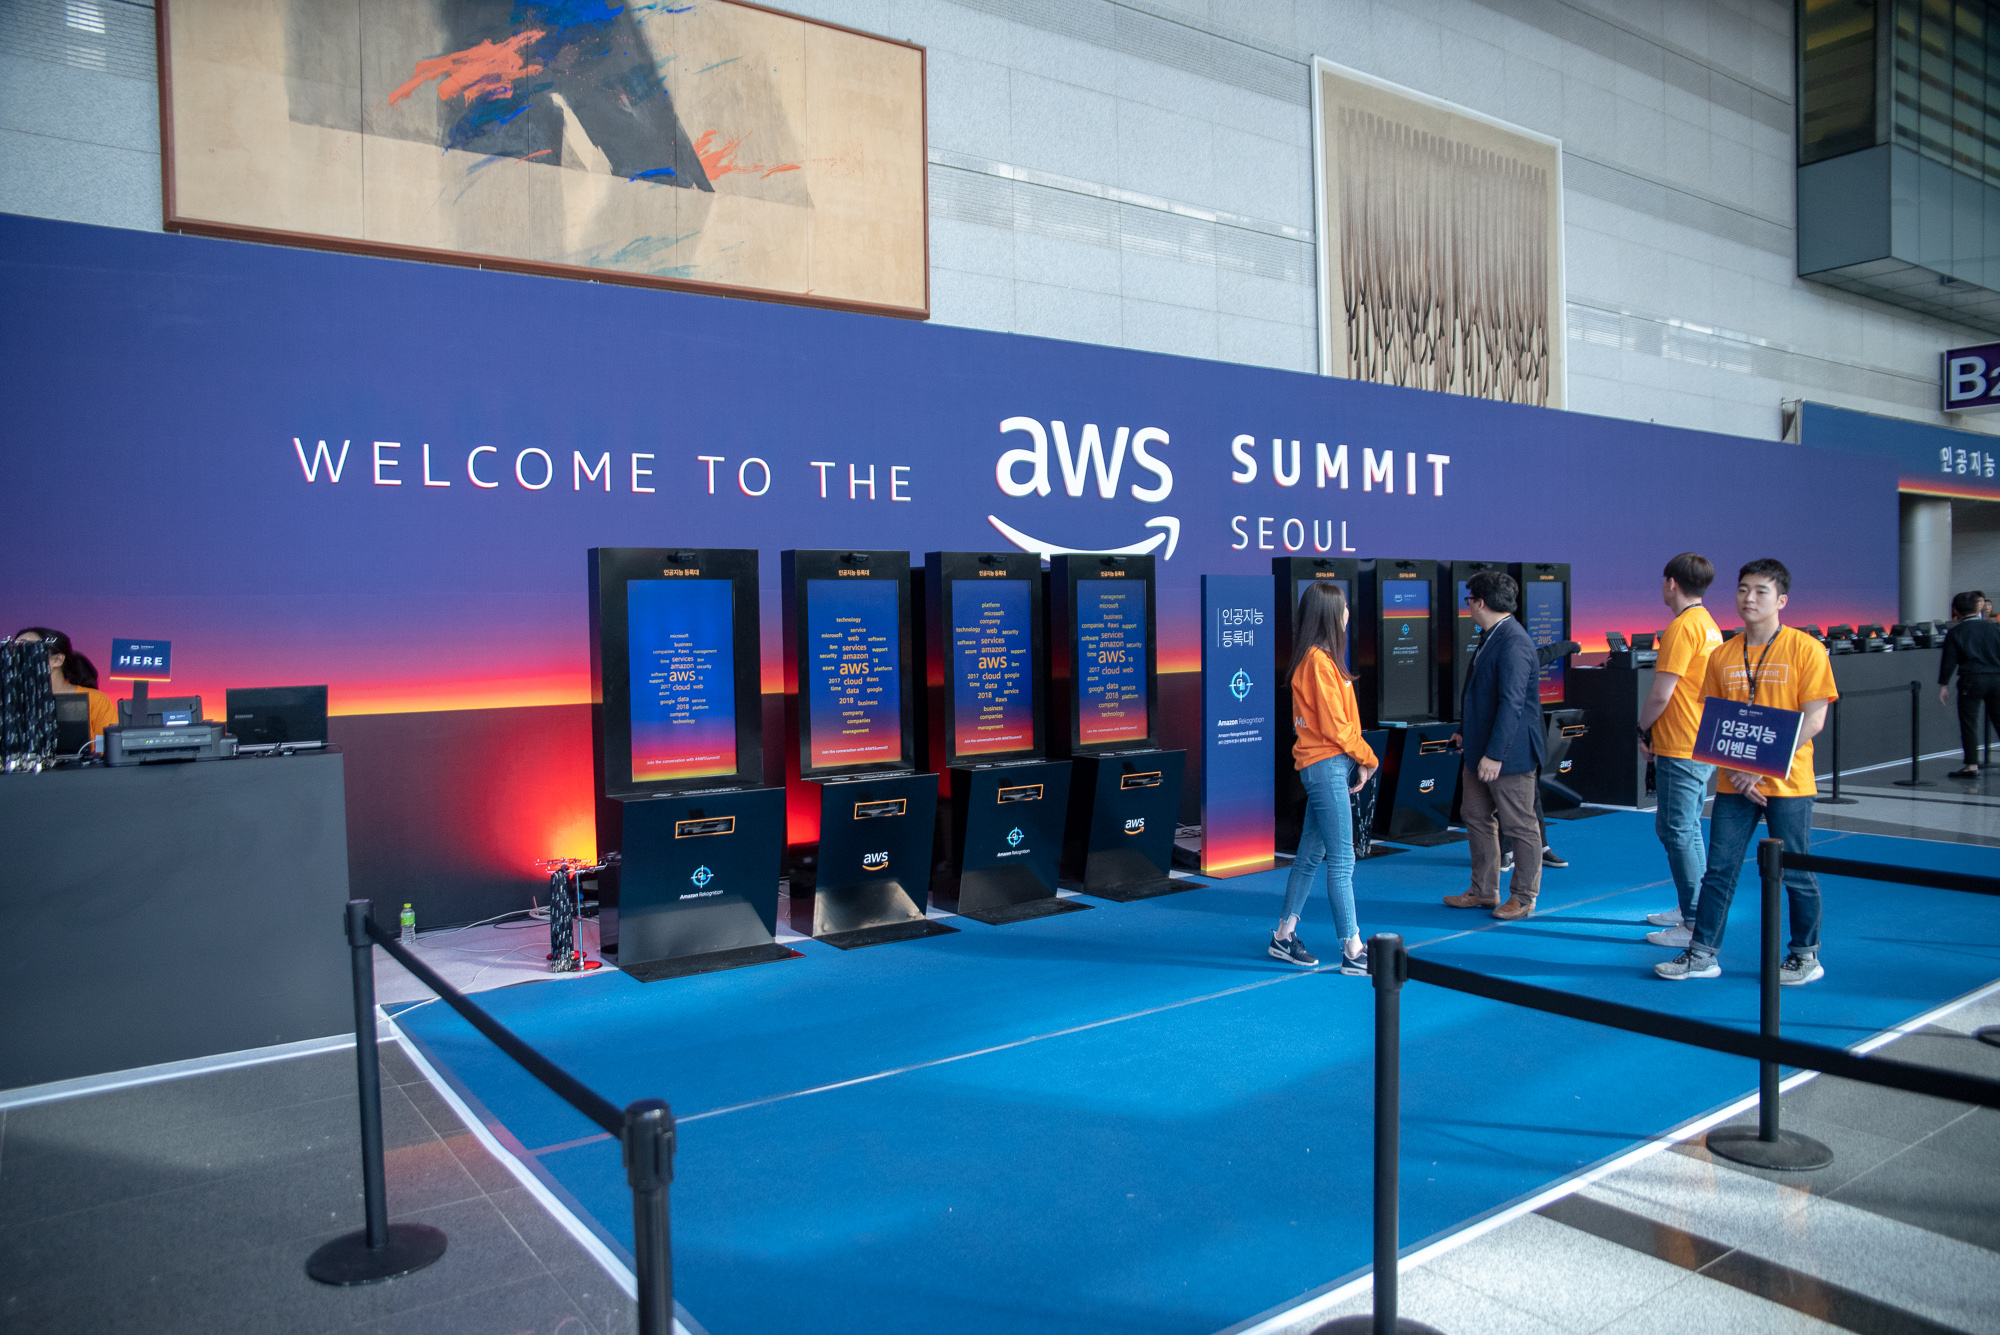
AWS Summit Seoul 2018의 행사 구성과 클라우드 기술 동향을 소개했습니다. 버즈빌의 다양한 AWS 인프라 활용 맥락도 함께 언급했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

사전 생성 썸네일을 WebP 원본 기반 온디맨드 리사이징으로 전환했습니다.\nSQS·Spot Instance 마이그레이션으로 S3 비용을 70% 이상 절감했습니다.
MapReduce 중심 분석 시스템을 Spark·Zeppelin·AWS 기반으로 점진 전환했습니다. 분석 시간을 약 8시간에서 1시간으로 줄이고 관리 부담과 대시보드 운영 복잡도를 낮췄습니다.

Jekyll·S3·CloudFront로 정적 블로그를 구성하고 배포 과정을 자동화했습니다. JIRA와 Pull request를 글감 관리·리뷰에 적용해 개발 문화를 운영에 녹였습니다.

스티커 스토어·다운로드·권한 검증 구조와 구현 선택을 정리했습니다.\nWebP, CDN, GAE, 서명 토큰으로 용량·운영·보안 문제를 해결했습니다.