

Buzzvil's Success Story with Google Vision API
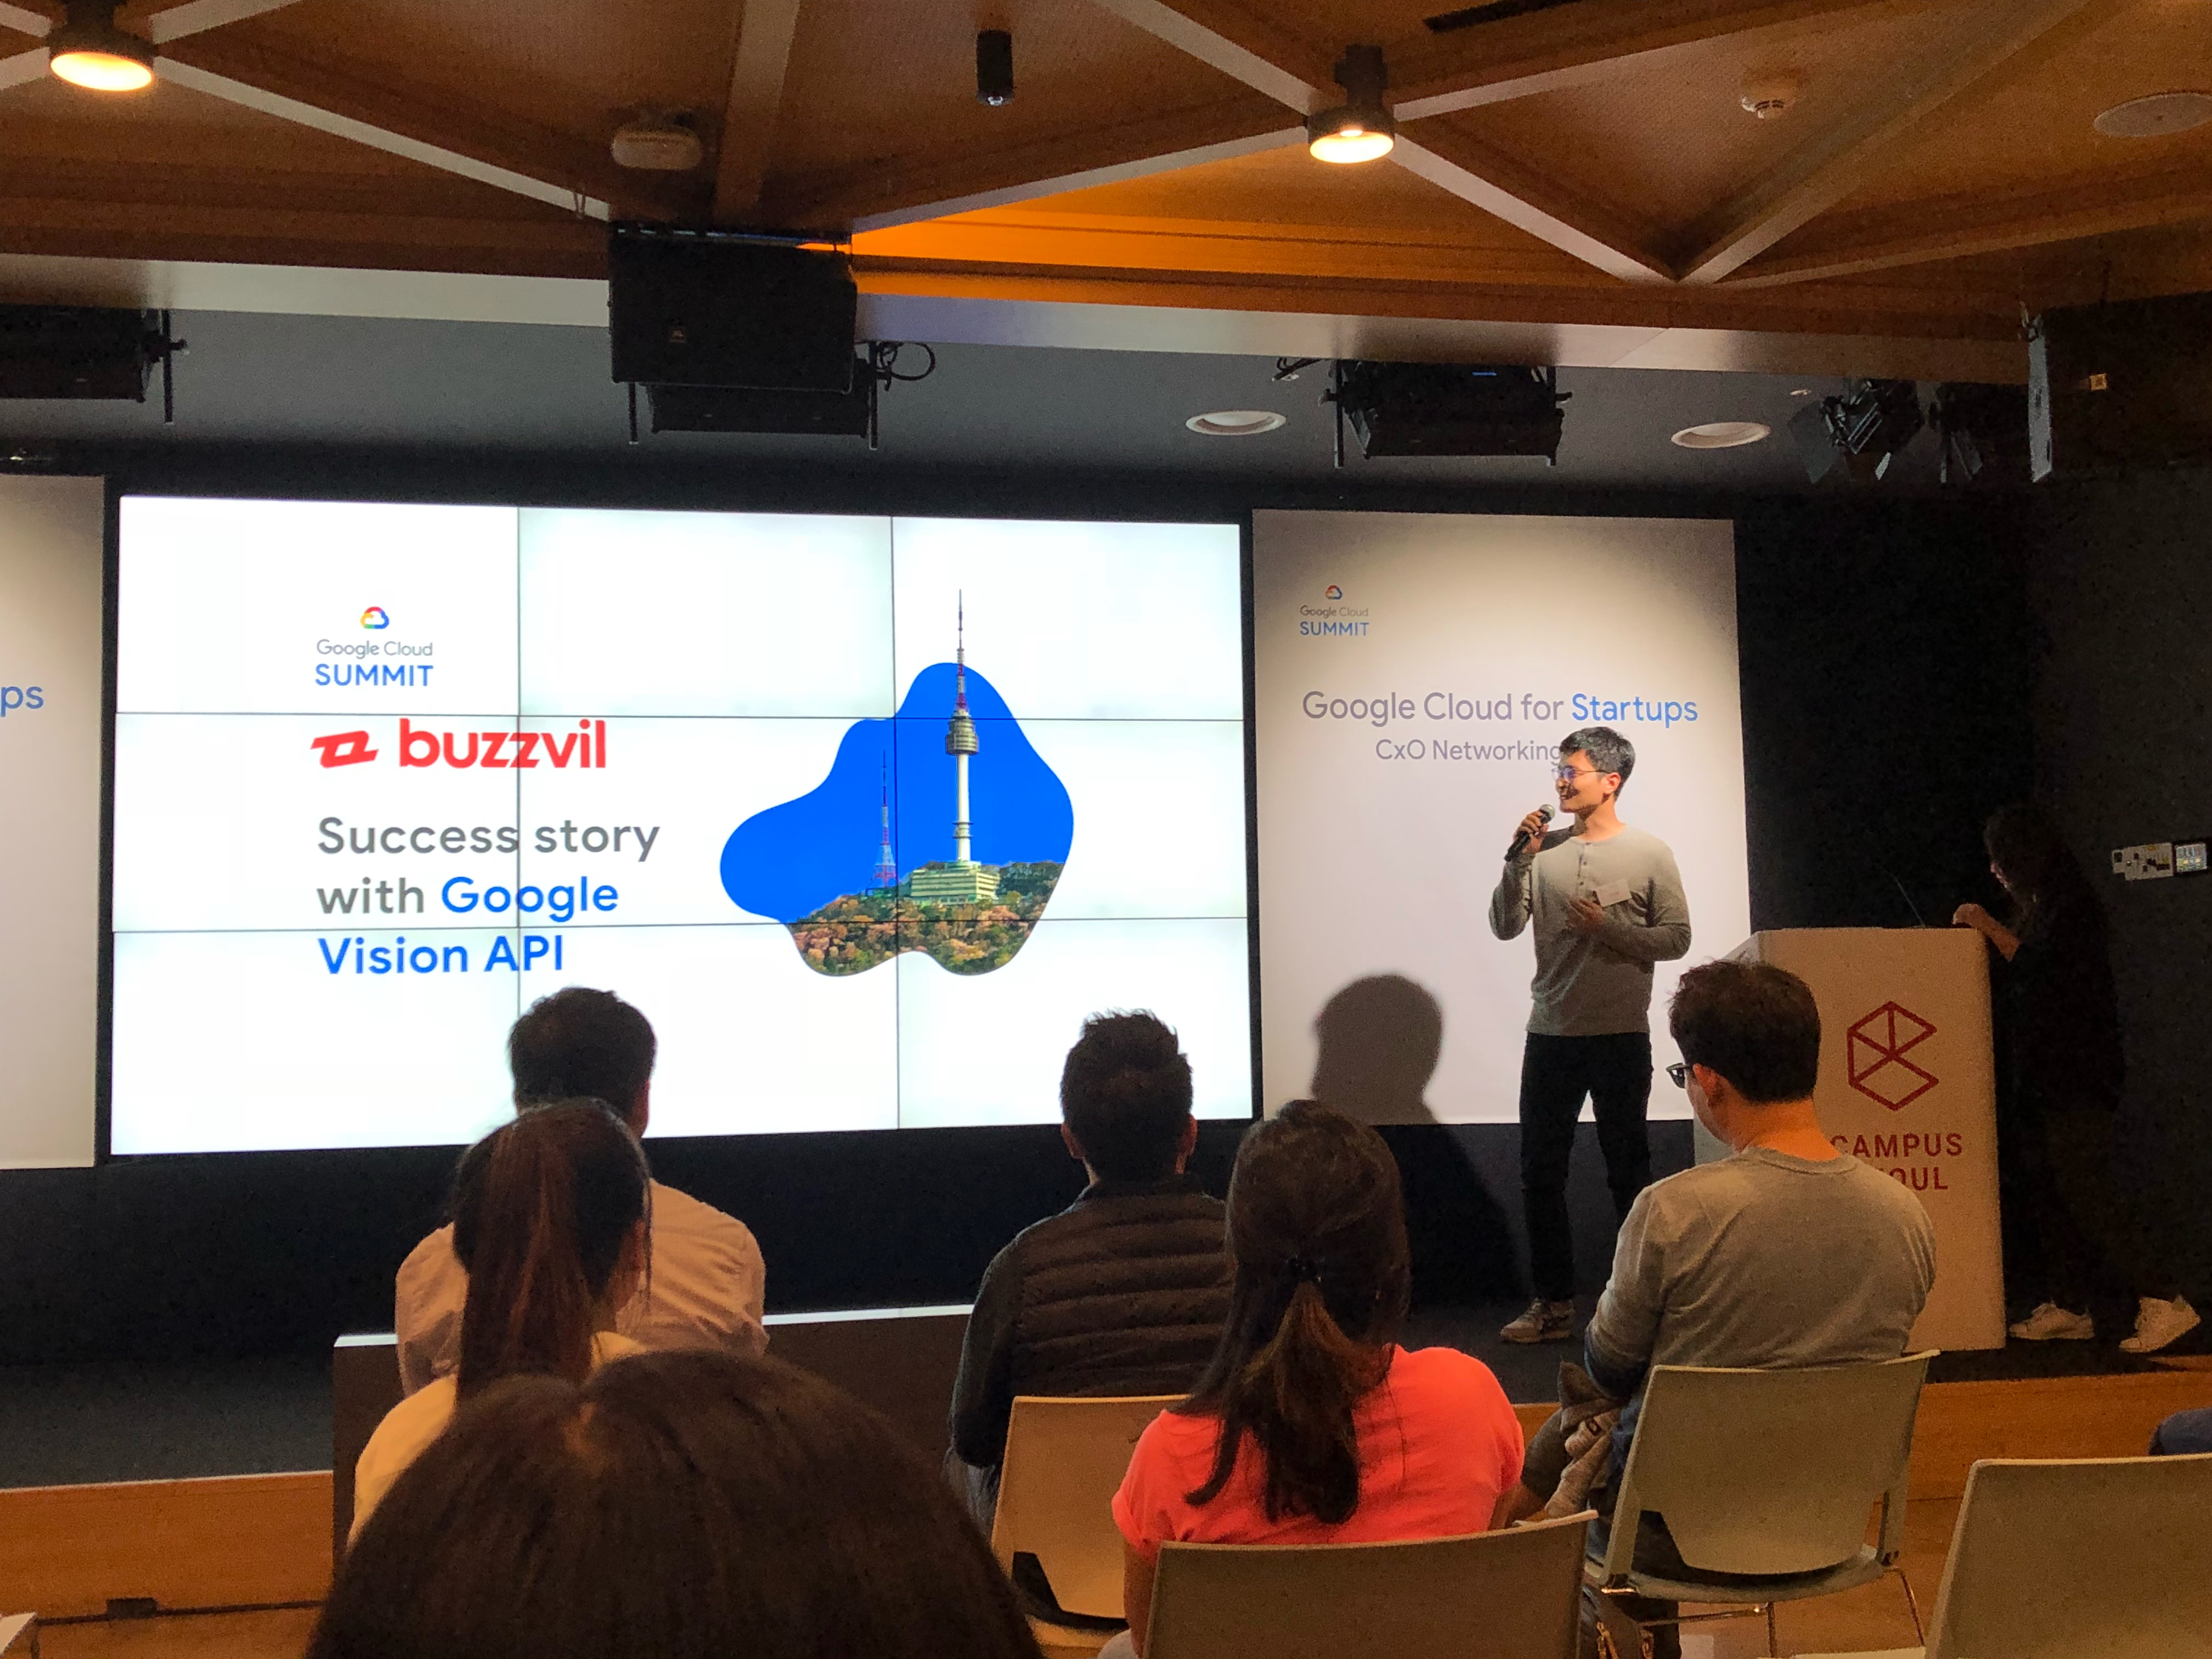
Buzzvil은 Google Cloud Vision으로 광고 이미지를 분석·분류해 유해 콘텐츠를 필터링했습니다. 안정성과 비용 효율성을 바탕으로 사용자 신뢰 유지를 지원합니다.
#Google Cloud Vision#이미지 분석
1900

Buzzvil은 Google Cloud Vision으로 광고 이미지를 분석·분류해 유해 콘텐츠를 필터링했습니다. 안정성과 비용 효율성을 바탕으로 사용자 신뢰 유지를 지원합니다.

모바일에서 라이브 동영상을 시청하며 상품을 구매하는 티몬 라이브 플랫폼 제작 경험을 소개했습니다. UX 디자이너로서 두 사용자 그룹을 고려한 프로젝트를 진행했습니다.

다음웹툰 Android 앱에 Animation, Transition, Custom View를 적용한 UX 설계·구현 과정을 소개했습니다. 디자인 분석부터 프로토타이핑과 튜닝, 사용자 피드백까지 다뤘습니다.
티몬 QE유닛의 단계별 테스트 접근과 협업 방식을 소개했습니다. 테스트 계획에서 대상·범위·일정·인력·수행 방법을 정의하는 과정을 다뤘습니다.

Django ORM Cookbook을 스터디하며 한국어 번역 문서를 오픈소스로 제작한 과정을 소개했습니다. Sphinx·Read the Docs 기반 빌드와 한글 PDF 변환 시 유의점을 정리했습니다.
파이썬으로 중첩 다이아몬드를 출력하는 코드 골프 문제 풀이를 공유했습니다. 문자 수를 줄이는 축약 기법과 가독성 저하의 특성을 함께 설명합니다.
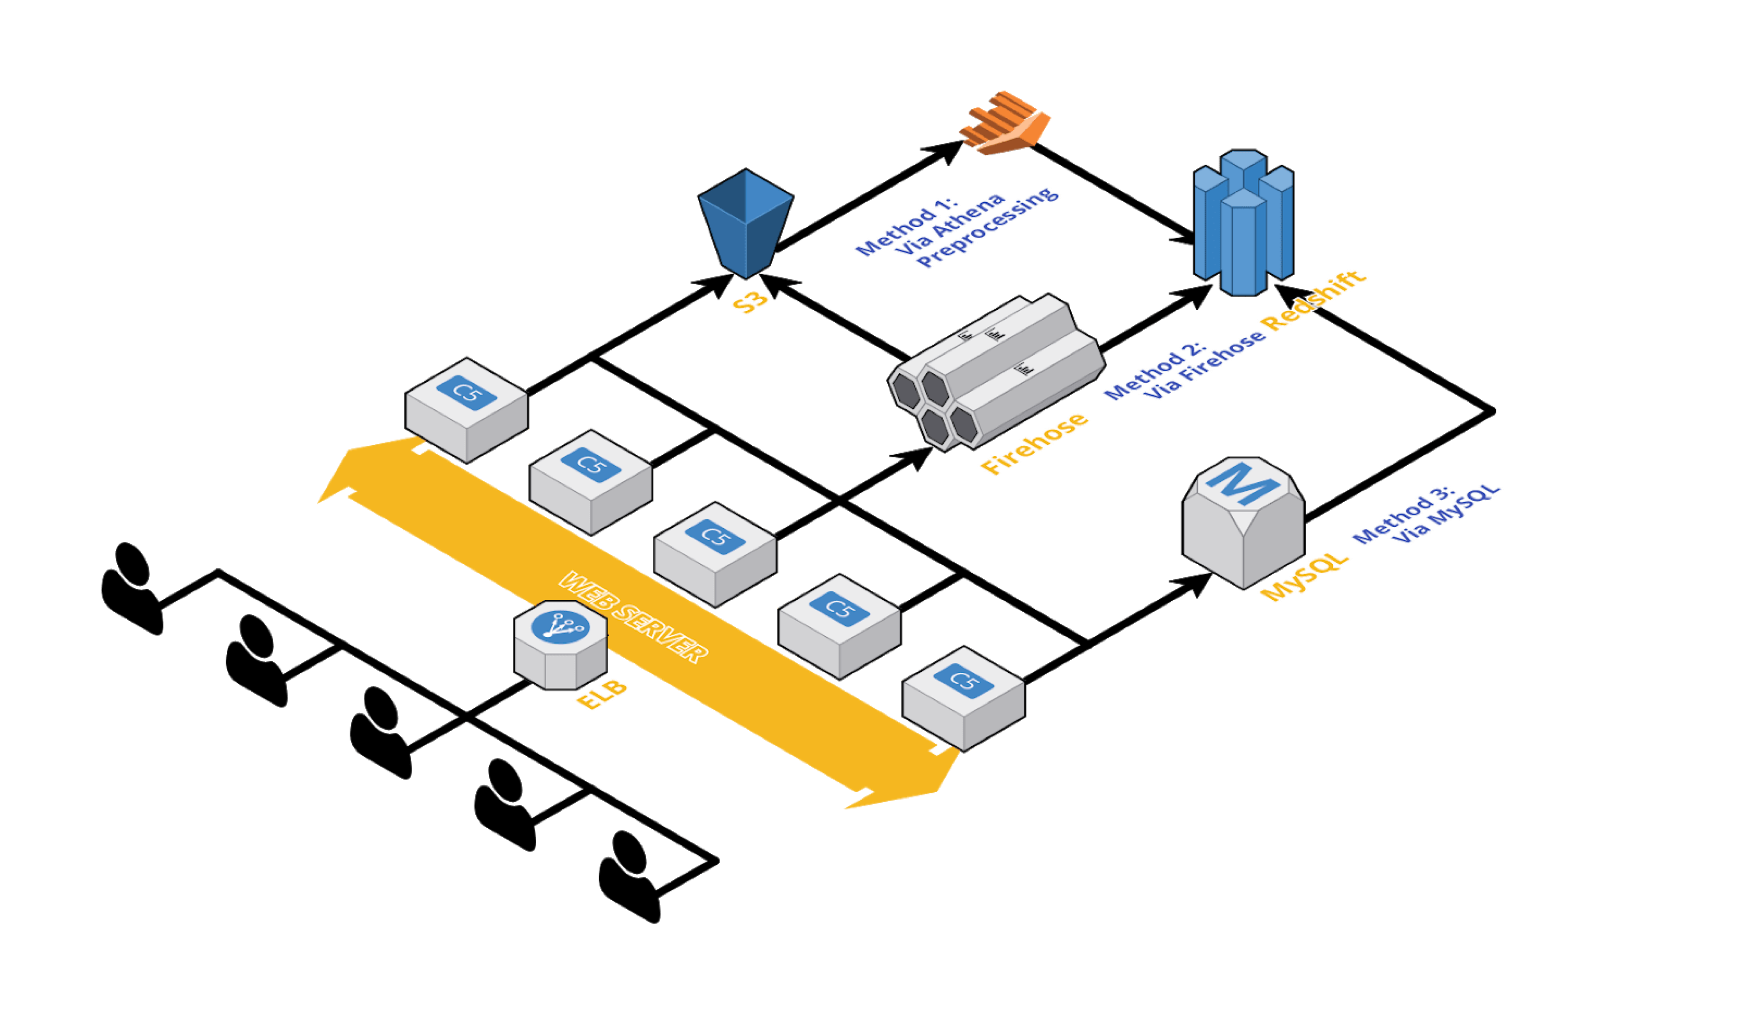
여러 저장소에 분산된 사용자·광고 활동 데이터를 Redshift로 통합하는 파이프라인을 소개했습니다. 컬럼형 저장, 빠른 적재, 수평 확장성을 핵심 선택 이유로 설명합니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
여러 국가의 유저 행동 및 광고 데이터를 다양한 저장소에서 수집하는 환경을 소개했습니다. 분석과 활용을 위해 분산 데이터를 한곳에 모으는 필요성을 설명합니다.

이용자 이벤트 로그를 개인화, 사용성 분석, 운영 이상 탐지에 활용하는 배경을 소개했습니다. 불필요한 로그와 개인정보를 줄이는 효율적 수집 원칙을 강조합니다.
모바일 프로덕트 개선을 위한 A/B 테스트 실무 경험을 공유합니다. 샘플 사이즈 산정과 결과 해석에서 자주 생기는 질문을 다룹니다.


Spark 로그 저장 포맷을 JSON에서 Parquet로 전환하고 인코딩 옵션을 조정했습니다. 저장 용량을 74% 줄이고 쿼리 성능을 10~30배 높였습니다.
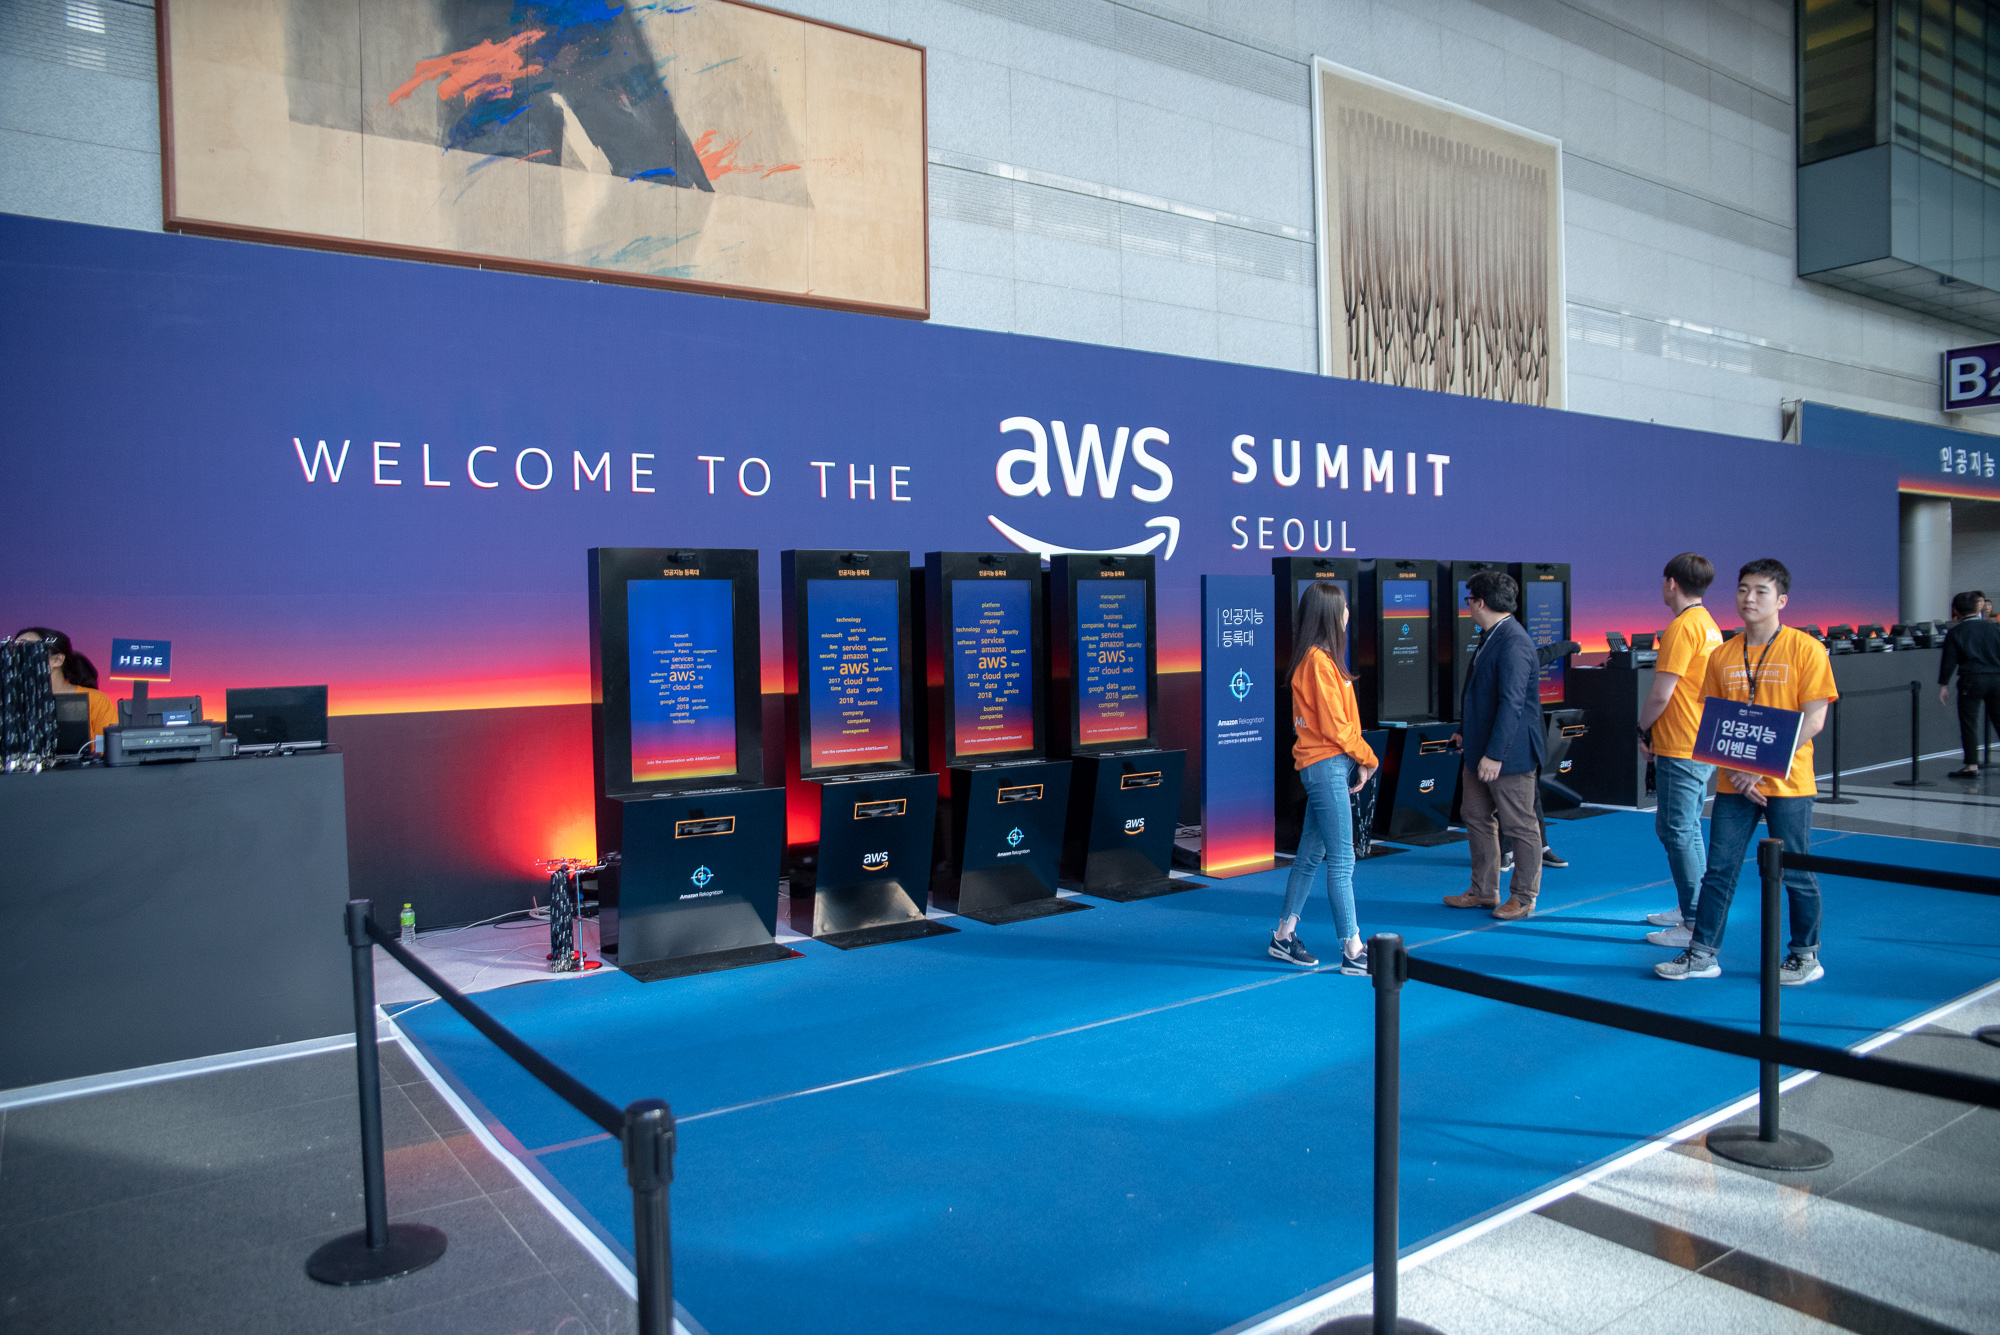
AWS Summit Seoul 2018의 행사 구성과 클라우드 기술 동향을 소개했습니다. 버즈빌의 다양한 AWS 인프라 활용 맥락도 함께 언급했습니다.
지속적 통합 도구로 Jenkins를 선택한 배경과 도입 맥락을 소개했습니다. Jenkins 작업 정의 방식이 문서마다 달라 발생하는 혼란을 다룰 예정입니다.
@Snapshot과 AOP로 메서드 요청·응답 데이터를 수집하는 로깅 방식을 제안했습니다. 메시지 큐와 Couchbase를 이용해 DB 기록을 비동기로 분리했습니다.