
백엔드
How We Pipe Data
두줄요약
여러 저장소에 분산된 사용자·광고 활동 데이터를 Redshift로 통합하는 파이프라인을 소개했습니다. 컬럼형 저장, 빠른 적재, 수평 확장성을 핵심 선택 이유로 설명합니다.
문제 상황
- 30여 개국 1,700만 명 이상 사용자 활동 데이터의 다중 소스·다중 저장소 분산
- 화면 활동, 광고 노출·클릭·전환 데이터의 서비스·플랫폼 간 통합 분석 필요
구조와 흐름
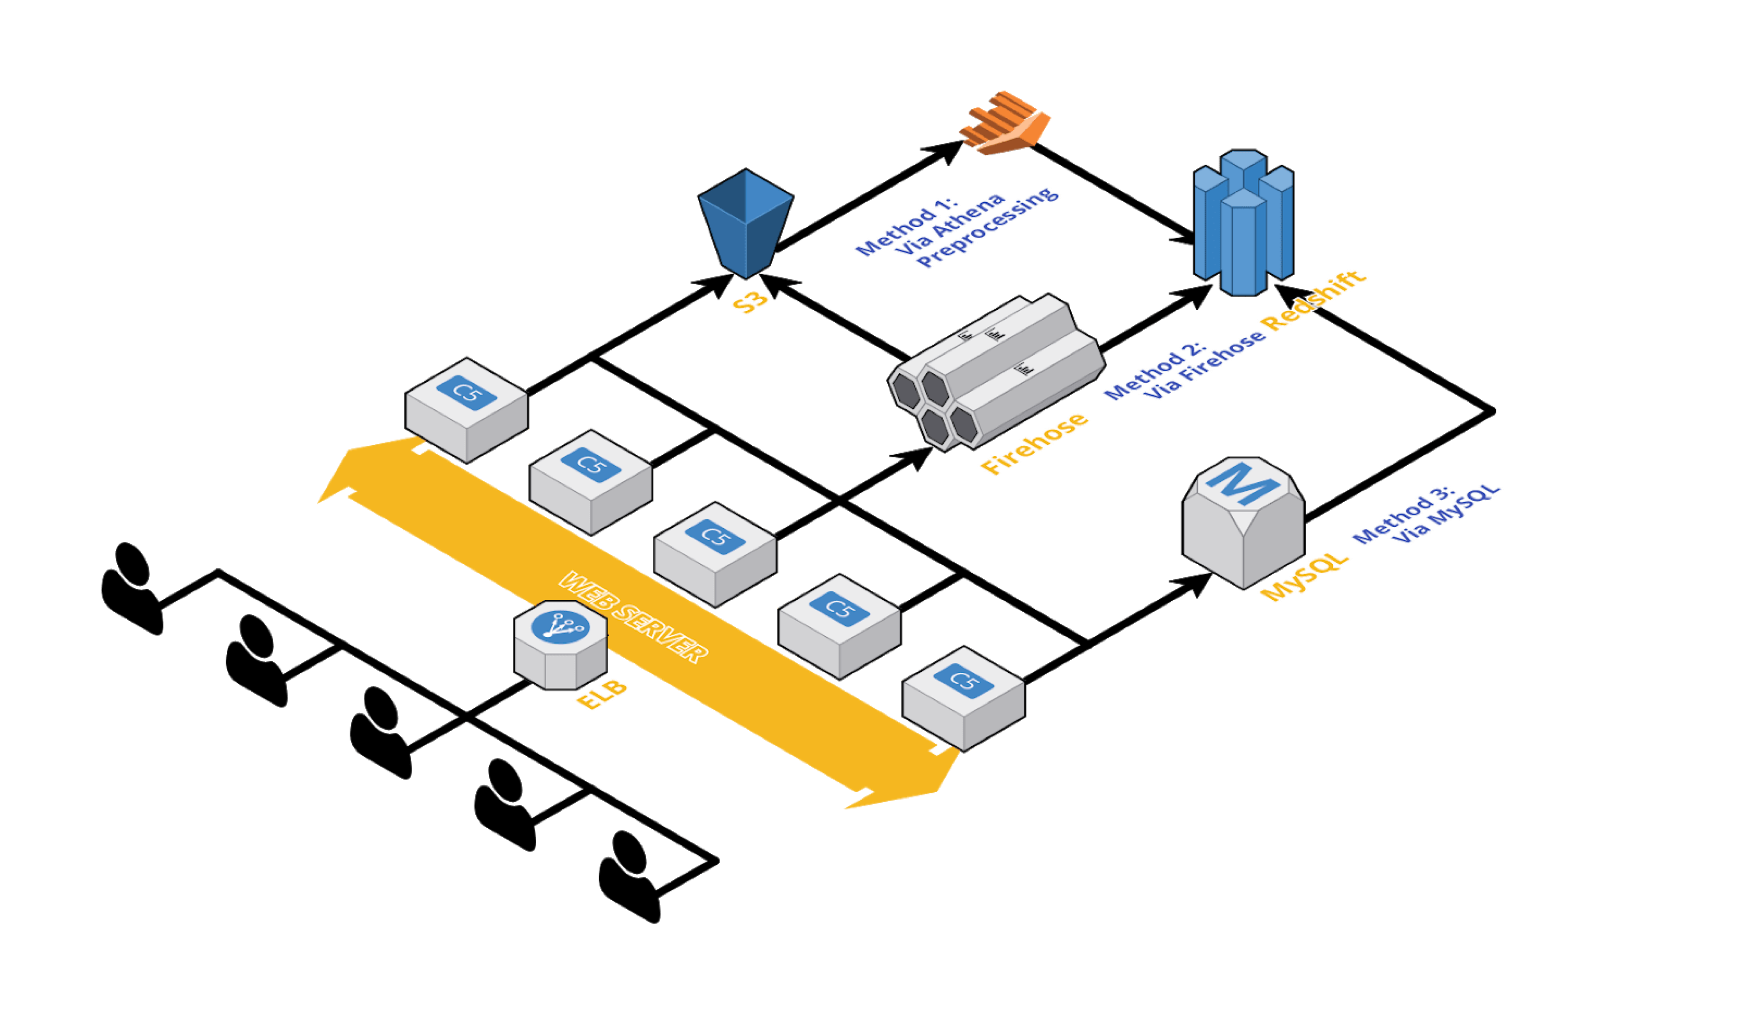
- MySQL, DynamoDB, Redis, S3 등 여러 소스 데이터를 단일 데이터 웨어하우스로 수집
- Redshift 기반 중앙 저장소에서 교차 서비스·교차 플랫폼 지표 분석
선택 이유
- 필요한 컬럼만 읽는 컬럼형 저장 구조와 조인·집계 중심 복합 쿼리 처리
- 빠른 데이터 적재와 노드 추가 기반 수평 확장
성능/운영 포인트
- 데이터 적재 후 인덱싱·정리 방식으로 신속한 수집
- 샤딩·클러스터링 복잡도 없이 노드 증설로 확장
