


[기술분석] AI 추론 메모리 병목과 서버 아키텍처 변화
장문 컨텍스트와 RAG, AI 에이전트 확산으로 추론 병목이 메모리와 데이터 이동 경로로 옮겨가고 있습니다. GPU 중심 설계보다 HBM, DRAM, SSD를 함께 보는 계층형 아키텍처가 중요하다고 설명했습니다.
#LLM#RAG
2100
장문 컨텍스트와 RAG, AI 에이전트 확산으로 추론 병목이 메모리와 데이터 이동 경로로 옮겨가고 있습니다. GPU 중심 설계보다 HBM, DRAM, SSD를 함께 보는 계층형 아키텍처가 중요하다고 설명했습니다.


Strands Agents와 Bedrock AgentCore로 발전설비 진단 보조 에이전트를 구성한 사례를 소개했습니다. 판단 절차와 데이터 조회를 분리하고 검색·응답을 따로 평가한 점이 핵심입니다.
딥테크 스타트업의 PoC와 AX 도입을 지원하는 가비아 AWS의 기술교류회 현장을 소개했습니다. Agentic AI 4-Layer 구조와 비용·마이그레이션 대응 방안을 함께 정리했습니다.

RAG가 기대만큼 답하지 못하는 문제를 다룹니다. 성공 요인을 LLM보다 문서 중앙화와 데이터에서 찾습니다.
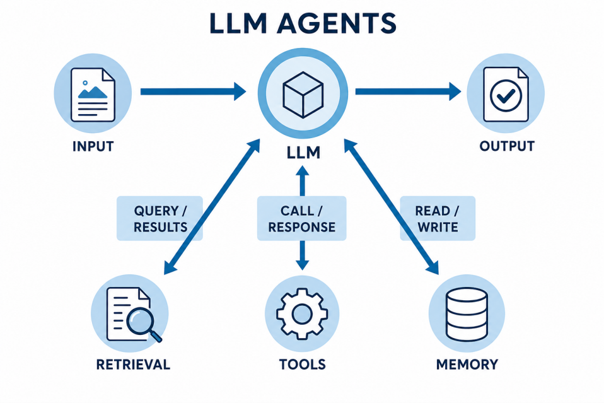

Notion과 Google Workspace를 활용해 가벼운 LLM 에이전트 구조를 제안했습니다. DAG·체크포인트·승인 게이트로 비용과 쓰기 작업을 통제합니다.

Aurora PostgreSQL에서 pgvector를 프로덕션 RAG에 운영하는 방법을 정리했습니다. HNSW 선택, 거리 함수, 메모리 계획, 관측성까지 실무 기준으로 설명했습니다.

토스 프론트엔드 팀은 문서를 찾는 대신 문서가 개발자에게 찾아오게 만드는 시스템을 구축했습니다. RAG 챗봇과 자동 문서화 봇으로 지식의 축적과 검색을 연결했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
LLM은 문서 유사성뿐 아니라 데이터 간 관계를 함께 활용할 때 더 유용해졌습니다. Graph DB는 이런 관계 정보를 제공해 GraphRAG와 AI Agent의 탐색 범위를 넓혀줬습니다.

토스증권은 추천을 배치 중심에서 실시간 루프로, 검색을 키워드 기반에서 RAG와 그래프 RAG로 확장했습니다. 모델 성능뿐 아니라 데이터 갱신, 후보 선택, 운영 관측이 품질을 좌우한다고 정리했습니다.
글로벌 상담 AI Agent의 메인 모델을 GPT-5.6 Luna로 바꾼 이유를 자체 벤치마크로 설명했습니다. 공개 리더보드보다 실제 워크로드에서의 품질, 비용, 속도를 함께 보고 전환했습니다.

사내 지식을 활용한 Agentic RAG 구축의 첫 단계로 RAG 파이프라인의 기반을 다지는 내용을 다뤘습니다. 발췌상 사내 공통플랫폼 맥락에서 RAG 설계와 적용을 정리한 글로 보입니다.

보안 업무에 AI를 적용할 때 사람의 판단을 남기고 AI는 1차 정리와 근거 수집을 맡기는 SAGE 플랫폼 설계를 소개했습니다. 3개 진입점과 멀티 에이전트, RAG, MCP, 피드백 루프로 운영하는 방식도 정리했습니다.

사내 지식이 흩어진 문제를 MCP 게이트웨이로 통합하고, 검색 전 권한 통제와 감사 체계를 먼저 설계했습니다. 초기에는 온프렘으로 시작해 이후 AWS 관리형 서비스로 단계적으로 이전했습니다.

AI Agent 검색 품질을 OpenSearch와 Bedrock으로 정량 평가하는 방법을 다루었습니다. NDCG와 Recall, LLM Judge 검증, BM25·시멘틱·하이브리드 비교 결과를 함께 설명했습니다.