
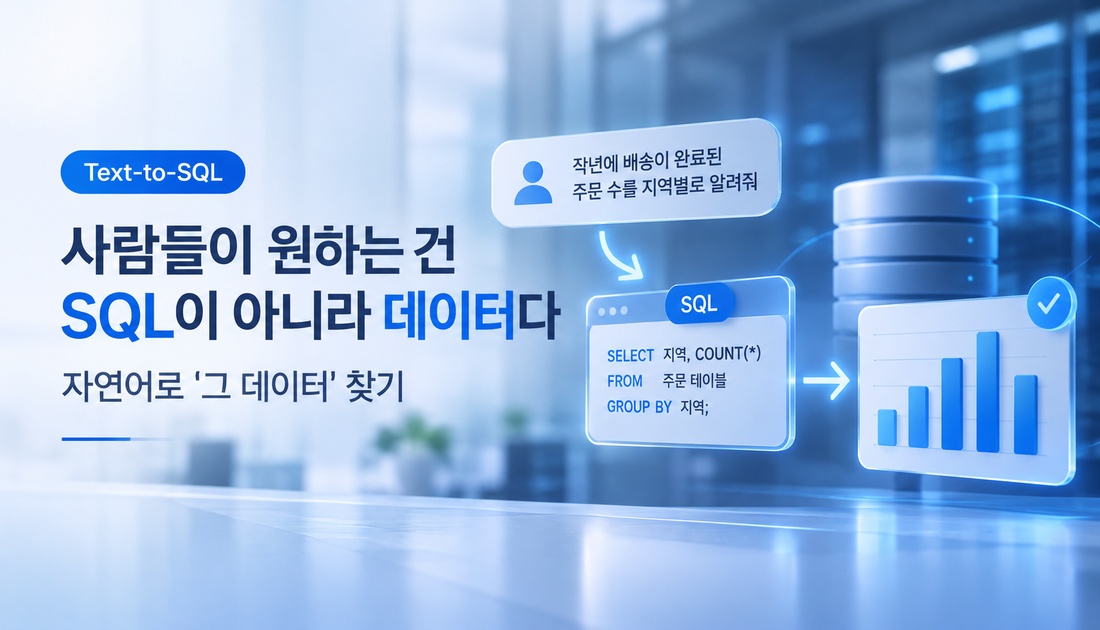

사람들이 원하는 건 SQL이 아니라 데이터다: 자연어로 ‘그 데이터’ 찾기
Text-to-SQL의 핵심 난제가 SQL 문법이 아닌 스키마 링킹임을 설명했습니다. 데이터 사전·관계 정보·예시 쿼리 정비와 안전한 운영 방안을 제안합니다.
#LLM#SQL
300
Text-to-SQL의 핵심 난제가 SQL 문법이 아닌 스키마 링킹임을 설명했습니다. 데이터 사전·관계 정보·예시 쿼리 정비와 안전한 운영 방안을 제안합니다.
FastAPI 기반 상담 지원 서비스의 검색·답변·기록 흐름을 책임과 자원 수명 기준으로 분리했습니다. 컨테이너, 권한 검증, 부분 실패, 관측과 테스트의 운영 원칙을 설명합니다.
고객 컨택 AI Agent의 검색·질의·저장 흐름을 API 계약과 상담 시나리오 관점에서 검증하는 방법을 정리했습니다. 테스트 더블·통합 테스트·품질 회귀를 분리하고 CI 배포 기준으로 함께 운영합니다.
프로모션 검색과 상세 질의를 분리해 혜택·기간·제외 조건의 근거를 함께 확인하는 흐름을 설계했습니다. 문서 개정, 권한, 기간, 품질 지표를 검증해 상담 오안내를 줄이는 방법을 설명합니다.
문서 저장·게시·검색 반영을 분리하고 식별자와 게시 스냅샷으로 최신성을 검증하는 흐름을 설명했습니다. Databricks Delta Sync 상태, 행 수, 대표 질의를 함께 확인해 빈 결과와 철회까지 관리합니다.
업무 질문 기반 골든셋으로 검색 근거의 충족도와 순서 품질을 분리 평가하는 방법을 설명합니다. 실패·누락·핵심 예외 문항을 함께 기록해 변경 전후를 비교합니다.
문서 분할에서 제목·표·예외·출처를 보존해 검증 가능한 검색 근거를 만드는 방법을 설명했습니다. 검색용 조각과 계층 문맥을 분리하고 질문별 근거 완전성으로 평가해야 합니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
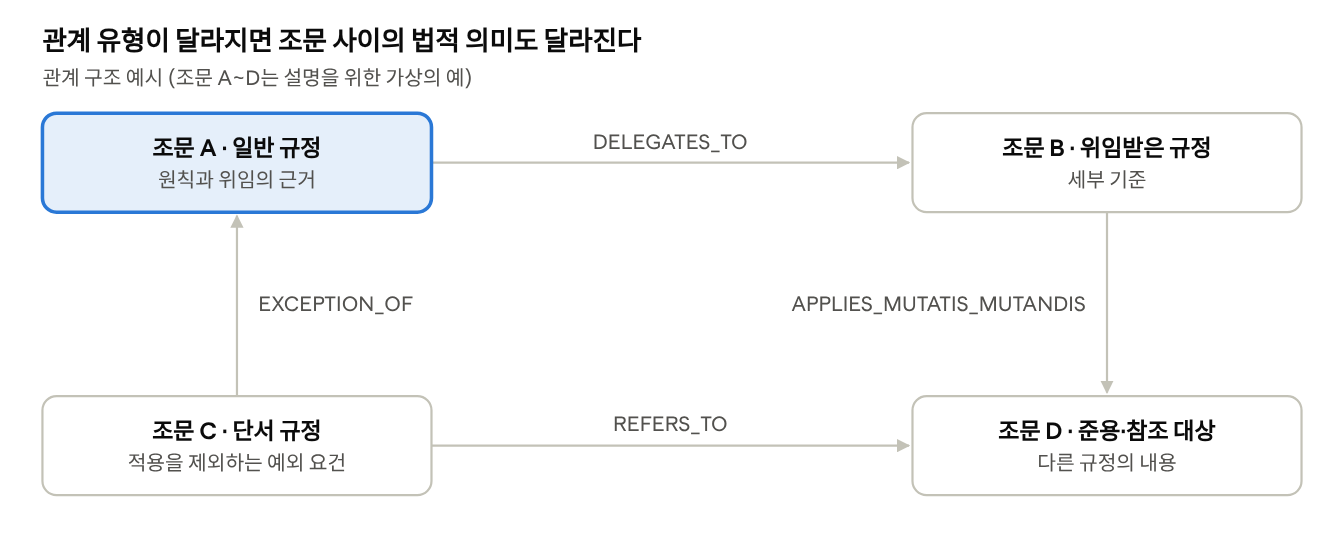
법규정의 위임·예외·준용 관계를 지식그래프로 구조화한 GraphRAG 상담서비스 설계를 설명했습니다. 질문 유형에 따라 검색 전략을 나누고 근거·관계 품질을 검증하는 방안을 제시합니다.
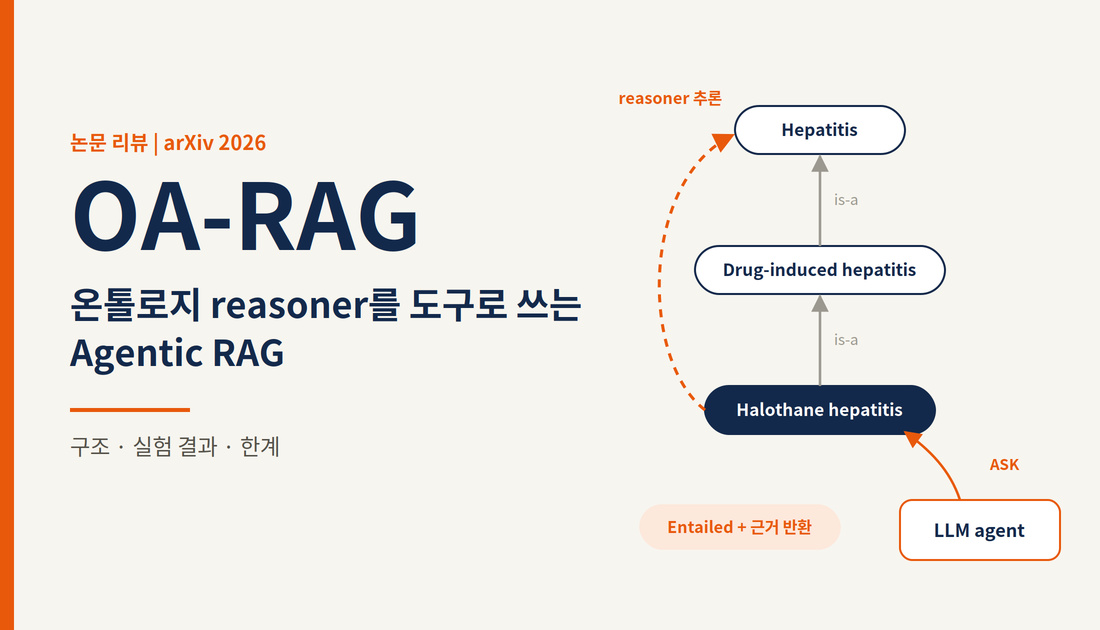
OA-RAG의 온톨로지 reasoner·LLM 결합 구조와 실험 결과를 분석했습니다. 의료 QA의 효율성과 평가 편향, grounding 신뢰도 한계를 함께 짚었습니다.
QA 테스트 설계의 기준을 문서 추측에서 운영 코드와 커밋 근거로 전환했습니다. 하네스와 RAG 기반 코드 탐색으로 분석 절차를 표준화하고 설계 기간을 줄였습니다.
확산형 언어모델의 병렬 토큰 예측·반복 정제 방식과 블록 생성, 토큰 편집을 설명했습니다. 도입 시 TPS뿐 아니라 첫 응답 지연, 품질, 비용을 같은 조건에서 비교해야 합니다.
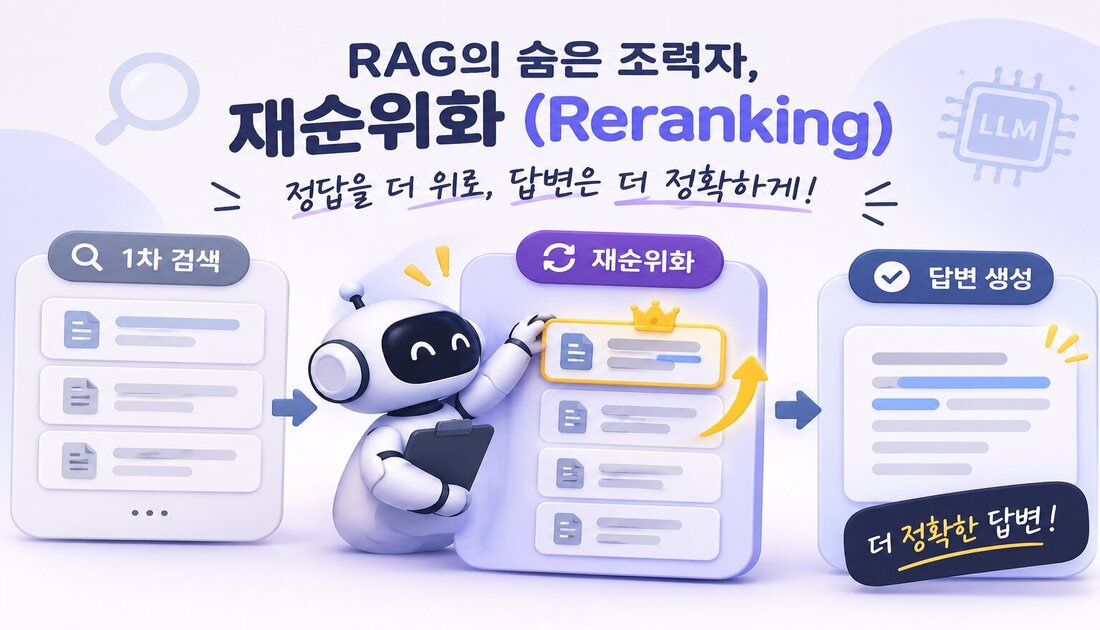
RAG 재순위화의 구조와 기술 발전, 운영 설정, 모델 선정 기준을 정리했습니다. 한국어 기업 문서 실험으로 정확도·속도·GPU 비용의 차이를 비교했습니다.
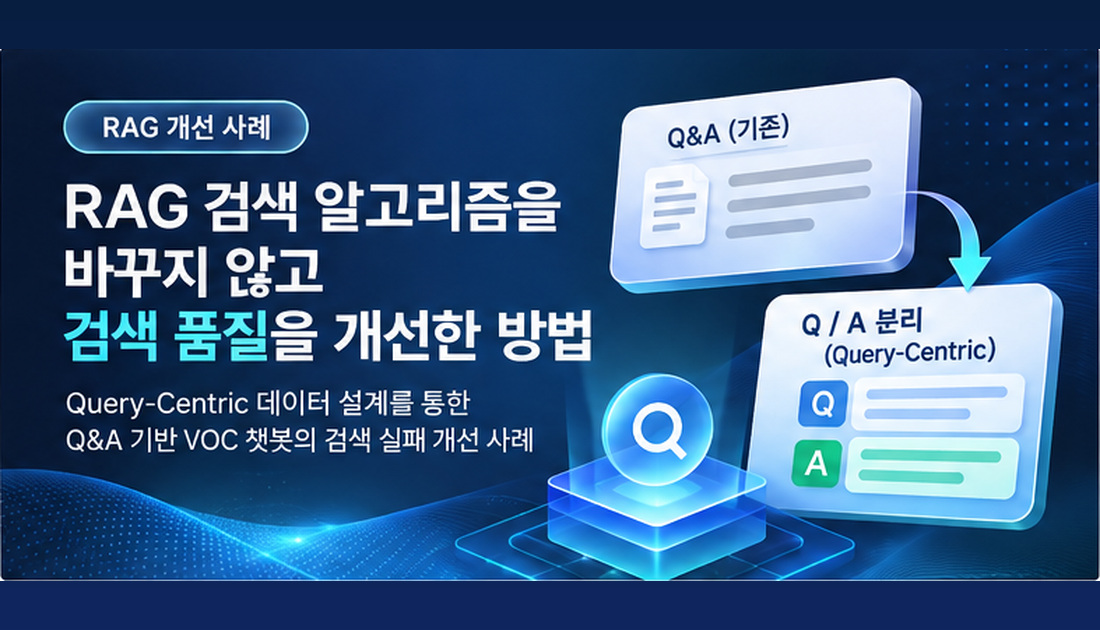
RAG 알고리즘을 유지한 채 질의 중심 인덱스와 답변 DB 분리로 Q&A 검색 노이즈를 줄였습니다. BM25·KNN·RRF의 후보 품질과 운영 검증 기준을 설명합니다.
AI 문서의 작성 과정이 개인 계정에 남아 자산화와 인수인계가 어려운 문제를 짚었습니다. 재사용 가치가 높은 자료부터 저장·검색·권한 기준을 단계적으로 마련해야 합니다.