
Kafka Connect로 DB 데이터 쉽게 연동하기
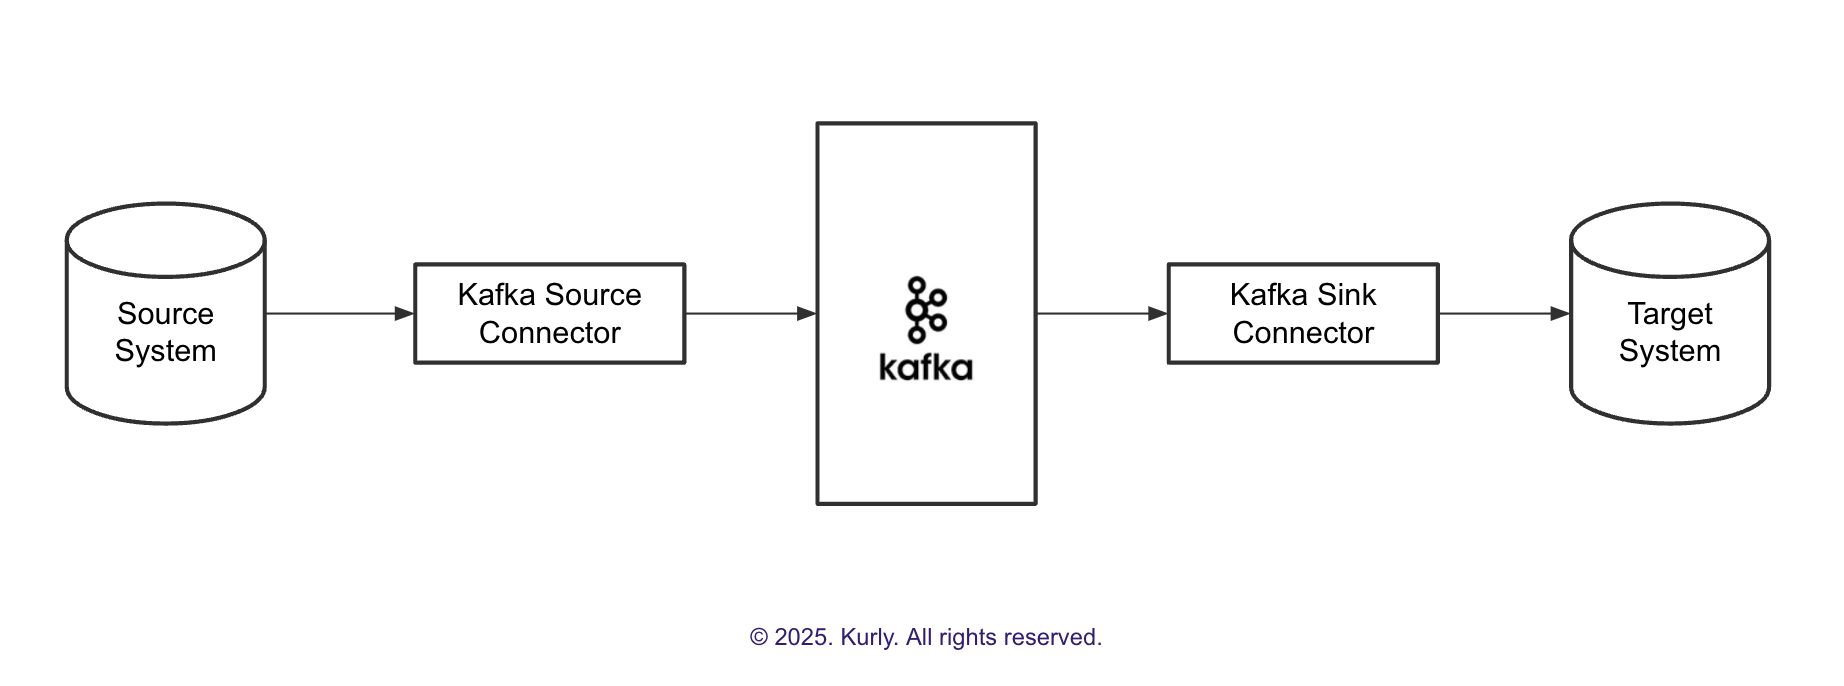
Kafka Connect와 JDBC Source Connector로 DB 데이터를 Kafka에 연동하는 구조와 증분 쿼리 모드를 설명했습니다. 쿼리 기반 CDC의 누락 사례와 지연 옵션을 통한 완화 방법을 정리했습니다.
#Kafka#Kafka Connect
700
Kafka Connect와 JDBC Source Connector로 DB 데이터를 Kafka에 연동하는 구조와 증분 쿼리 모드를 설명했습니다. 쿼리 기반 CDC의 누락 사례와 지연 옵션을 통한 완화 방법을 정리했습니다.
Kafka Connect와 JDBC 소스 커넥터로 DB 데이터를 Kafka에 연동하는 방법을 설명했습니다. 쿼리 기반 CDC의 한계와 데이터 누락을 줄이는 설정도 함께 정리했습니다.
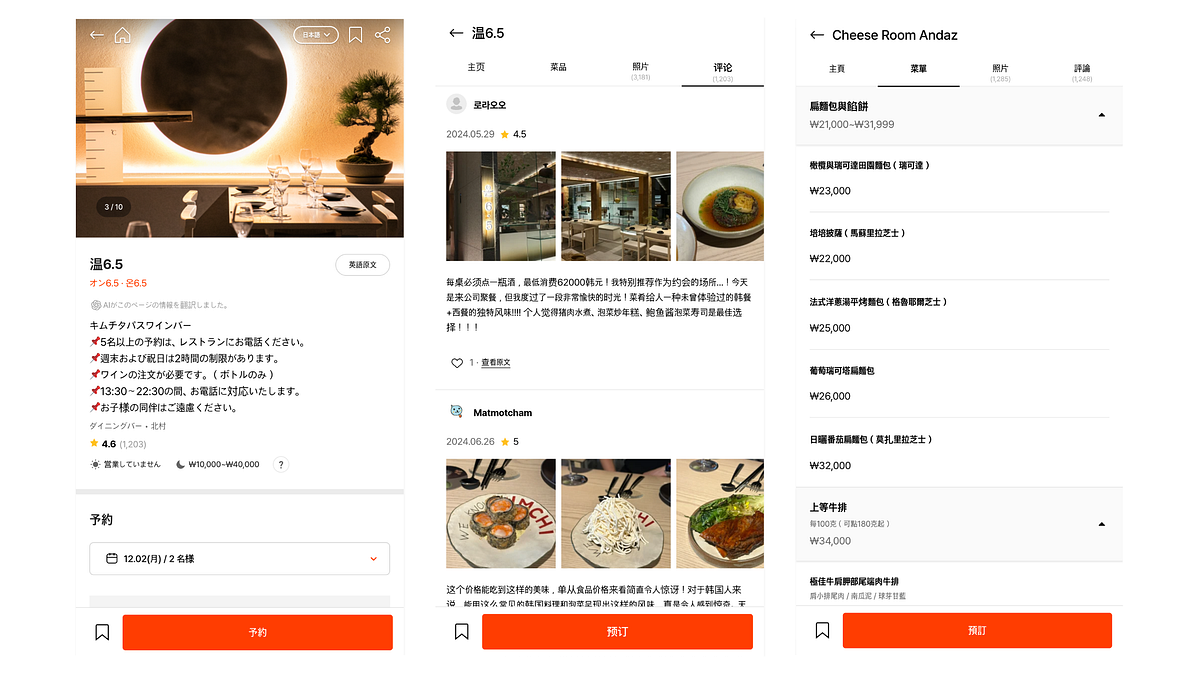
캐치테이블 글로벌은 번역 마이크로서비스와 검수 어드민을 도입해 다국어 레이어를 구축했습니다. 또한 AWS DMS CDC와 Kafka를 활용해 기존 도메인 변경을 중앙에서 번역 요청하도록 설계했습니다.
트랜잭션 롤백과 중복 조회에 의존하던 CDC의 한계를 짚고, QueryPie의 쿼리 시뮬레이션 기반 접근을 소개했습니다. DBMS 부하를 줄이면서도 변경 전후 데이터를 확보하는 구조와 효과를 설명했습니다.
트랜잭션 롤백에 의존하던 CDC의 성능 저하와 DBMS 종속성 문제를 다뤘습니다. QSI 기반 쿼리 시뮬레이션으로 변경 전후 데이터를 생성해 부하를 줄인 방식을 소개했습니다.
트랜잭션 기반 CDC의 롤백 부하와 DBMS 종속성 문제를 정리하고, QSI 쿼리 시뮬레이션으로 이를 대체하는 방법을 소개했습니다. 트랜잭션 없이 변경 전후 데이터를 생성해 성능과 확장성을 높인 사례를 설명했습니다.

Iceberg를 DataLake에 도입해 Kafka·CDC 입수와 테이블 운영을 더 효율적으로 개선했습니다. 또한 자동화된 모니터링과 유지보수로 실시간 조회와 성능 최적화를 함께 달성했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
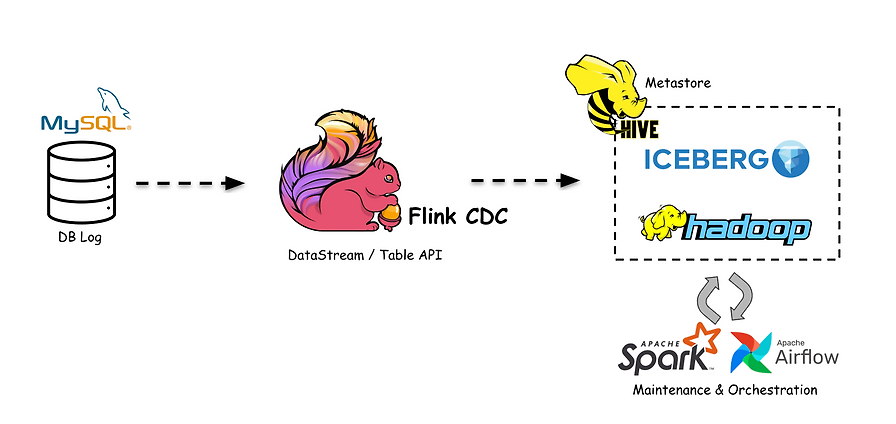
Apache Iceberg와 Flink CDC를 다루는 심층 탐구 글입니다. 발췌만으로는 구체적 내용 확인이 어려워 핵심 주제만 요약했습니다.

아파치 플링크와 CDC를 함께 살펴보는 맛보기 글입니다. 데이터 취합과 일단위 지표 추출 맥락에서 주제를 소개합니다.
대용량 이미지 데이터를 MySQL에서 MongoDB로 마이그레이션한 경험을 공유했습니다. Kafka, ETL, CDC를 조합해 동기화와 샤딩 최적화, 안정적 전환까지 진행했습니다.

헤드리스 CMS에서 다국어와 연관 관계를 고려한 CDC 설계 경험을 공유했습니다. 순서 보장과 트랜잭션 분리를 통해 대량 변경을 안정적으로 처리했습니다.

Debezium 기반 CDC 파이프라인의 운영 지표와 개선 방법을 정리한 글입니다. end-to-end 지연, 처리량, 확장성 개선으로 생성과 복구 시간을 줄인 사례를 소개했습니다.

토스증권이 실시간 데이터 처리 플랫폼으로 ksqlDB를 선택한 이유와 운영 경험을 소개했습니다. 동시 접속 집계, 이상 탐지, CDC 조인, ML feature 생성 사례와 함께 장단점도 정리했습니다.

6개 도메인을 하나의 통합 모델로 옮기기 위해 Kafka, CDC, Kafka Streams 기반 마이그레이션 파이프라인을 구축했습니다. Strimzi Operator로 Kafka Connect를 관리하며 준실시간 데이터 통합과 재실행 가능성을 확보했습니다.