


Spring Boot 4.1까지 나온 지금, 무엇이 바뀌었고 무엇을 먼저 준비해야 할까요
Spring Boot 4 이행 시 자동 설정 분리와 Jackson 3 전환으로 발생하는 호환성 문제를 정리했습니다. 특히 JSON 직렬화 비교와 컨텍스트 로딩 테스트를 사전 안전장치로 권장했습니다.
#Spring Boot#migration
10800
Spring Boot 4 이행 시 자동 설정 분리와 Jackson 3 전환으로 발생하는 호환성 문제를 정리했습니다. 특히 JSON 직렬화 비교와 컨텍스트 로딩 테스트를 사전 안전장치로 권장했습니다.
Spring AI로 사내 REST API를 MCP 도구로 노출하는 서버 구축 과정을 정리했습니다. 프로토콜 처리는 위임하고 도구 설계·설명·인증을 핵심 과제로 제시했습니다.
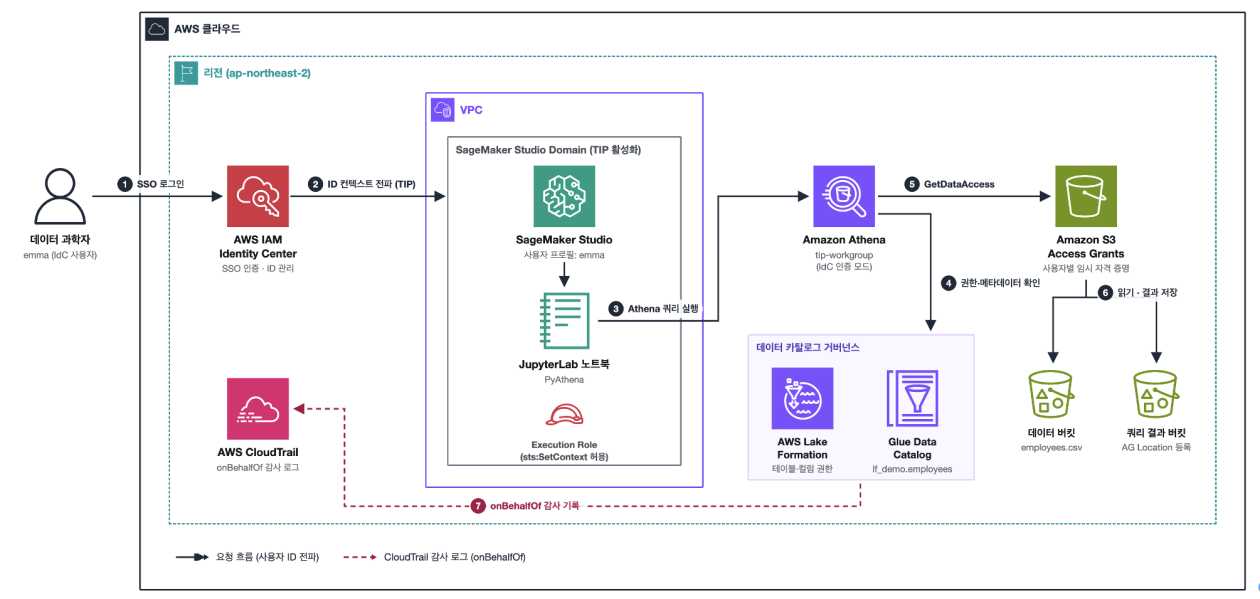

SageMaker Studio의 TIP로 사용자 ID를 Athena·S3·Lake Formation까지 전파하는 구성을 안내했습니다. S3 Access Grants와 CloudTrail을 통해 사용자별 권한 제어 및 감사 추적을 구현했습니다.
공유 API 유무와 성능 이슈를 기준으로 MS 간 도메인 참조 방식을 구분했습니다. 기본은 ID 참조이며, 성능 문제가 확인될 때만 표시용 VO 동기화를 검토합니다.
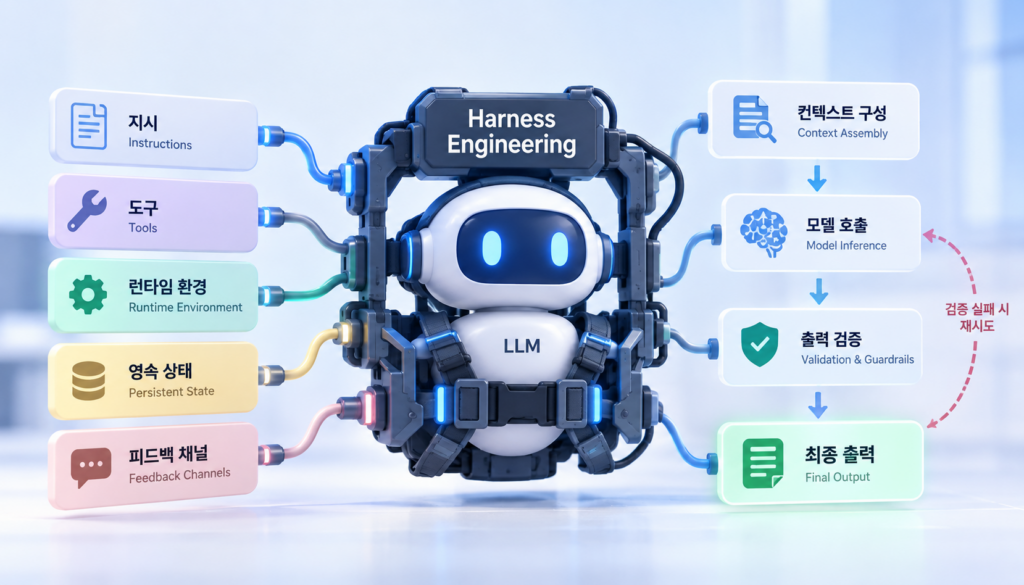

하네스 엔지니어링은 LLM 에이전트의 지시·도구·검증·상태를 코드로 설계하는 접근입니다. 모델 교체와 무관한 규약 강제와 실패 추적·복구 방식을 설명합니다.

AI 에이전트 도입 전 최신 문서, 접근 권한, 변경 이력을 통합 관리해야 하는 이유를 설명했습니다. 문서중앙화를 통해 잘못된 정보 참조와 권한 침해, 근거 추적 불가 위험을 줄이는 방안을 제시합니다.


AI 데이터센터의 전력 병목과 발전·송배전·계통 접속 구조를 설명했습니다. 입지 분산, 자체 전원, 수요반응, 효율 개선 대응책을 정리했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
실제 AI 제품에서는 모델 성능뿐 아니라 검색 품질과 속도, 사용자 경험까지 함께 고려해야 합니다. 이번 밋업에서는 자체 모델 학습과 검색엔진 고도화 사례를 공유합니다.
Swift Concurrency의 executor와 hop_to_executor 동작을 런타임 소스로 살펴본 글입니다. executor는 job을 실행하는 추상화이며, 스레드 폭증을 막고 hop은 대부분 스레드 전환이 아니라고 정리했습니다.

AWS Elastic Disaster Recovery로 온프레미스 21대 서버의 DR 환경을 구축한 사례를 정리했습니다. 복제, 부팅, 서비스 단계의 이슈와 서버별 복구 목표 설정 과정을 공유했습니다.

Amazon EKS와 NVIDIA FLARE로 연합학습을 구성하는 방법과 CSE 평가 흐름을 설명했습니다. 세 가지 데이터 시나리오를 통해 전역 모델의 수렴, 일반화, 운영상의 관찰 포인트를 보여주었습니다.
AI 시대의 진짜 자산은 모델이 아니라 현장에서 쌓이는 도메인 데이터와 하네스라고 설명했습니다. 업의 본질은 그대로지만, 프로세스를 바꾸는 힘이 경쟁력을 만든다고 정리했습니다.
LLM이 만든 결과를 그대로 믿지 않고, JSON Schema와 Validator로 원문 근거를 검증하는 구조를 소개했습니다. 누락은 질문으로 남기고, 오류 응답과 실행 기록을 보존해 회귀 평가에 활용했습니다.
LLM 기능을 단순 연결하는 대신 Workflow Loop와 Domain Adapter로 판단과 실행 책임을 분리했습니다. 사용자 Interaction과 스냅샷 승인까지 구조화해 Agentic Workflow의 재개와 검증을 안정화했습니다.