
데이터 소재지와 데이터 주권
데이터 소재지·지역화·주권의 차이를 저장 위치와 관할권 관점에서 정리했습니다. 주권 확보를 위해 운영 주체, 키 관리, 네트워크 경로까지 검토해야 합니다.
#데이터 주권#데이터 소재지
2500
데이터 소재지·지역화·주권의 차이를 저장 위치와 관할권 관점에서 정리했습니다. 주권 확보를 위해 운영 주체, 키 관리, 네트워크 경로까지 검토해야 합니다.


AI 서비스 운영을 위한 AIDC 전력·클라우드·Composite AI 전략을 소개했습니다. RAG, 모델 선택, 추론 메모리 최적화와 MCP 활용 방안도 다뤘습니다.

에이전트 개발에서 혼용되는 워크플로우, 하네스, Context·Memory, MCP·A2A 개념을 정리했습니다. 원문 명세와 실제 구현체를 바탕으로 팀의 용어 혼선을 줄이는 내용을 공유합니다.
독립적으로 발화하는 웹뷰·OS 오버레이를 Promise 기반 우선순위 큐로 직렬화했습니다. 큐와 로컬 시퀀서의 책임을 분리해 순서 변경과 검증 복잡도를 낮췄습니다.

AI가 코드를 빠르게 작성하는 환경에서 핵심 병목이 검증으로 이동했음을 두 프로젝트 사례로 설명했습니다. CI, 시각 회귀, MCP 기반 실행 검증으로 배포 확신을 만드는 방식을 제시했습니다.

적금 재방문을 높이기 위해 9종 다람쥐 캐릭터와 성장 중심 UI를 설계했습니다. AI 시안 탐색과 즉각적인 인터랙션으로 저금의 보람과 다음 방문 동기를 만들었습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
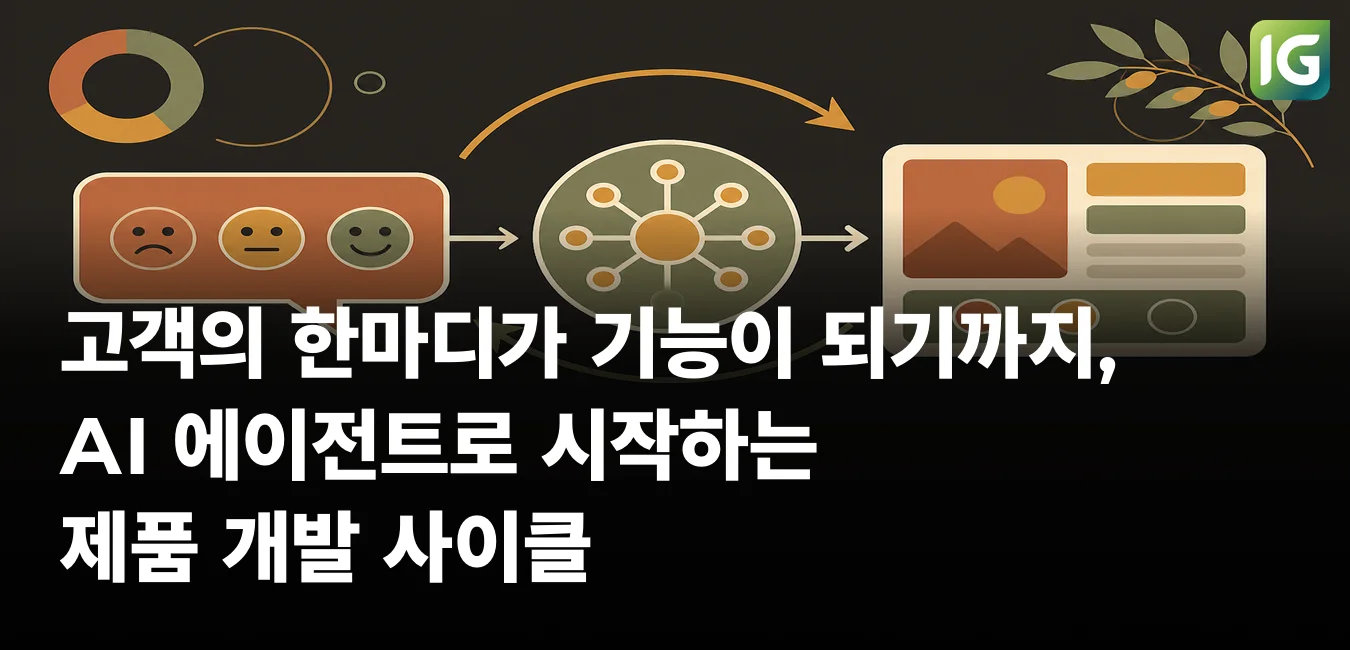
Nelper는 Slack의 고객 요구사항을 AI 에이전트로 구조화해 구현·검증·배포·문서화까지 연결했습니다. 반복 실행은 자동화하고 제품 우선순위와 최종 판단은 사람이 맡았습니다.
Jev를 원고 교정·문체 탐지·자동 발행 점검에 적용해 조건부 활용 방식을 검증했습니다. 문단 판정은 Jev, 반복 규칙은 코드, 사실 검증은 별도 단계로 분리해야 합니다.
이미지 토큰 편차로 발생한 멀티모달 학습 GPU 부하 불균형을 분석했습니다. Pack 재배치와 통신 오버랩으로 품질 저하 없이 처리량을 13.3% 높였습니다.
Hive 4.2에서 제거된 get_table RPC로 Spark 잡이 실패한 원인을 추적했습니다. Thrift IDL 계약을 보존한 RPC 복원과 생성 코드 검증 방식을 정리했습니다.

AWS에서 VLA·강화학습용 Physical AI 학습, 시뮬레이션 검증, 엣지 배포 파이프라인을 구성했습니다. 학습 특성에 따라 SageMaker Pipelines·HyperPod를 선택하고 Greengrass로 모델을 배포합니다.
국내 보안 AI·국방 AX·사우디 디지털트윈·B200 커널 최적화 소식을 소개했습니다. 보안 현장 실증과 GPU 맞춤 최적화로 AI 활용성과 성능을 높였습니다.
무븐트는 AWS 이벤트 기반 파이프라인으로 댄스 영상을 구조화된 학습 데이터로 변환했습니다. GPU 추론과 API를 분리한 다중 계층 서빙으로 성능과 확장성을 개선했습니다.
분산된 업무 이력을 출처가 유지되는 Wiki로 연결했습니다. AI가 설계·구현 판단 전에 과거 근거를 확인하도록 구성했습니다.