


Lambda에서 AWS CLI를 사용하려면 어떻게 해야할까?
AWS Lambda에서 AWS CLI를 직접 쓰기 위해 Lambda Layer에 awscli를 포함하는 방법을 설명했습니다. Layer 적용 후 aws s3 sync 같은 명령을 subprocess로 실행할 수 있었습니다.
#AWS Lambda#AWS CLI
11900
AWS Lambda에서 AWS CLI를 직접 쓰기 위해 Lambda Layer에 awscli를 포함하는 방법을 설명했습니다. Layer 적용 후 aws s3 sync 같은 명령을 subprocess로 실행할 수 있었습니다.
새 속성을 추가할 때는 기존 이름이 더 이상 적절한지 함께 살펴야 합니다. 이름을 구체화하고 표시 규칙을 분리하면 버그를 줄일 수 있습니다.

분산된 데이터 플랫폼의 메타데이터를 통합 관리하는 DataHub의 개념과 주요 기능을 소개했습니다. 검색, 계보 추적, 거버넌스, 접근 제어 관점에서 활용 포인트를 정리했습니다.


Amazon Bedrock과 AWS Config로 규제 요구사항을 규칙에 자동 매핑하는 도구를 소개했습니다. 수동 관리의 한계를 줄이기 위한 프롬프트 설계와 운영 포인트도 함께 설명했습니다.

당근은 피드 콘텐츠를 Feed-Entity로 표준화해 여러 서비스의 데이터를 한 구조로 관리했습니다. 수집·변환·검증·서빙을 모듈화하고 지역별 캐시로 읽기 성능과 확장성을 높였습니다.

Django REST Framework에서 django-modeltranslation으로 다국어 지원을 구현한 사례를 소개했습니다. DB 기반 번역 관리와 fallback 설정으로 유지 보수성과 사용자 경험을 높였습니다.

Polars는 Pandas와 비슷한 인터페이스를 유지하면서도 Rust 기반 최적화로 대용량 데이터 처리 성능을 높였습니다. Lazy Execution과 멀티코어 활용으로 로컬 환경에서도 빠른 전처리와 분석을 기대할 수 있습니다.

데브시스터즈가 Infra/SRE 엔지니어링 데이를 열어 운영 과제와 해결 경험을 공유했습니다. 장애 대응 원칙, 쿠버네티스 표준화, 배포 시스템 사례를 소개했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

데이터레이크 확산으로 데이터 카탈로그와 거버넌스의 중요성을 설명했습니다. 오픈소스 Datahub의 메타데이터 수집, 검색, 리니지, 연동 기능을 소개했습니다.
VoC가 많을 때 우선순위를 합리적으로 정하는 방법론을 소개합니다. Kano, Eisenhower Matrix, WSJF를 활용한 분류와 판단 기준을 다룹니다.

네이버 FE 엔지니어들이 25년 4월 FE News에서 LLM 실패 사례, 프롬프트 엔지니어링, Vibe Coding 등을 소개했습니다. 웹과 AI 관련 주요 기술 소식을 월간으로 큐레이션해 공유했습니다.

안드로이드에서 DistilKoBERT 기반 스팸 분류 모델을 온디바이스 AI로 구현한 과정을 정리했습니다. TFLite 변환과 양자화로 모델 크기와 추론 속도를 개선하고 단말 벤치마크 결과도 확인했습니다.
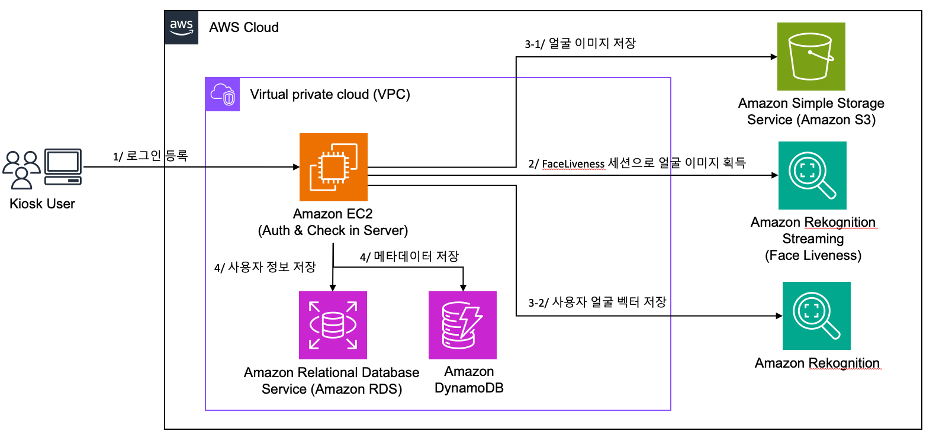
Amazon Rekognition Face Liveness로 무인 키오스크의 얼굴 등록과 로그인 흐름을 구현한 사례를 다뤘습니다. SAGA 패턴과 스냅샷 기반 인식으로 일관성과 저사양 기기 호환성도 함께 확보했습니다.

독일 AVM 소송을 통해 LGPL-2.1의 사용자 권리와 설치정보 제공 의무가 다시 주목받았습니다. 일반 사용자도 라이선스 위반에 대해 직접 문제를 제기할 수 있음이 강조되었습니다.