

매번 다 퍼올 필요 없잖아? 당근의 MongoDB CDC 구축기
매번 다 퍼올 필요 없잖아? 당근의 MongoDB CDC 구축기
MongoDB 덤프의 DB 부하와 SLO 문제를 해결하기 위해 CDC를 도입했습니다. Flink CDC와 Spark, 이중 테이블 구조로 적재와 스키마 변경, 정합성 검증을 묶었습니다.
#MongoDB#CDC
16900
새로운 기술 블로그가 추가되었어요
MongoDB 덤프의 DB 부하와 SLO 문제를 해결하기 위해 CDC를 도입했습니다. Flink CDC와 Spark, 이중 테이블 구조로 적재와 스키마 변경, 정합성 검증을 묶었습니다.
Karrot 데이터팀이 BigQuery SQL 로그를 파싱해 컬럼 단위 데이터 계보를 구축한 과정을 소개했습니다. 테이블 단위 한계를 보완하고 영향 분석과 PII 추적을 정교하게 만든 사례입니다.
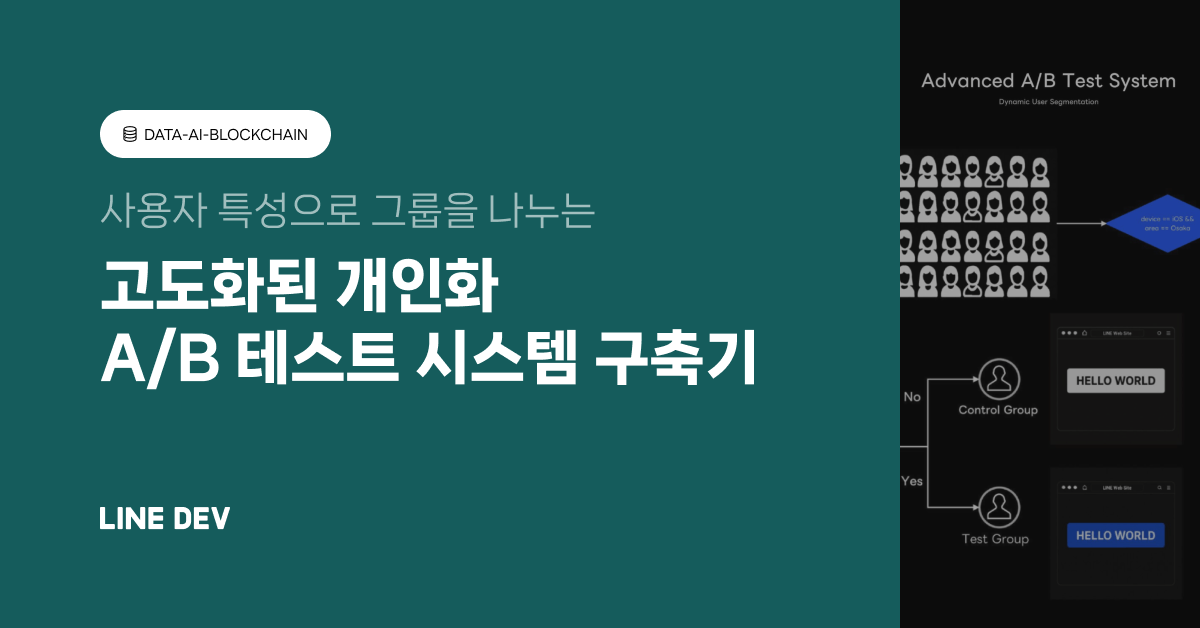
사용자 세그먼트 기반으로 A/B 테스트 그룹을 나누는 동적 분할 시스템을 소개했습니다. 타겟팅·할당·로그 수집 흐름과 실제 활용 사례도 함께 정리했습니다.
BigQuery 쿼리 로그를 SQL 파싱해 컬럼 레벨 리니지를 구축한 사례를 소개했습니다. 테이블·컬럼 의존 관계를 빠르게 추적해 데이터 신뢰성과 운영 효율을 높였습니다.
실시간 거래 리포트를 빠르게 조회하기 위한 저지연 설계와 최신성 확보 과정을 다뤘습니다. Spark, Iceberg, StarRocks 조합의 운영 사례와 성능 결과도 공유했습니다.
Zeppelin의 익숙한 사용성을 유지하면서 JupyterHub에 기능과 운영 체계를 단계적으로 구현한 내용을 정리했습니다. 대용량 SQL 안정화, GitHub 자동화, 무중단 운영과 추적성 확보가 핵심이었습니다.

스타트업 서비스 설계에서는 구현보다 지속 가능성을 먼저 고민해야 한다고 말씀했습니다.\n기술 부채와 운영 요소를 함께 보고, 장기적으로 연결되는 구조를 설계하는 시야가 중요하다고 강조했습니다.
데이터는 많지만 도구와 흐름이 흩어져 있어 활용이 어려운 문제를 다뤘습니다. 이를 해결하기 위해 JupyterHub와 dbt 조합을 통합 데이터 허브의 기반으로 선택했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.


Trino는 빠른 실시간 분석과 멀티 소스 조인에 적합하고, Spark는 대규모 배치와 ETL에 유리하다고 설명했습니다. 두 엔진을 역할 분담하는 하이브리드 전략과 Trino의 운영 한계도 함께 정리했습니다.
HDFS와 오브젝트 스토리지의 장단점을 비교하고, 그 한계를 보완하는 JuiceFS의 구조와 활용법을 설명했습니다. Hadoop 환경에서 JuiceFS를 설정해 HDFS CLI, MapReduce, Spark와 연동하는 방법도 다뤘습니다.

웹 크롤링 데이터로 LLM 사전학습 데이터셋을 만든 경험과 어려움을 정리했습니다. NVIDIA EMNLP 2024 논문을 통해 품질 필터링과 중복 제거 전략을 체계적으로 살펴봤습니다.
Flink와 Apache Paimon으로 실시간 유효 광고 선정 파이프라인을 구축한 사례를 소개했습니다. 실시간 처리 보장, 조인, 타임 트래블, 자동 compaction 같은 Paimon 활용 포인트를 정리했습니다.
CDC 파이프라인 정합성 검사 Spark 잡의 코드 설계 배경을 소개했습니다. 대규모 데이터 응집 환경에서 검증용 잡을 어떻게 구성할지 다루는 글입니다.
CDC 파이프라인 정합성 검사 Spark 잡의 최적화 방법을 다룬 후속 글입니다. 앞선 코드 설계편에 이어 Spark 잡 성능 개선과 운영 관점을 소개했습니다.