백엔드
Spark 9편: JDBC 병렬처리 시 주의 사항
두줄요약
Spark JDBC 병렬처리의 기본 사용법과 파티션 분할 방식의 주의점을 설명했습니다. 소수점 버림으로 인한 skew를 줄이기 위해 upperBound 설정과 컬럼 분포 점검이 필요했습니다.
핵심 내용
- Spark JDBC 로딩은 기본적으로 단일 Task로 수행되어 대용량 조회 시 timeout, OOM, Storage Spill 위험이 존재
- partitionColumn, lowerBound, upperBound, numPartitions를 활용해 병렬 수집 가능
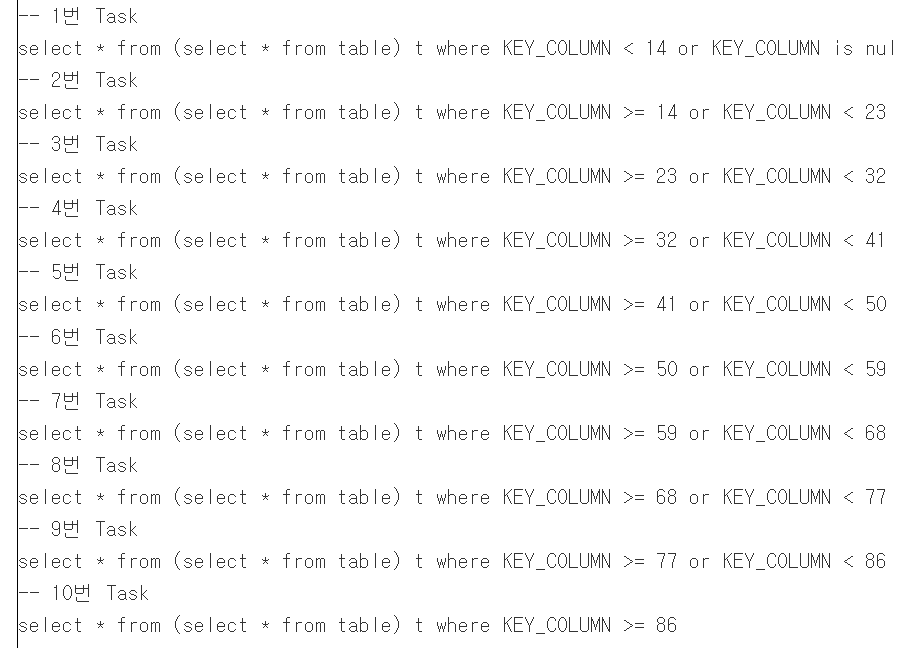
- 다만 Spark 내부 stride 계산의 소수점 버림 때문에 예상과 다른 파티션 분할과 skew가 발생할 수 있음
주의할 점
- upperBound를 numPartitions의 배수로 맞춰 stride 손실을 줄이는 방식 필요
- partitionColumn은 숫자, 날짜, 타임스탬프 계열이어야 하며 카디널리티와 데이터 분포 점검 필요
- 병렬도 증가에 따라 DB 부하와 Executor 낭비가 생기지 않도록 균형 조정 필요