
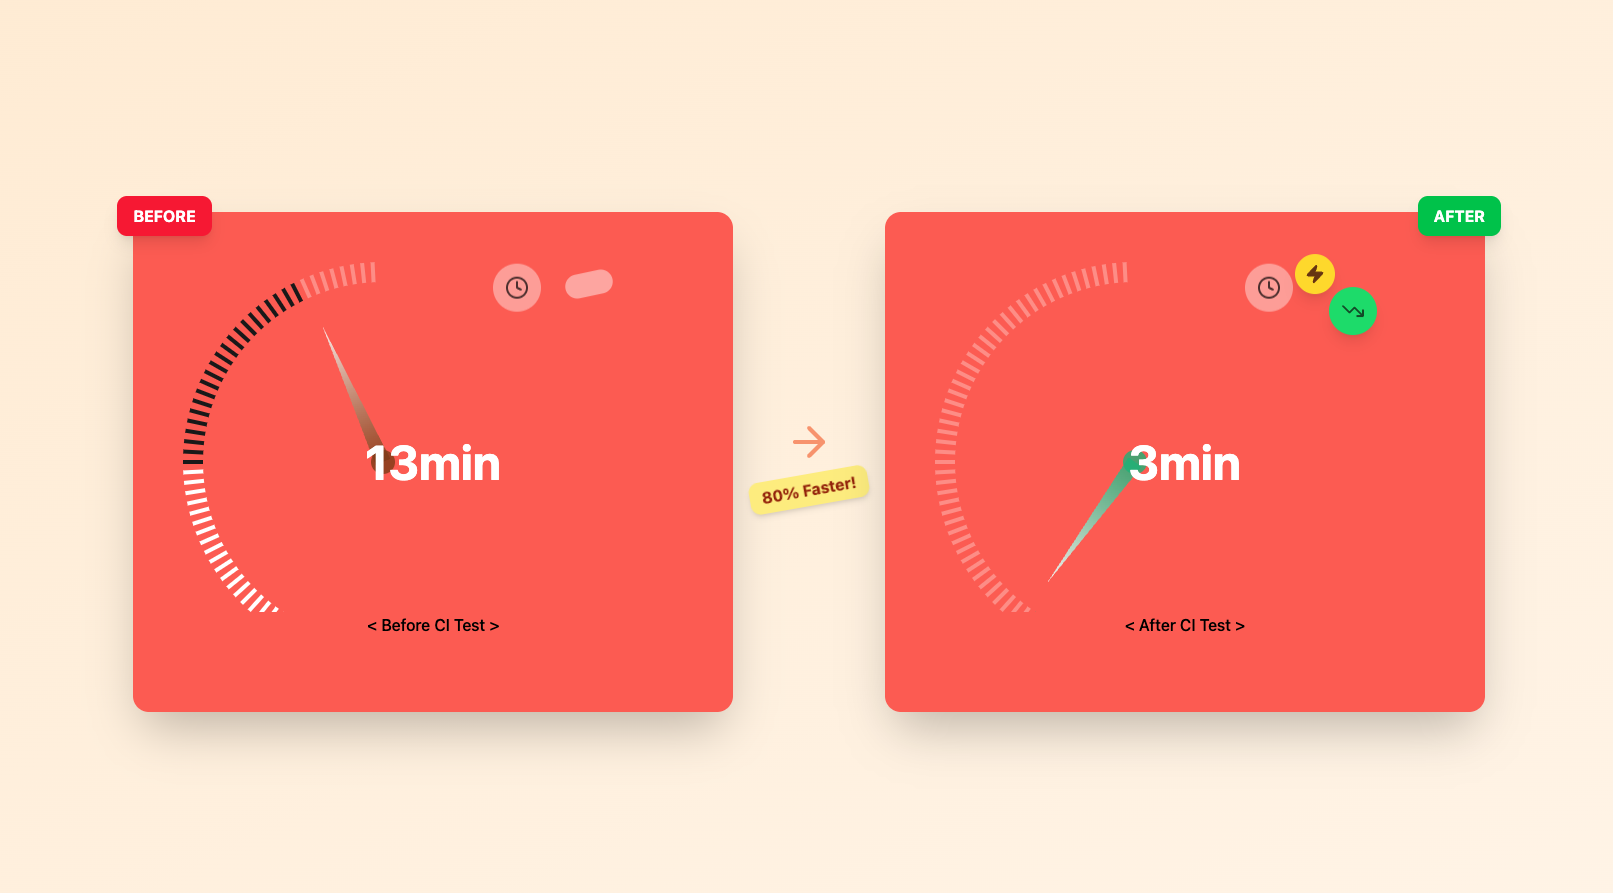
Python 2.7 서버의 CI Test 개선 - 13분에서 3분으로
Python 2.7 서비스의 중복 실행과 불필요한 설치를 제거해 CI 테스트를 13분에서 5분으로 단축했습니다. 공유 경로 기반 캐싱과 tmpfs를 적용해 최종 3분대까지 개선했습니다.
#Python#CI/CD
200
Python 2.7 서비스의 중복 실행과 불필요한 설치를 제거해 CI 테스트를 13분에서 5분으로 단축했습니다. 공유 경로 기반 캐싱과 tmpfs를 적용해 최종 3분대까지 개선했습니다.


여기어때컴퍼니의 Oracle to Aurora MySQL 마이그레이션 사례를 소개했습니다. 생성형 AI 기반 OMA로 6주 만에 대규모 전환과 검증을 완료했습니다.

Amazon Bedrock AgentCore Memory로 LLM의 Statelessness를 보완하는 기억 시스템을 소개했습니다. 단기·장기 기억, 자동 검색, 대화 분기를 통해 기억하는 AI 에이전트를 구현하는 방법을 설명했습니다.

Figma 플러그인 2.0의 성능 개선을 위해 통신 계층과 렌더링 구조를 전면 재설계했습니다. 비동기 매칭, 탐색 비용, 이미지 로딩, 스토리지 동기화를 최적화해 체감 속도와 안정성을 높였습니다.
Figma 플러그인 UI를 가볍고 단순한 구조로 설계한 과정을 소개했습니다. 필터 상태, 캐시, 메시지 통신을 중심으로 실데이터 연동과 UX 개선을 정리했습니다.
Figma 플러그인에서 내부 API를 직접 호출할 때 발생하는 CORS와 HTTPS 제약을 해결하기 위해 프록시 서버를 구축했습니다. 기존 인프라를 재사용하고 최소 권한 원칙으로 설계해 안전하게 운영했습니다.
도소매·유통 업종의 잦은 채용에서 반복되는 온보딩 업무를 전자계약과 조직도 기반 권한 관리로 줄이는 방법을 소개했습니다. 인사 데이터 연동과 실시간 진행 확인으로 신입사원 입사 초기 과정을 체계화했습니다.
AWS re:Invent 2025의 핵심 키노트와 신규 발표를 정리한 글입니다. AI 인프라 확장과 에이전트 시대를 위한 AWS의 방향을 요약했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

네이버 Logiss의 로그 파이프라인 운영 문제와 개선 과정을 다뤘습니다. Storm Kafka spout 수정과 멀티 토폴로지 도입으로 비용·성능·안정성을 높이려 했습니다.

올리브영 QA팀이 2025 QA Korea Conference에 참여한 회고를 공유했습니다. 부스 운영과 발표, 커피챗을 통해 팀워크와 품질 문화를 전했습니다.
시스템 프롬프트에 안전 규칙을 몰아넣는 방식의 한계와 부작용을 설명했습니다. 별도 가드레일을 두면 안전성, 비용, 운영성을 함께 개선할 수 있다고 정리했습니다.

MongoDB 새 GA 버전이 공개될 때 업그레이드를 검토하는 운영 관점을 소개했습니다. 안정성을 중시하며 MongoDB 8.0 업그레이드 이유를 정리한 글입니다.
쿠버네티스 기본 배포의 한계를 줄이기 위해 Argo Rollouts로 카나리 배포를 자동화했습니다. Nginx Ingress와 Datadog 연동으로 점진적 전환과 무인 롤백 구조를 구축했습니다.
AI와의 대화에서 의도와 결과의 간극을 줄이기 위해 Grice의 협력 원칙과 컨텍스트 엔지니어링을 연결해 설명했습니다. 명시적 전제를 늘려 AI의 오해를 줄이는 실용적 방법을 제안했습니다.