

[BigData] Spark 개요 정리
Spark의 개요와 주요 구성요소, 장점을 정리한 글입니다. 대용량 데이터 처리에서 Pandas보다 Spark가 더 적합한 성능 사례도 비교했습니다.
#Spark#Pandas
8500
새로운 기술 블로그가 추가되었어요
Spark의 개요와 주요 구성요소, 장점을 정리한 글입니다. 대용량 데이터 처리에서 Pandas보다 Spark가 더 적합한 성능 사례도 비교했습니다.


데이터와 AI의 발전을 두 번의 대전환으로 정리하며, 빅데이터의 양적 성장과 AI 결합의 흐름을 설명했습니다. 데이터 품질, 실시간 처리, 거버넌스의 중요성도 함께 짚었습니다.
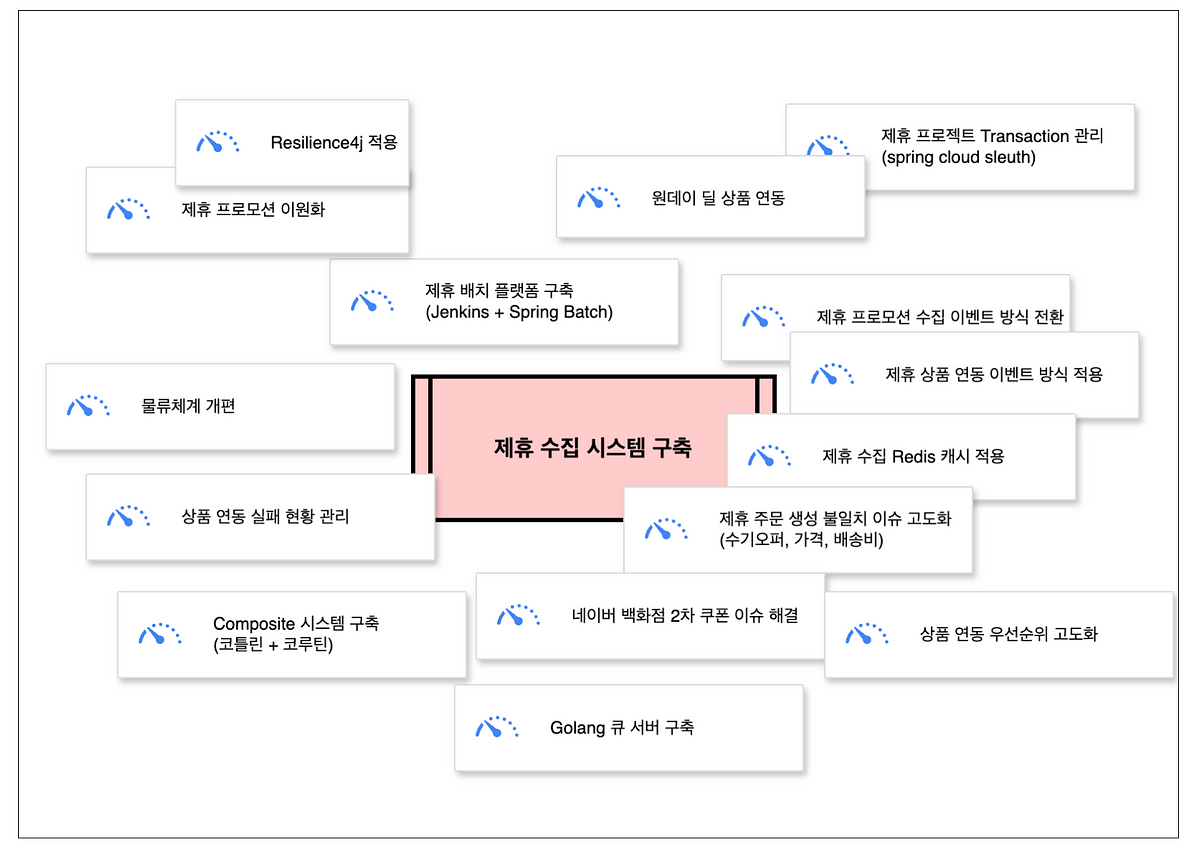
제휴 서비스 수집 시스템의 레거시 한계를 개선해 이벤트 기반, CQRS, Zero Payload 구조로 재설계했습니다.실시간 연동과 부하 분산을 통해 속도, 정합성, 운영 효율을 높인 과정을 공유했습니다.
Elasticsearch 기반 로그 저장 구조의 비용과 확장성 한계를 해결하기 위해 Iceberg 기반 Alaska를 도입했습니다. Kafka 로그를 오브젝트 스토리지에 직접 적재하고, 실시간 조회와 장기 보관을 분리해 운영 효율을 높였습니다.
로그 인리치먼트로 감사로그의 컨텍스트를 보강한 설계와 구현 사례를 다뤘습니다. 비동기 처리, 메타데이터 저장소, S3 적재와 중복 제거 전략을 설명했습니다.
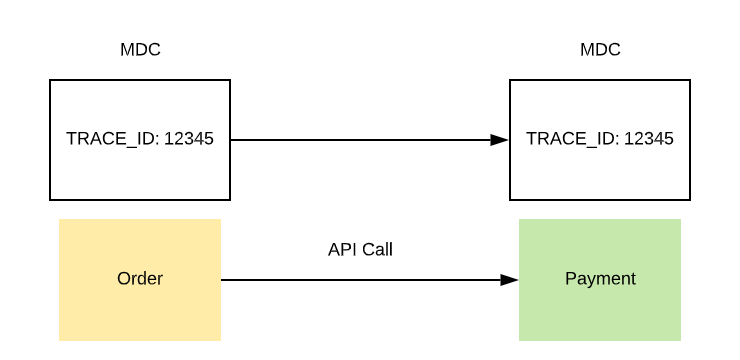
인터페이스 이력 관리 시스템을 AOP와 MDC, Kafka Interceptor로 구현한 과정을 정리했습니다. 멀티스레드 전파와 호출 스택 누락 문제를 여러 차례 개선한 시행착오를 공유했습니다.
로그 누적으로 발생한 대시보드 타임아웃과 slow query 문제를 Trino 도입으로 개선한 사례를 다뤘습니다. OBS와 Parquet, MySQL tier down 구조를 통해 집계 성능과 저장 효율을 함께 고려했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
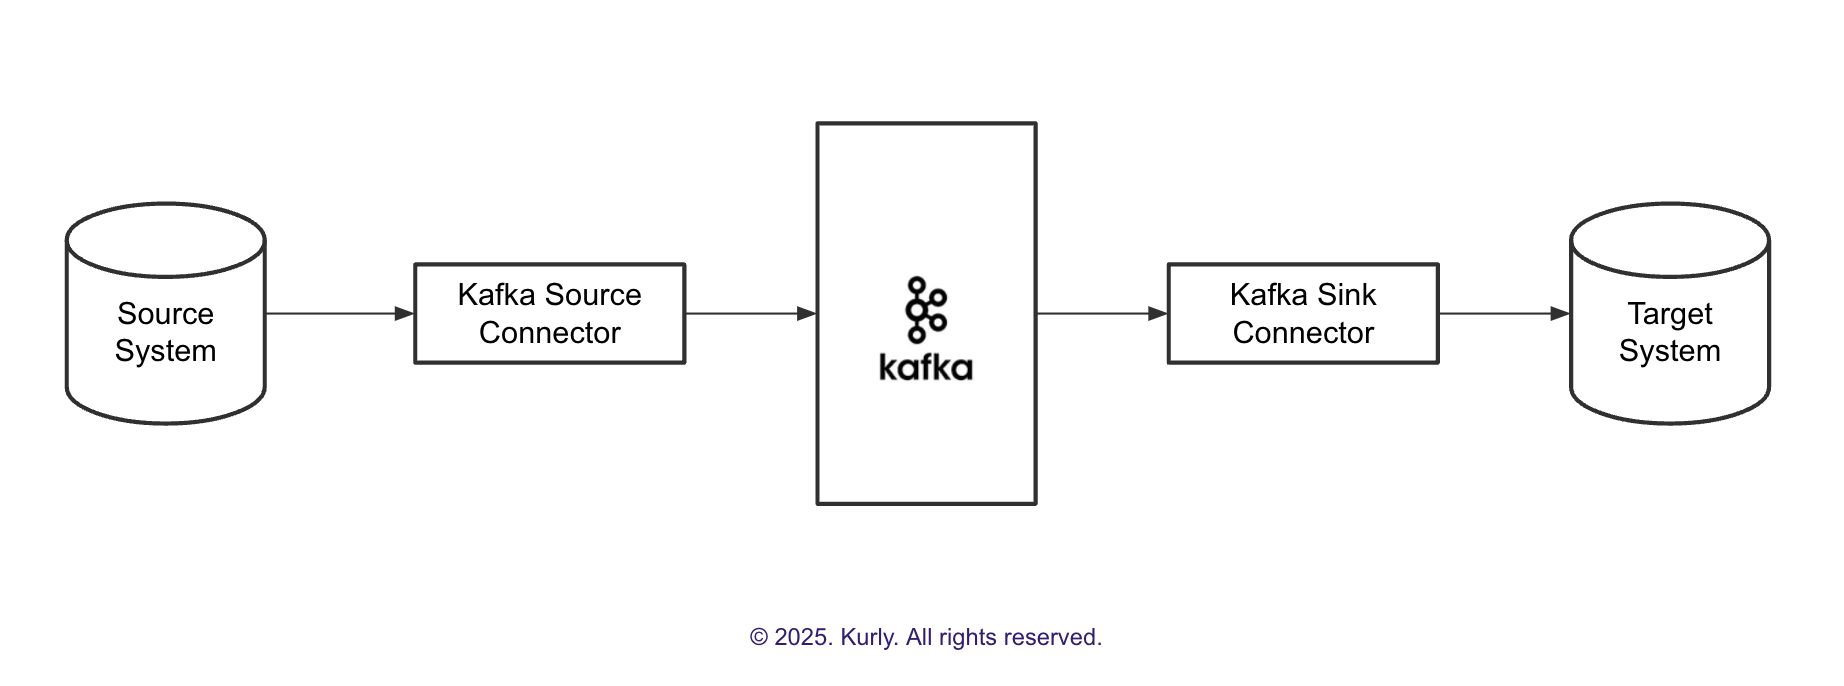

Kafka Connect와 JDBC Source Connector로 DB 데이터를 Kafka에 연동하는 구조와 증분 쿼리 모드를 설명했습니다.\n쿼리 기반 CDC의 누락 사례와 지연 옵션을 통한 완화 방법을 정리했습니다.
OBS 플랫폼에 SLI/SLO를 도입해 공용 미디어 플랫폼의 신뢰성을 측정하고 운영에 활용한 사례를 공유했습니다. 로그 기반 메트릭 수집과 Recording Rules로 대시보드 성능을 개선하고 알람 체계를 구성했습니다.
MSK와 커스텀 Consumer로 로그 파이프라인을 스트리밍 구조로 전환했습니다. 데이터 컨트랙트로 스키마를 통합 관리하고 신선도를 약 3분으로 단축했습니다.
기존 로그 배치 파이프라인의 분류 비효율, 낮은 신선도, 스키마 관리 부재를 정리하고 개선 방향을 설명했습니다. MSK와 Kafka Consumer, Protobuf, Schema Registry를 활용한 준실시간 구조로 전환한 과정을 소개했습니다.

Kafka 소비 시 JSON 역직렬화 설정이 왜 기대대로 동작하지 않는지 과정을 따라가며 분석했습니다. 헤더 타입 정보와 타입 매핑, trusted packages, target type 우선순위를 조정해 해결했습니다.
쓱데이 트래픽 대응을 위해 상품 유닛에 카나리 배포를 도입한 경험을 공유했습니다. 성능 개선 작업과 함께 조기 장애 감지와 롤백의 중요성을 강조했습니다.

DataHub를 그대로 노출하지 않고 OpenSearch와 DB를 직접 활용해 데이터카탈로그에 맞는 검색·리니지·BI 통합 기능을 구현했습니다. 또한 버전업과 수집 성능 문제를 개선해 운영 적합성을 높였습니다.