

How We Pipe Data
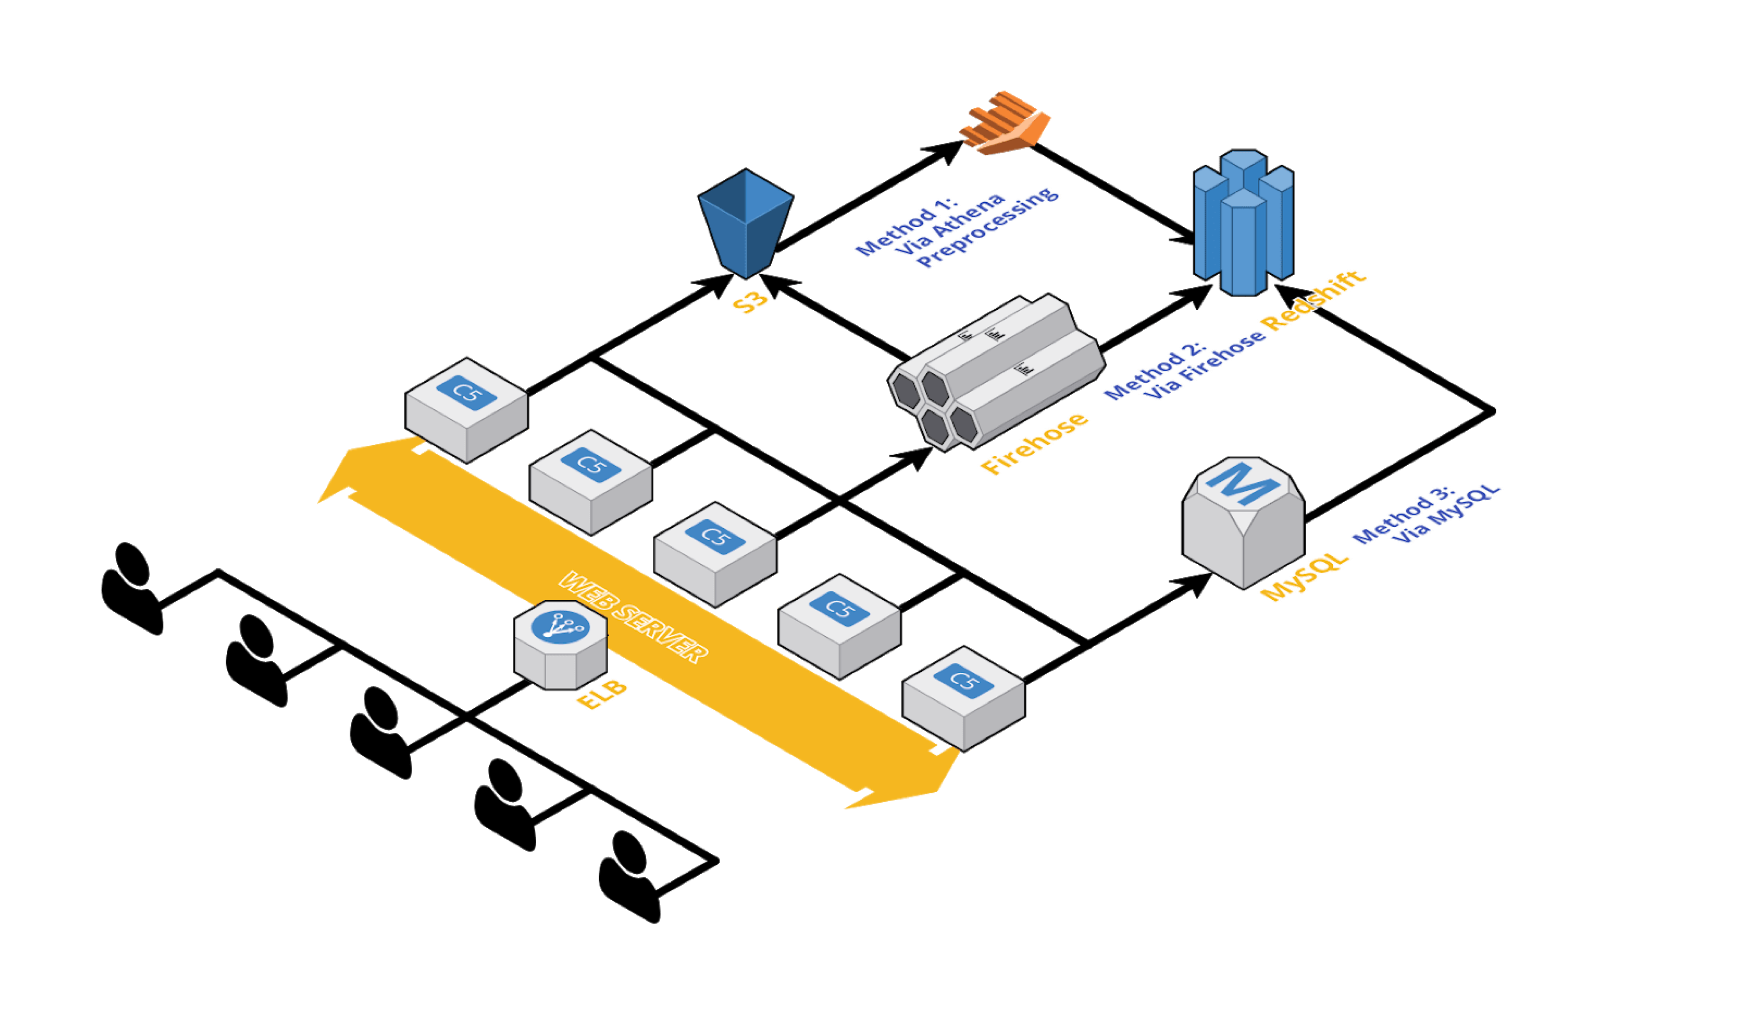
여러 저장소에 분산된 사용자·광고 활동 데이터를 Redshift로 통합하는 파이프라인을 소개했습니다. 컬럼형 저장, 빠른 적재, 수평 확장성을 핵심 선택 이유로 설명합니다.
#Redshift#pipeline
1200
새로운 기술 블로그가 추가되었어요
여러 저장소에 분산된 사용자·광고 활동 데이터를 Redshift로 통합하는 파이프라인을 소개했습니다. 컬럼형 저장, 빠른 적재, 수평 확장성을 핵심 선택 이유로 설명합니다.
여러 국가의 유저 행동 및 광고 데이터를 다양한 저장소에서 수집하는 환경을 소개했습니다. 분석과 활용을 위해 분산 데이터를 한곳에 모으는 필요성을 설명합니다.

Python으로 MySQL에 접속해 CSV 데이터를 삽입·수정하고 조회 결과를 파일로 저장하는 방법을 학습했습니다. 실제 회사 DB에서 필요한 데이터를 쿼리로 추출하며 학습 내용을 적용했습니다.

포인트 히스토리와 총 포인트 테이블을 통합해 일관성 있는 스키마를 구성했습니다. 포인트 타입별 분리와 단일 테이블 방식의 장단점을 검토했습니다.
허니스크린의 포인트 시스템은 기존 MySQL RDS로 운영했습니다. 서비스 성장에 따른 요청 급증으로 데이터베이스 부하가 커진 맥락을 다룹니다.
포인트 요청 증가로 MySQL RDS 부하가 커진 문제를 다뤘습니다. 확장성이 높은 AWS DynamoDB 기반 포인트 시스템 설계를 소개합니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.


비트윈은 채팅의 높은 쓰기 성능과 대량 로그 분석을 위해 HBase를 활용했습니다.\nMapReduce·MySQL 분석 흐름과 HBase 다중 행 트랜잭션 라이브러리 Haeinsa를 소개했습니다.

비트윈은 Access Log를 기반으로 사용자 행동을 집계하고 분석 플랫폼을 단계적으로 확장했습니다. 익명화와 시각화를 바탕으로 개인정보를 보호하며 의사결정과 실행으로 연결했습니다.