AI
측정할 수 없으면 개선할 수 없다 - AI Pick 추천 카드를 위한 sLLM 정렬 학습기

두줄요약
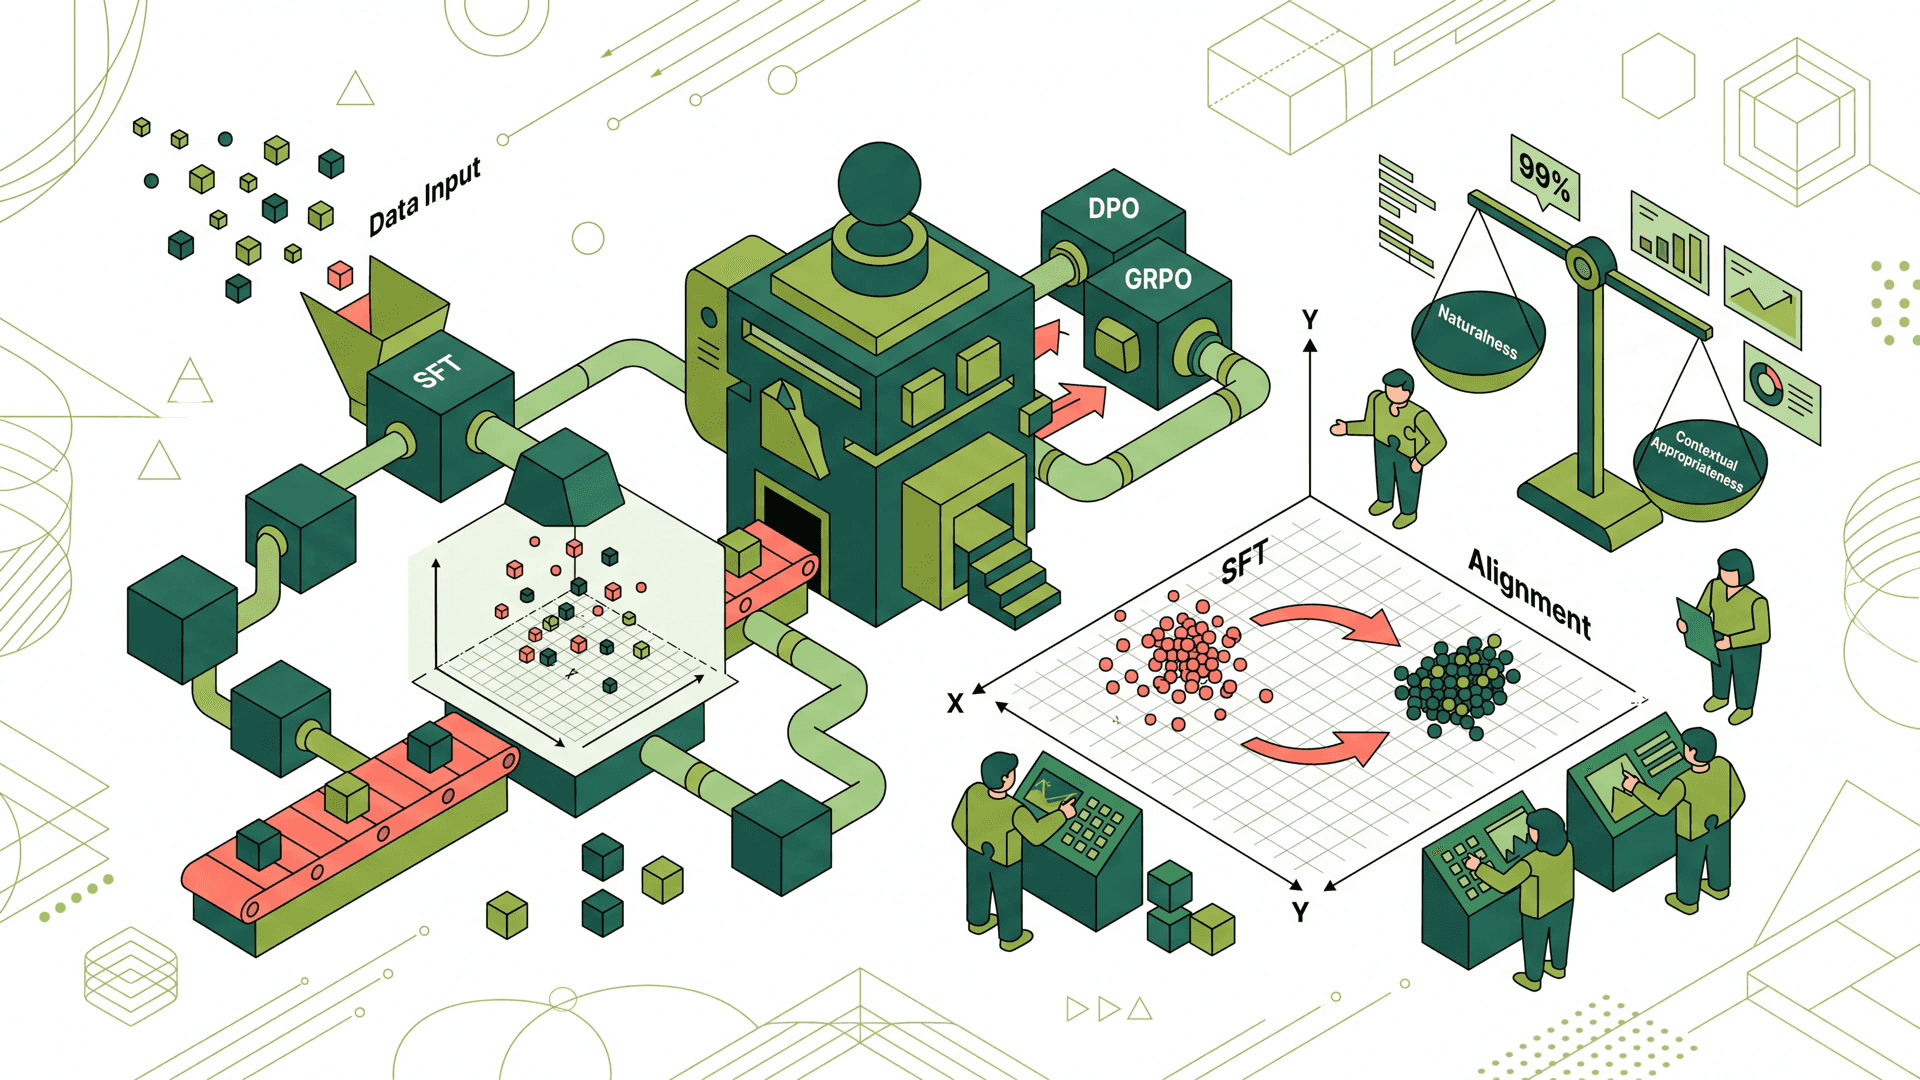
AI Pick 카드 생성 품질을 높이기 위해 SFT 이후 정렬 학습과 평가 지표를 설계한 과정을 공유했습니다. 형식 검증기와 NLL 프록시로 선호 쌍을 만들고 DPO, GRPO로 품질과 형식을 함께 개선했습니다.
핵심 내용
- AI Pick 추천 카드 생성 품질을 높이기 위해 SFT 이후 단계인 정렬 학습을 적용한 사례
- 형식 검증기와 외부 한국어 언어모델의 NLL 지표로 자연스러움·문맥적합을 수치화해 선호 쌍 자동 구성
- DPO로 품질을 개선하고, 과제에 따라 formatmix와 GRPO로 형식 통과율 하락을 보정한 실험 결과 공유
- 짧은 한국어 UI 문구에서는 재현 가능한 평가 체계가 사람 라벨이나 LLM Judge보다 실용적이라는 검증
적용해볼 점
- 형식은 규칙 기반 검증으로, 품질은 프록시 지표로 분리해 다루는 평가 체계 설계
- 선호 데이터 구축 시 near-miss 오류와 최소 품질 기준을 함께 두는 방식
- 제한된 GPU 환경에서 QLoRA, DPO, GRPO를 조합한 경량 post-training 접근