목록 보기
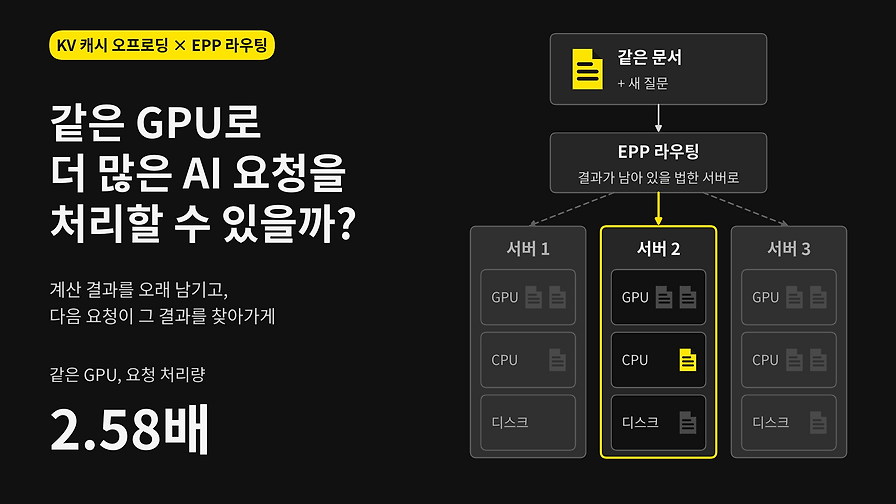
같은 GPU로 더 많은 AI 요청을 처리할 수 있을까? ― KV 캐시 오프로딩 × EPP 라우팅: 계산 결과를 오래 남기고, 다음 요청이 그 결과를 찾아가게 하기
AI

같은 GPU로 더 많은 AI 요청을 처리할 수 있을까? ― KV 캐시 오프로딩 × EPP 라우팅: 계산 결과를 오래 남기고, 다음 요청이 그 결과를 찾아가게 하기
카카오
카카오
2026년 11월 17일

두줄요약

KV 캐시 오프로딩과 EPP 라우팅으로 계산 결과를 재활용하는 방식을 다룹니다. 동일 GPU 32장에서 3,456건 처리 시간을 121.7분에서 47.2분으로 줄였습니다.

구조와 흐름

  • KV 캐시 오프로딩으로 기존 계산 결과 보존
  • EPP 라우팅으로 후속 요청을 캐시 보유 위치로 유도

성능/운영 포인트

  • GPU 32장과 요청 3,456건 조건에서 처리 시간 121.7분에서 47.2분으로 단축
  • GPU와 모델 교체 없이 캐시 활용 및 요청 라우팅 방식 변경

카카오 계열사 채용37건

채용 사이트에서 전체 보기

다음 읽기

비슷한 주제의 AI 글

지연 시간 순삭! LLM 추론 구조와 효율적 애플리케이션 설계 / if(kakaoAI)2024

LLM 시퀀스 생성 구조를 분석해 애플리케이션 지연 시간을 줄이는 방안을 소개합니다. 캐릭터 페르소나 구현 경험을 바탕으로 실시간 응답 성능 최적화 전략을 공유합니다.

카카오엔터테인먼트FE
카카오엔터테인먼트FE
AI
전체 보기

댓글 0개

댓글을 작성하려면 로그인이 필요합니다.

댓글을 불러오는 중...