AI
RAG 시스템의 재순위화(Reranking): 구조와 발전부터 리랭커 선정까지

두줄요약
RAG 재순위화의 구조와 기술 발전, 운영 설정, 모델 선정 기준을 정리했습니다. 한국어 기업 문서 실험으로 정확도·속도·GPU 비용의 차이를 비교했습니다.
구조와 흐름
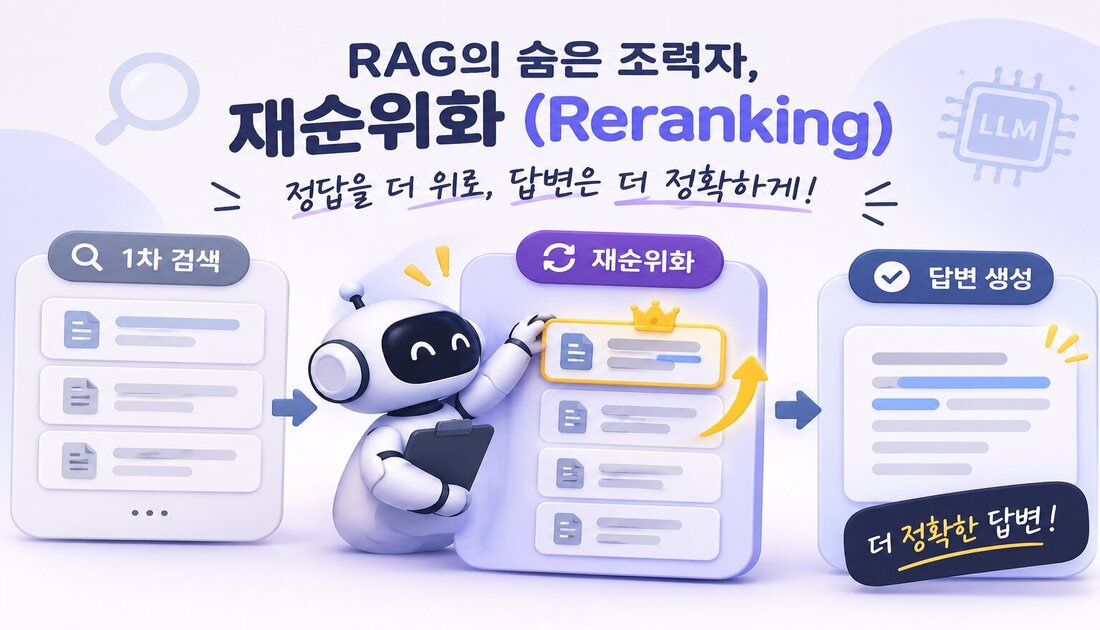
- RAG의 1차 검색과 답변 생성 사이에서 후보 문서의 관련도를 다시 평가하는 재순위화 단계
- 1차 검색에서 후보 10~20건을 확보한 뒤 크로스 인코더·LLM 기반 모델로 순서 조정
- 규칙·점수 기반, 크로스 인코더, LLM 기반을 거쳐 추론형·한국어 특화·경량 모델로 발전
성능/운영 포인트
- 기업 문서 실험에서 재순위화 미적용 대비 모든 모델의 nDCG@10과 1위 정답률 향상
- Nemotron-3.5-Rerank-8B의 최고 nDCG@10 0.711, KURE-Reranker-base의 최고 1위 정답률 87.8%
- 후보 수 20건 이후의 정확도 향상은 작고 처리 시간은 증가하는 특성
선택 이유
- 저지연·소형 GPU 환경에서 bge-reranker-v2-m3-ko 또는 KURE-Reranker-nano
- 정확도와 속도 균형 관점에서 KURE-Reranker-base, 정확도 우선 환경에서 Nemotron-3.5-Rerank-8B
- 한국어 문서에서 한국어 임베딩·재순위화 모델의 우선 검증 필요
주의할 점
- 재순위화는 1차 검색 후보 밖의 정답 문서를 복구할 수 없는 한계
- 공개 벤치마크와 기업 문서 간 모델 순위 역전 가능성
- 모델 크기보다 처리 시간, GPU 메모리, 입력 길이, 라이선스, 자체 데이터 성능의 종합 비교 필요