AI
MRC로 대규모 AI 학습 네트워크 확장하기
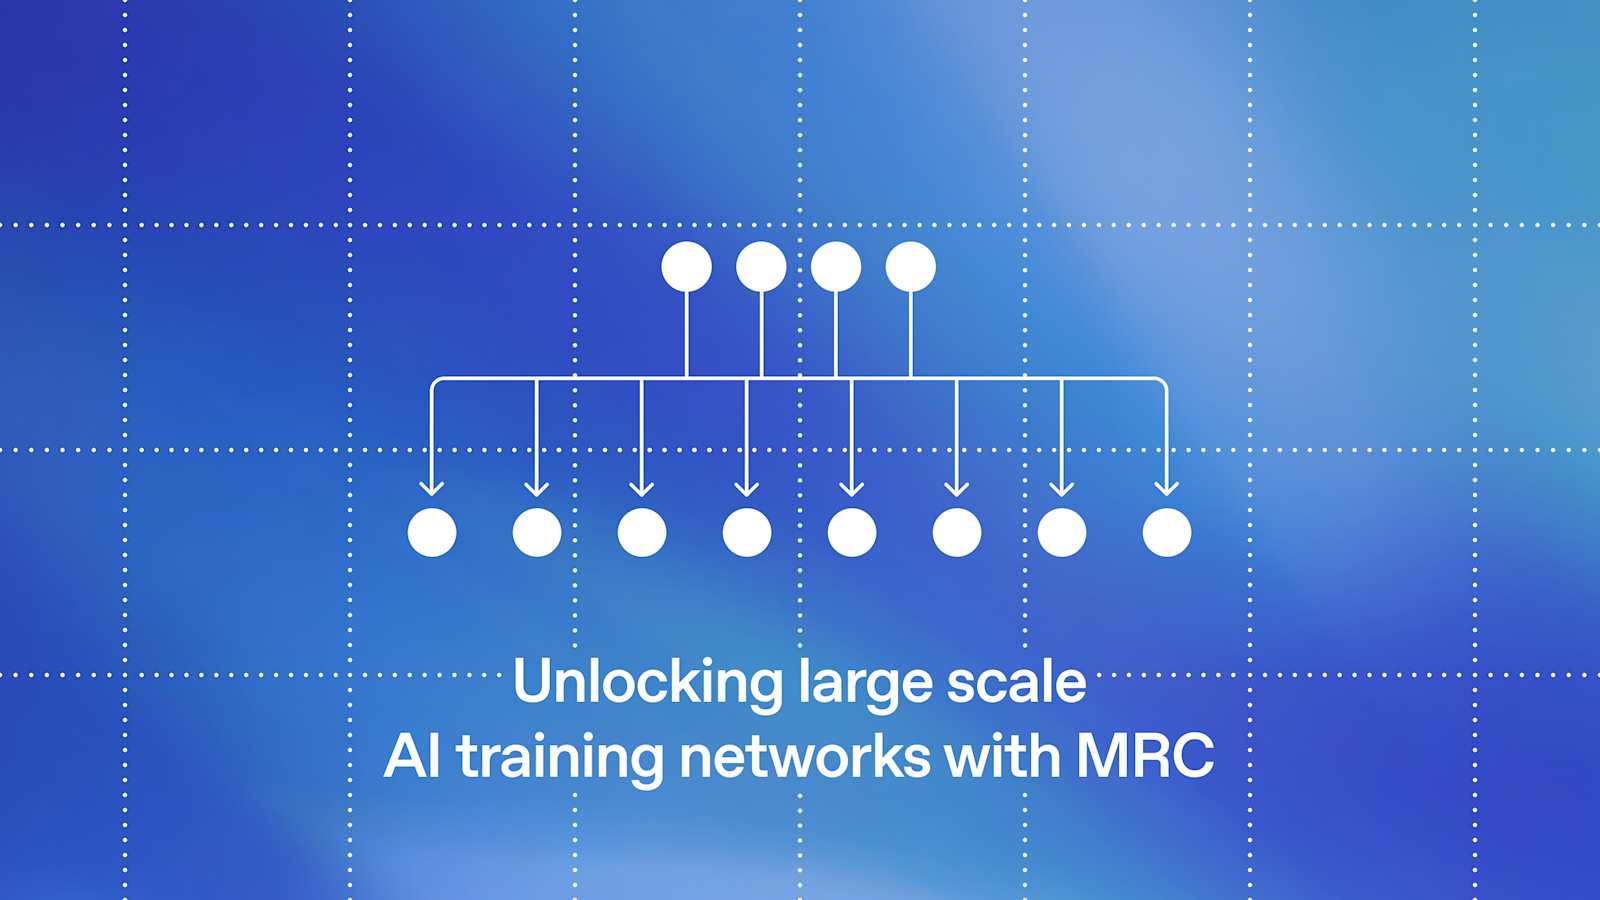
Unlocking large scale AI training networks with MRC (Multipath Reliable Connection)

두줄요약
OpenAI가 대규모 AI 학습용 네트워크 프로토콜 MRC를 OCP에 공개했습니다. 패킷 다중 경로 분산과 장애 우회로 GPU 학습 중단 영향을 줄였습니다.
핵심 발표
- 대규모 AI 학습 클러스터의 GPU 네트워킹 성능과 복원력을 위한 MRC(Multipath Reliable Connection) 공개
- AMD, Broadcom, Intel, Microsoft, NVIDIA와의 2년간 공동 개발
- Open Compute Project(OCP)를 통한 MRC 사양 공개
주요 변화
- 800Gb/s 인터페이스를 여러 개의 100Gb/s 링크와 독립 네트워크 플레인으로 분할하는 멀티플레인 토폴로지
- 단일 전송의 패킷을 수백 개 경로로 분산하는 adaptive packet spraying과 경로별 부하 조정
- SRv6 기반 소스 라우팅, 패킷 트리밍, 손실 패킷 재전송을 통한 장애 우회
개발자 영향
- 약 131,000개 GPU를 스위치 2계층으로 완전 연결 가능한 네트워크 구성
- 스위치 계층·전력·장애 가능 구성 요소 감소와 경로 다양성 확대
- 마이크로초 단위 장애 감지·우회로 동기식 AI 학습 작업 중단 영향 축소
사용 방법·가용성
- NVIDIA GB200 기반 OpenAI 대형 슈퍼컴퓨터와 Oracle Cloud Infrastructure(OCI) Abilene 사이트, Microsoft Fairwater 슈퍼컴퓨터에 배포
- NVIDIA와 Broadcom 하드웨어 기반 복수 OpenAI 모델 학습 활용
- OCP contribution 형태의 MRC 사양 제공