


케클s피드 9월호|kt cloud summit 2026, 고객의 AX를 현실로 만드는 인프라 전략
AI 서비스 운영을 위한 AIDC 전력·클라우드·Composite AI 전략을 소개했습니다. RAG, 모델 선택, 추론 메모리 최적화와 MCP 활용 방안도 다뤘습니다.
#cloud#MCP
1100

AI 서비스 운영을 위한 AIDC 전력·클라우드·Composite AI 전략을 소개했습니다. RAG, 모델 선택, 추론 메모리 최적화와 MCP 활용 방안도 다뤘습니다.
에이전트 개발에서 혼용되는 워크플로우, 하네스, Context·Memory, MCP·A2A 개념을 정리했습니다. 원문 명세와 실제 구현체를 바탕으로 팀의 용어 혼선을 줄이는 내용을 공유합니다.
AI가 코드를 빠르게 작성하는 환경에서 핵심 병목이 검증으로 이동했음을 두 프로젝트 사례로 설명했습니다. CI, 시각 회귀, MCP 기반 실행 검증으로 배포 확신을 만드는 방식을 제시했습니다.
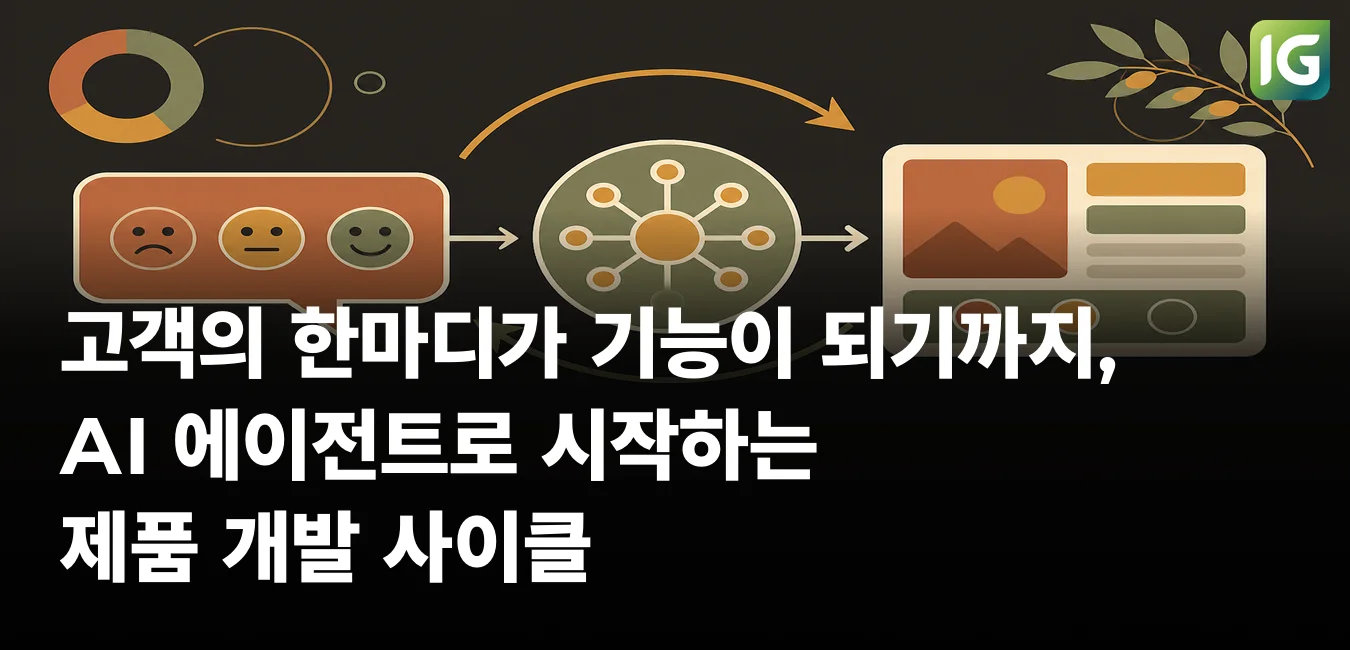
Nelper는 Slack의 고객 요구사항을 AI 에이전트로 구조화해 구현·검증·배포·문서화까지 연결했습니다. 반복 실행은 자동화하고 제품 우선순위와 최종 판단은 사람이 맡았습니다.
Jev를 원고 교정·문체 탐지·자동 발행 점검에 적용해 조건부 활용 방식을 검증했습니다. 문단 판정은 Jev, 반복 규칙은 코드, 사실 검증은 별도 단계로 분리해야 합니다.
이미지 토큰 편차로 발생한 멀티모달 학습 GPU 부하 불균형을 분석했습니다. Pack 재배치와 통신 오버랩으로 품질 저하 없이 처리량을 13.3% 높였습니다.

AWS에서 VLA·강화학습용 Physical AI 학습, 시뮬레이션 검증, 엣지 배포 파이프라인을 구성했습니다. 학습 특성에 따라 SageMaker Pipelines·HyperPod를 선택하고 Greengrass로 모델을 배포합니다.
국내 보안 AI·국방 AX·사우디 디지털트윈·B200 커널 최적화 소식을 소개했습니다. 보안 현장 실증과 GPU 맞춤 최적화로 AI 활용성과 성능을 높였습니다.
무븐트는 AWS 이벤트 기반 파이프라인으로 댄스 영상을 구조화된 학습 데이터로 변환했습니다. GPU 추론과 API를 분리한 다중 계층 서빙으로 성능과 확장성을 개선했습니다.
분산된 업무 이력을 출처가 유지되는 Wiki로 연결했습니다. AI가 설계·구현 판단 전에 과거 근거를 확인하도록 구성했습니다.
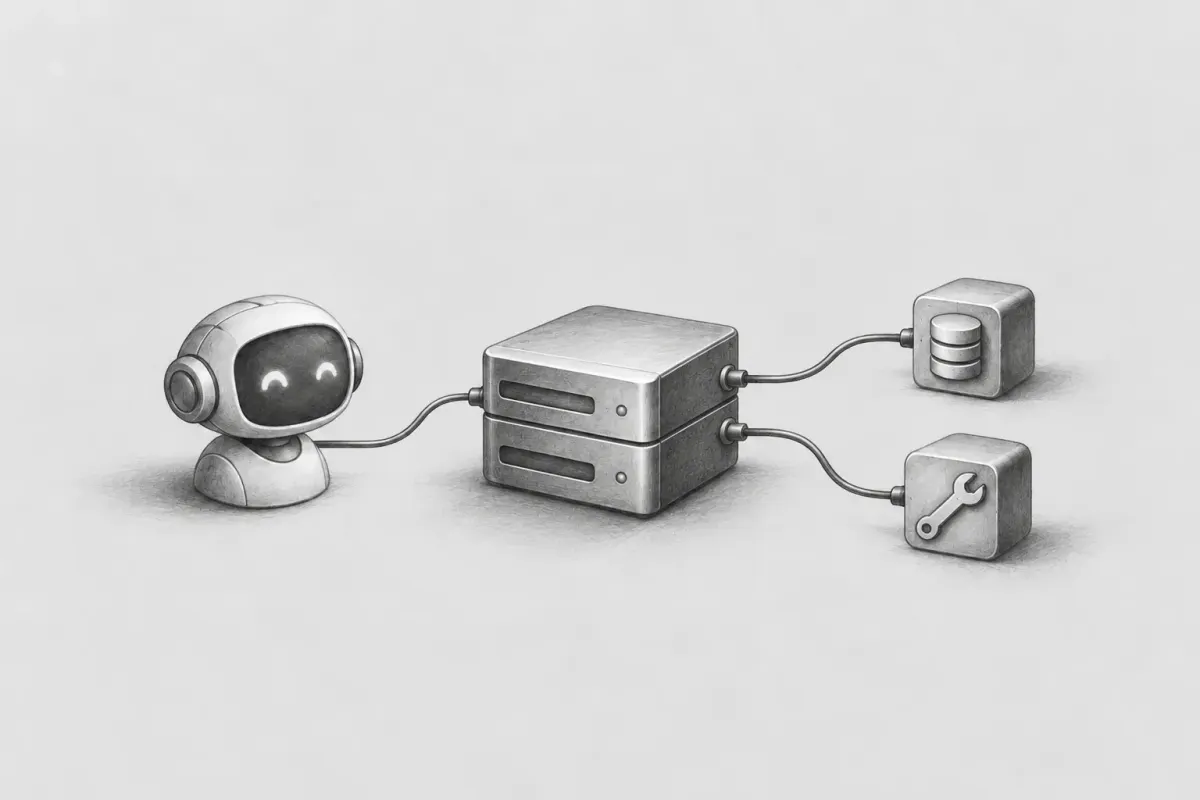
Spring AI로 사내 REST API를 MCP 도구로 노출하는 서버 구축 과정을 정리했습니다. 프로토콜 처리는 위임하고 도구 설계·설명·인증을 핵심 과제로 제시했습니다.

AI 에이전트 도입 전 최신 문서, 접근 권한, 변경 이력을 통합 관리해야 하는 이유를 설명했습니다. 문서중앙화를 통해 잘못된 정보 참조와 권한 침해, 근거 추적 불가 위험을 줄이는 방안을 제시합니다.
실제 AI 제품에서는 모델 성능뿐 아니라 검색 품질과 속도, 사용자 경험까지 함께 고려해야 합니다. 이번 밋업에서는 자체 모델 학습과 검색엔진 고도화 사례를 공유합니다.

Amazon EKS와 NVIDIA FLARE로 연합학습을 구성하는 방법과 CSE 평가 흐름을 설명했습니다. 세 가지 데이터 시나리오를 통해 전역 모델의 수렴, 일반화, 운영상의 관찰 포인트를 보여주었습니다.