
LLM 코딩 에이전트 작업 관리 방법
LLM 코딩 에이전트 작업 관리 방법
LLM 코딩 에이전트를 프롬프트만으로 쓰면 문맥 누적과 임의 판단 문제가 생겼습니다. Task/Plan 하네스로 작업을 분할하고 기록해 안정성과 리뷰 가능성을 높였습니다.
#LLM#prompt
13900

LLM 코딩 에이전트를 프롬프트만으로 쓰면 문맥 누적과 임의 판단 문제가 생겼습니다. Task/Plan 하네스로 작업을 분할하고 기록해 안정성과 리뷰 가능성을 높였습니다.
금융 조직의 AI 적용은 모델보다 신뢰 가능하고 검증 가능한 데이터 기반이 먼저 필요하다고 설명했습니다. Trust, Validity, Context를 갖춘 Finance Data Product와 운영 확장 방향을 소개했습니다.
Databricks Summit 2026의 Agentic Analytics 전략을 정리했습니다. 데이터 플랫폼 중심의 거버넌스와 의미 체계가 Agent 시대의 핵심이라고 설명했습니다.
LLM의 대형 컨텍스트를 단순 누적으로 쓰는 한계를 지적하고 시맨틱 컨텍스트 OS 아키텍처를 제안했습니다. VFS, 톱니 메모리 모델, PathAlign으로 토큰과 코드 컨텍스트를 정제하는 방식이 핵심입니다.
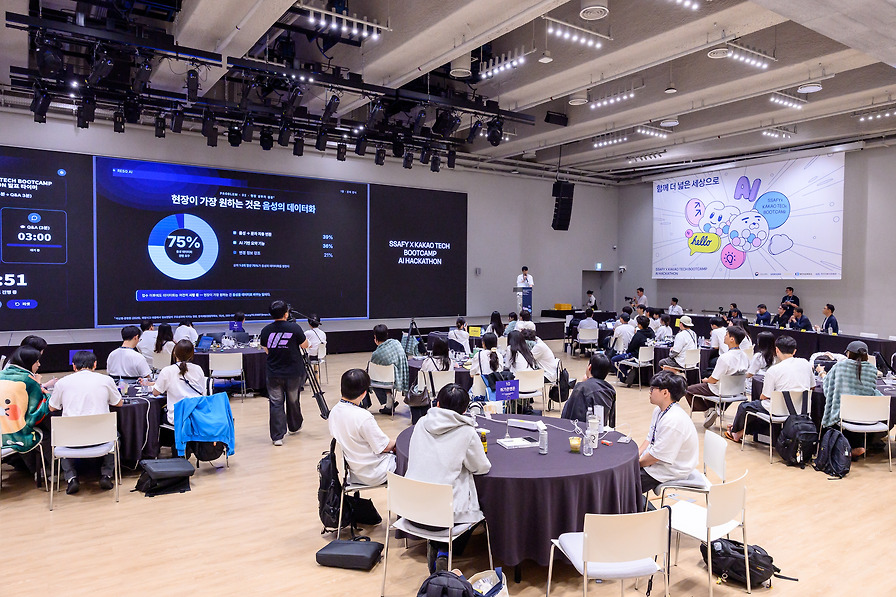
카카오와 삼성이 함께한 첫 AI 해커톤을 소개하는 글입니다. AI로 사회문제를 해결하는 협업 사례와 행사 배경을 다뤘습니다.
수천 개의 서비스를 위한 GPU 공유와 모델 서빙 최적화를 다룬 Automatic Sharding 도입 사례를 소개했습니다. Manual Sharding의 한계를 넘어 자동 반영과 안정적 배포 전략까지 함께 공유했습니다.
생성형 AI로 소프트웨어 규모가 폭발하는 메가 소프트웨어 시대의 변화와 개발자 역할 전환을 다루었습니다. 또한 암묵지 관리 시스템과 자동화된 거버넌스로 복잡성과 품질을 통제할 필요를 강조했습니다.

Technical Writer의 리뷰 기준과 작성 방식을 AI에 학습시켜 문서 작성과 리뷰를 자동화했습니다. 사내 메신저와 GitHub에 붙여 사용 흐름 안에서 바로 문서 작업이 되도록 만들었습니다.
DSPy와 GEPA로 프롬프트 튜닝을 자동화해 조정 시간을 크게 줄인 사례를 소개했습니다. 건강·의료 응답에서 요건 준수와 가독성을 함께 개선한 운영 방법도 다뤘습니다.
AI 코딩 에이전트의 작업을 통제하는 5겹 하네스 구조를 소개했습니다. 자동 검증과 권한 제어로 사람이 설계 리뷰에 집중하는 방식을 설명합니다.
AI Agent가 더 정확하게 동작하도록 통합 Context Provider를 구축한 사례를 공유했습니다. 팀 내 데이터와 서빙 레이어를 자동 수집해 업무 효율화를 높인 경험을 다뤘습니다.


2026년 상반기 AI·클라우드·데이터센터 트렌드를 한눈에 정리했습니다. AI 운영을 위해 인프라 전환, 보안 거버넌스, 비용 관리가 함께 중요해졌습니다.


동원F&B가 Bedrock AgentCore와 OpenSearch 하이브리드 검색으로 AI 쇼핑 어시스턴트를 구축했습니다. 토큰 97% 절감과 TTFT 2.58초 개선, CS 문의 23% 감소 성과를 얻었습니다.
생성형 AI 기반 분석 에이전트로 비즈니스 질문과 데이터 분석을 하나의 흐름으로 연결한 사례를 소개했습니다. 분석 리드타임 단축과 역할 전환, 조직 전체의 분석 역량 축적 효과를 다뤘습니다.