
딥러닝 ‘생성모델’과 ‘잠재 벡터’에 관하여
딥러닝 ‘생성모델’과 ‘잠재 벡터’에 관하여
생성모델이 인식모델과 어떻게 다른지, 그리고 잠재 벡터가 어떤 역할을 하는지 설명했습니다. 오토인코더, GAN, Flow-based 모델을 예로 들어 생성 원리를 정리했습니다.
#ML#생성형 AI
400

생성모델이 인식모델과 어떻게 다른지, 그리고 잠재 벡터가 어떤 역할을 하는지 설명했습니다. 오토인코더, GAN, Flow-based 모델을 예로 들어 생성 원리를 정리했습니다.
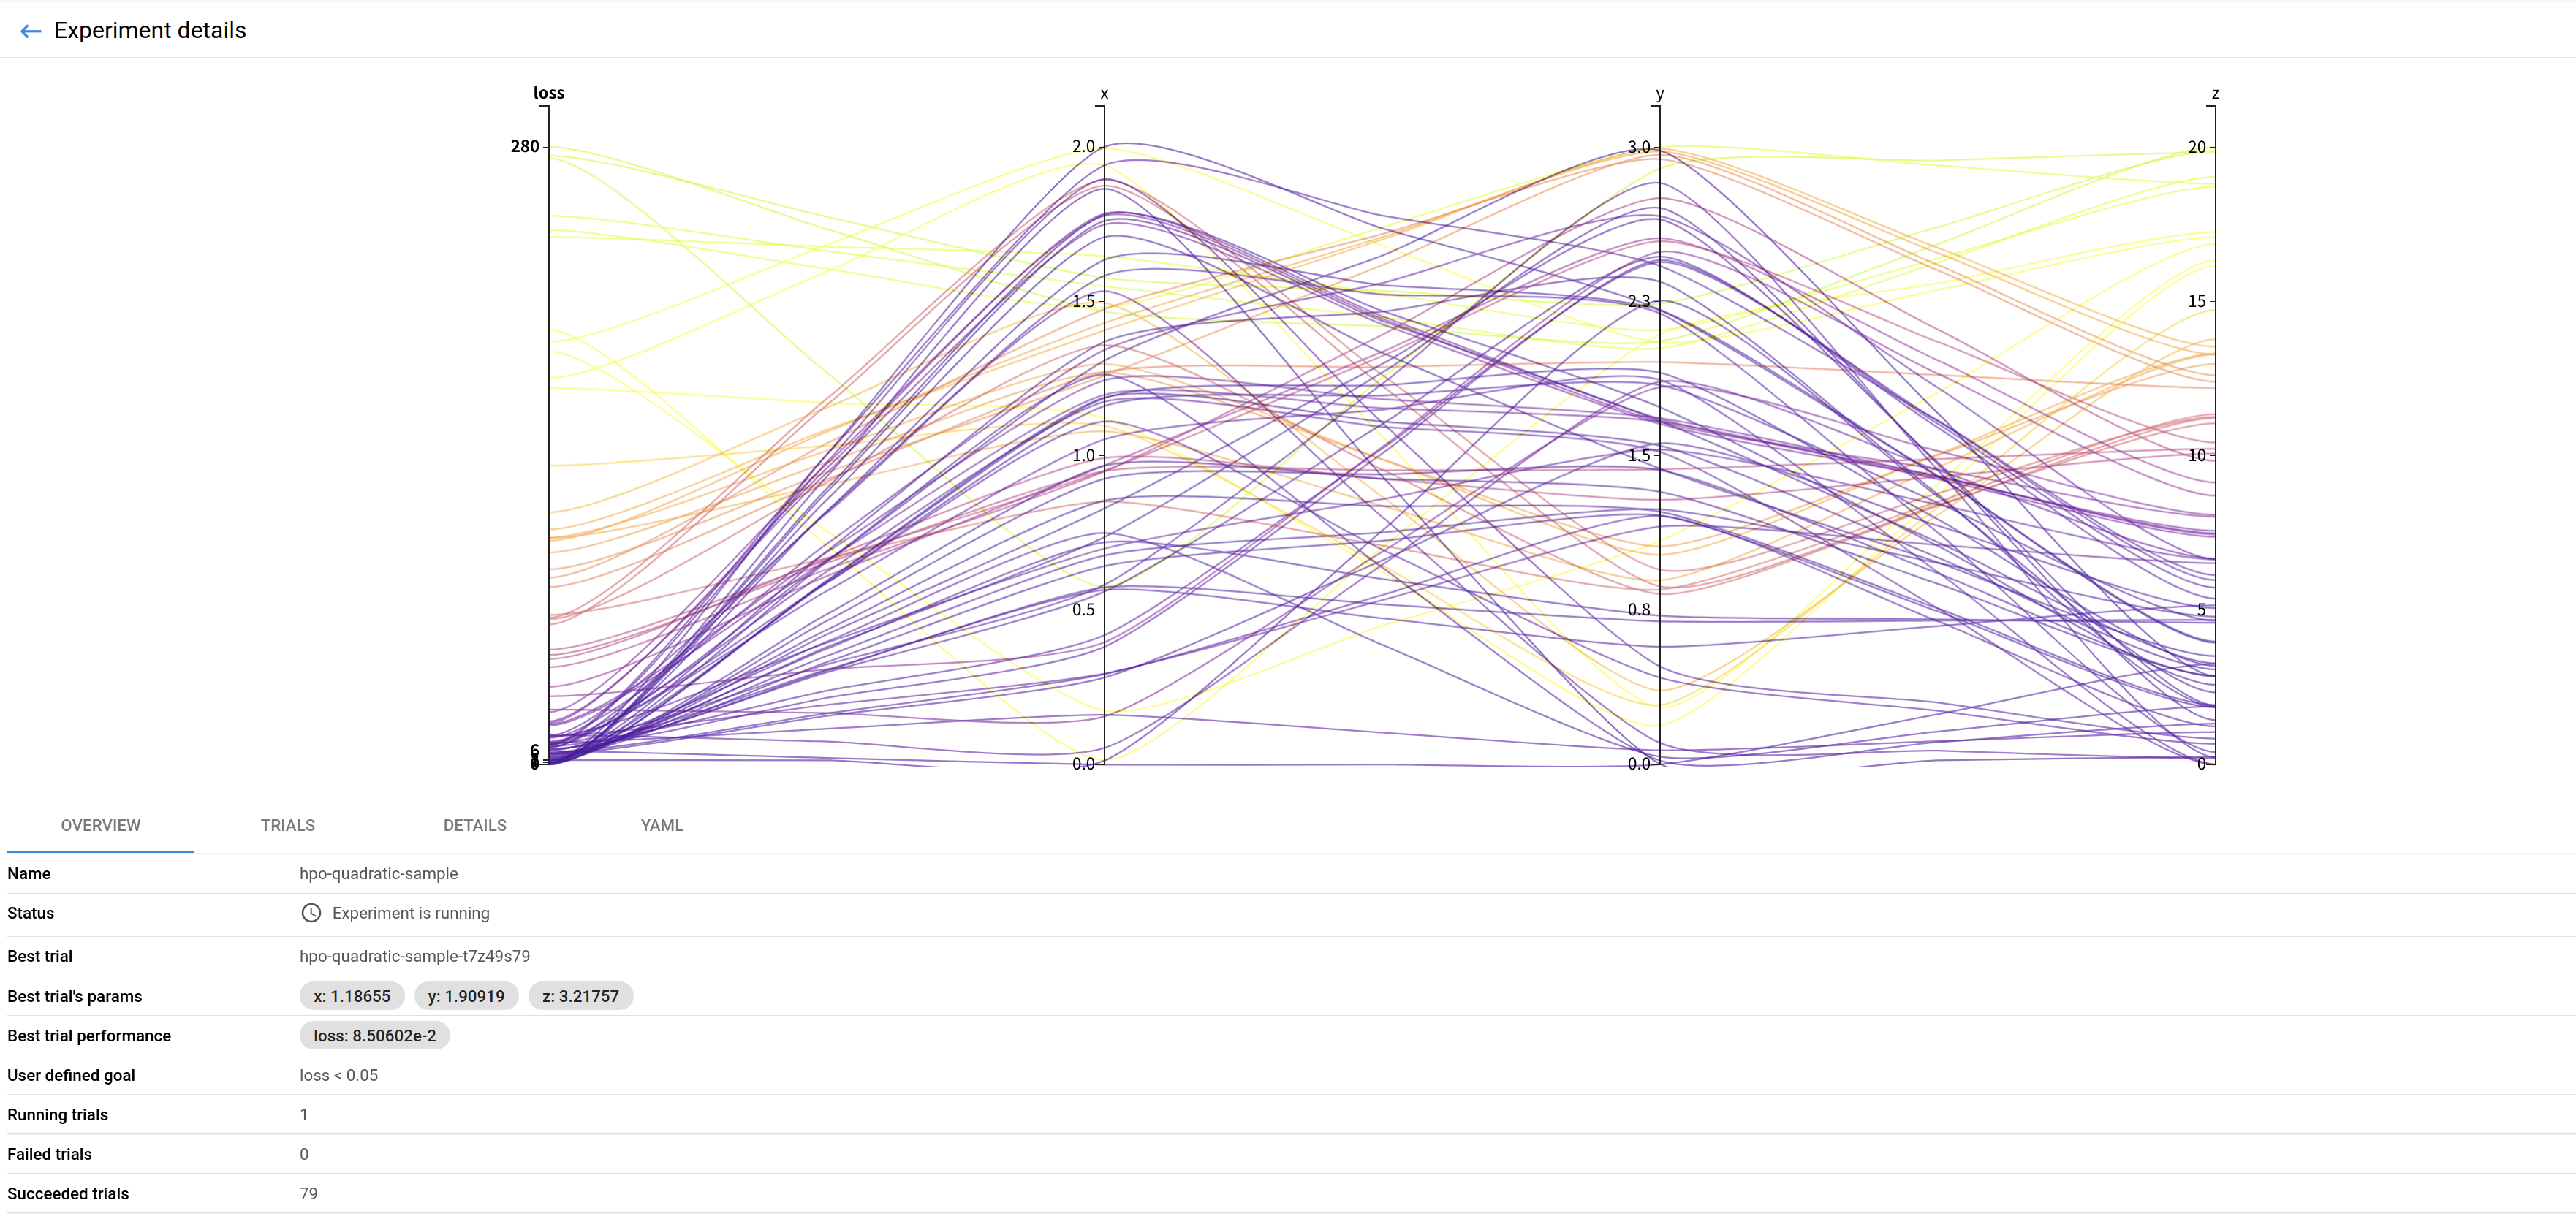
Katib Experiment의 잘못된 요청이 멈춘 상태로 보이는 문제를 분석했습니다. CLI 안전장치와 조기 검증 로직을 오픈소스에 기여했습니다.
Katib Experiment의 잘못된 입력이 멈춘 상태로 보이는 문제를 분석했습니다. CLI 보완과 검증 로직·테스트 PR로 안전한 HPO 사용성을 개선했습니다.

GNN 기반 GKT의 집계·업데이트·예측 구조와 그래프 구성 방식을 소개했습니다. 공개 데이터셋에서 DKT보다 높은 AUC와 학습 개념 관계의 해석 가능성을 확인했습니다.

미응대 상담을 중요도별로 분류해 Slack으로 알리는 시스템을 구축했습니다. KoELECTRA의 높은 재현율을 바탕으로 중요한 상담을 우선 처리하도록 지원합니다.
RLlib의 사용자 지정 포트 분산 학습 오류 원인을 ML-Agents의 포트 연결 방식에서 분석했습니다. worker_id 증가와 유닛 테스트를 추가해 PR로 수정 사항을 반영했습니다.
RLlib Unity3D Wrapper의 사용자 지정 포트 중복 문제를 분석하고 worker_id 증가 방식으로 해결했습니다. 재발 방지 유닛 테스트와 CI·requirements 수정을 거쳐 PR을 머지했습니다.
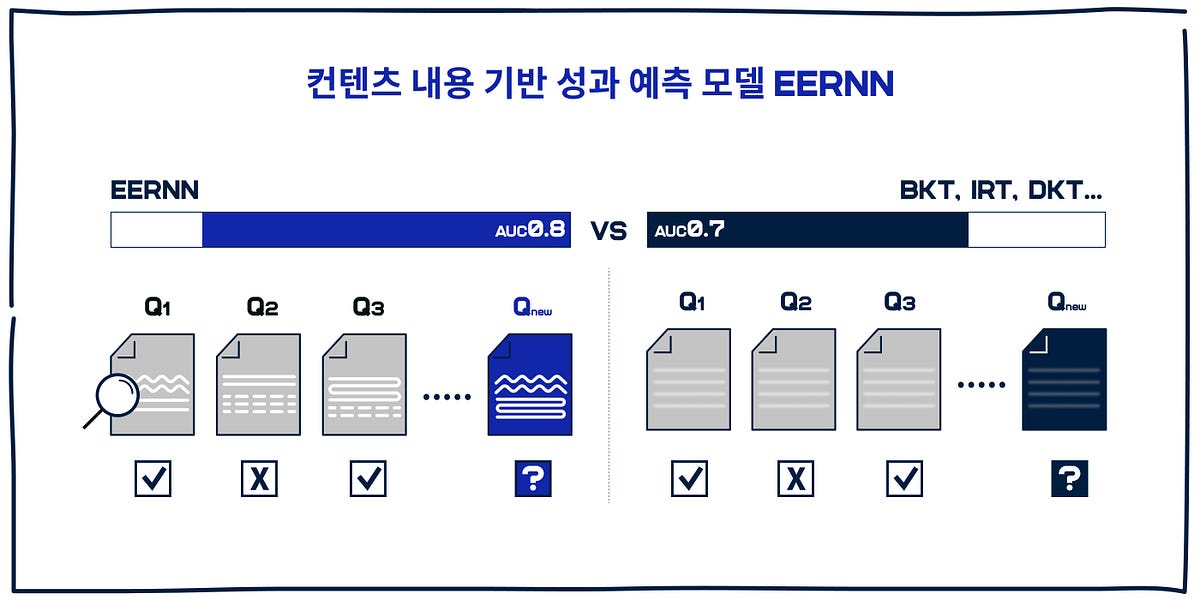
문제 텍스트를 임베딩해 학습자의 정오답을 예측하는 EERNN 구조를 소개했습니다. Attention 기반 과거 문제 연관성 활용과 실험 결과를 분석했습니다.

CMS가 웹사이트 확산에 기여한 사례를 바탕으로 챗봇 빌더의 필요성을 설명했습니다. 챗봇 시장은 클라우드 기반 CBaaS와 API 연동형 서비스로 성장할 것으로 전망했습니다.
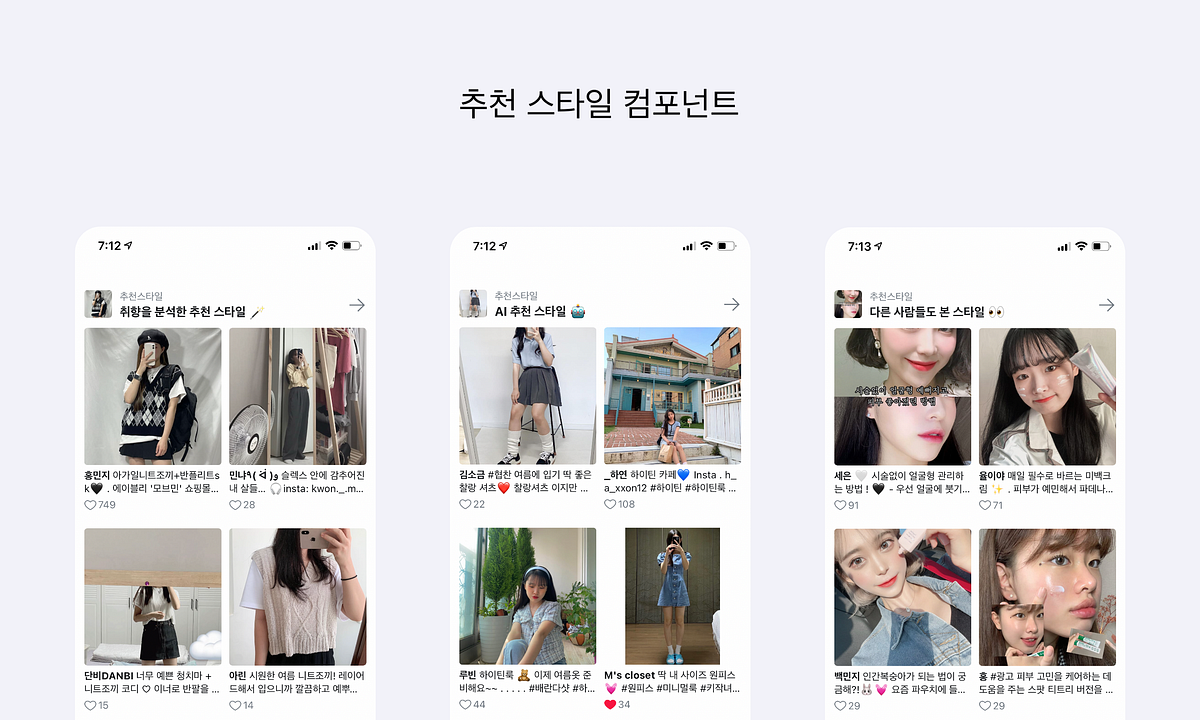
사용자 임베딩과 Mini Batch K-Means로 관심사별 스타일 묶음을 추천했습니다. A/B 테스트에서 클릭과 콘텐츠 전환율 상승을 확인해 전체 릴리즈했습니다.

인간 이상의 지적 능력을 목표로 하는 범용 AI의 현실 가능성을 살펴봤습니다. 기술 공포보다 사회적 수용 준비가 선행돼야 함을 강조합니다.
GAN의 생성·판별 모델 개념과 GANomaly 기반 이미지 이상탐지 구조를 설명했습니다. 세 종류의 손실과 이상 점수 산출로 MNIST 정상·비정상 분류를 구현했습니다.

AIEd 포럼을 중심으로 AI 기반 교육격차 해소와 교육 현장 도입 준비를 소개했습니다. AI 운영 자동화 오픈소스와 정오답예측 모델의 설명 가능성 연구도 다뤘습니다.

비정형 화장품 리뷰에서 약 80개 제품 속성을 추출하는 멀티 출력 딥러닝 모델을 개발했습니다. 토픽 추가와 운영 부담을 줄이고, 0.85~0.95 정확도 및 제품 특성 검증 결과를 확인했습니다.