

Machine Learning으로 찾아본 알라미 유저들의 사용패턴
알라미 유저의 사용 패턴을 Feature Engineering과 KMeans 클러스터링으로 분석한 사례입니다. 숫자 결과에 해석을 붙여 페르소나처럼 설명하고 리텐션까지 확장했습니다.
#ML#Python
4900
알라미 유저의 사용 패턴을 Feature Engineering과 KMeans 클러스터링으로 분석한 사례입니다. 숫자 결과에 해석을 붙여 페르소나처럼 설명하고 리텐션까지 확장했습니다.

LLM 지식 증류의 개념과 주요 방법론을 정리한 글입니다. Teacher 모델의 지식을 Student 모델에 이전하는 방식과 구현 접근을 소개했습니다.

DeepSeek-R1의 구조와 학습 방식, GRPO와 지식 증류의 특징을 OpenAI o1과 비교해 정리했습니다. 비용 절감과 추론 성능 강점, 한국어 적용 시 주의점도 함께 살펴봤습니다.

DocumentDB 슬로우쿼리를 수집·시각화하고, COLLSCAN 쿼리에 대해 AI로 인덱스를 추천받는 파이프라인을 구축했습니다. 이를 통해 슬로우쿼리 합계가 약 30% 감소하고 무거운 쿼리가 개선되었습니다.
LLM as a Judge를 활용해 CodeBuddy의 성능 평가를 다룬 글입니다. AI 모델과 응답 품질을 평가하는 방법론을 소개했습니다.
PyTorch 2.x의 핵심 기능인 Torch Compile을 소개하는 글입니다. 딥러닝 성능을 높이는 관점에서 PyTorch 2.0의 변화 포인트를 다뤘습니다.


Amazon Bedrock 사용자 지정 모델로 DeepSeek-R1 Distill Llama를 배포하는 방법을 안내했습니다. 서버리스 호스팅, 비용 구조, 버전 관리와 모니터링 포인트도 함께 정리했습니다.

LLM 기반 AI 에이전트의 Tool Calling 한계를 Code Interpreter로 확장하는 흐름을 설명했습니다. Docker 샌드박스와 LangGraph로 안전하게 적용하는 예시도 함께 다뤘습니다.

자연어 검색 에이전트의 품질을 높이기 위해 Entity RAG와 Knowledge-aware retrieval을 적용한 사례를 소개했습니다. 신규 개체 인식과 테마 질의 대응 성능이 개선되었고, 향후 적용 범위 확대도 제시했습니다.
Amazon Bedrock의 지연 시간 최적화 추론이 LLM 응답성 개선에 어떻게 기여하는지 정리했습니다. TTFT, OTPS, E2E 지표와 함께 프롬프트·아키텍처 최적화 방법도 살펴보았습니다.
RAG와 LangChain, LangGraph의 역할과 구조를 비교해 AI Agent 개발 관점을 정리했습니다. 빠른 개발에는 LangChain, 복잡한 워크플로우에는 LangGraph가 적합하다고 설명했습니다.
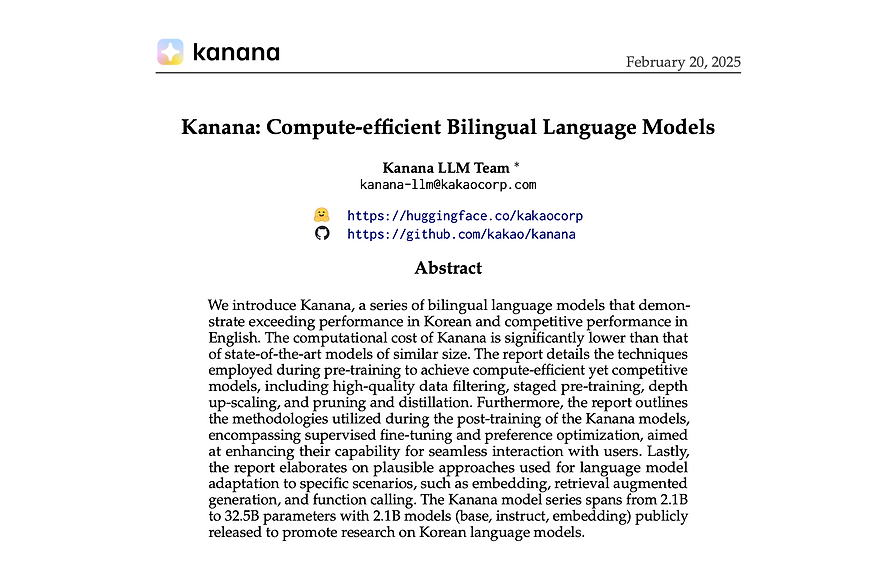
카카오가 서비스 적용에 최적화한 언어모델 Kanana의 테크니컬 리포트를 공개했습니다. 높은 성능, 비용 효율성, 안전성을 함께 고려한 자체 AI 모델 방향을 소개했습니다.

LLM으로 중고 스마트폰 게시글에서 시세 산정용 정보를 추출하고 후처리하는 서비스를 구축했습니다. BigQuery, MySQL, 벡터 DB를 조합해 시세 조회와 유사 게시글 추천을 구현했습니다.
Amazon Bedrock과 Lambda, API Gateway를 연결해 긴 텍스트 요약 API를 구성하는 과정을 다루었습니다. 요청 전달, IAM 권한, 응답 처리와 테스트 방법까지 실습 중심으로 설명했습니다.