
Spark 4편 – Broadcast
Spark의 Broadcast 기능으로 셔플을 줄이고 join 성능을 높이는 방법을 소개했습니다. 작은 데이터셋에는 자동 broadcast 감지와 설정 조건도 함께 설명했습니다.
#Spark#broadcast#cache
4600
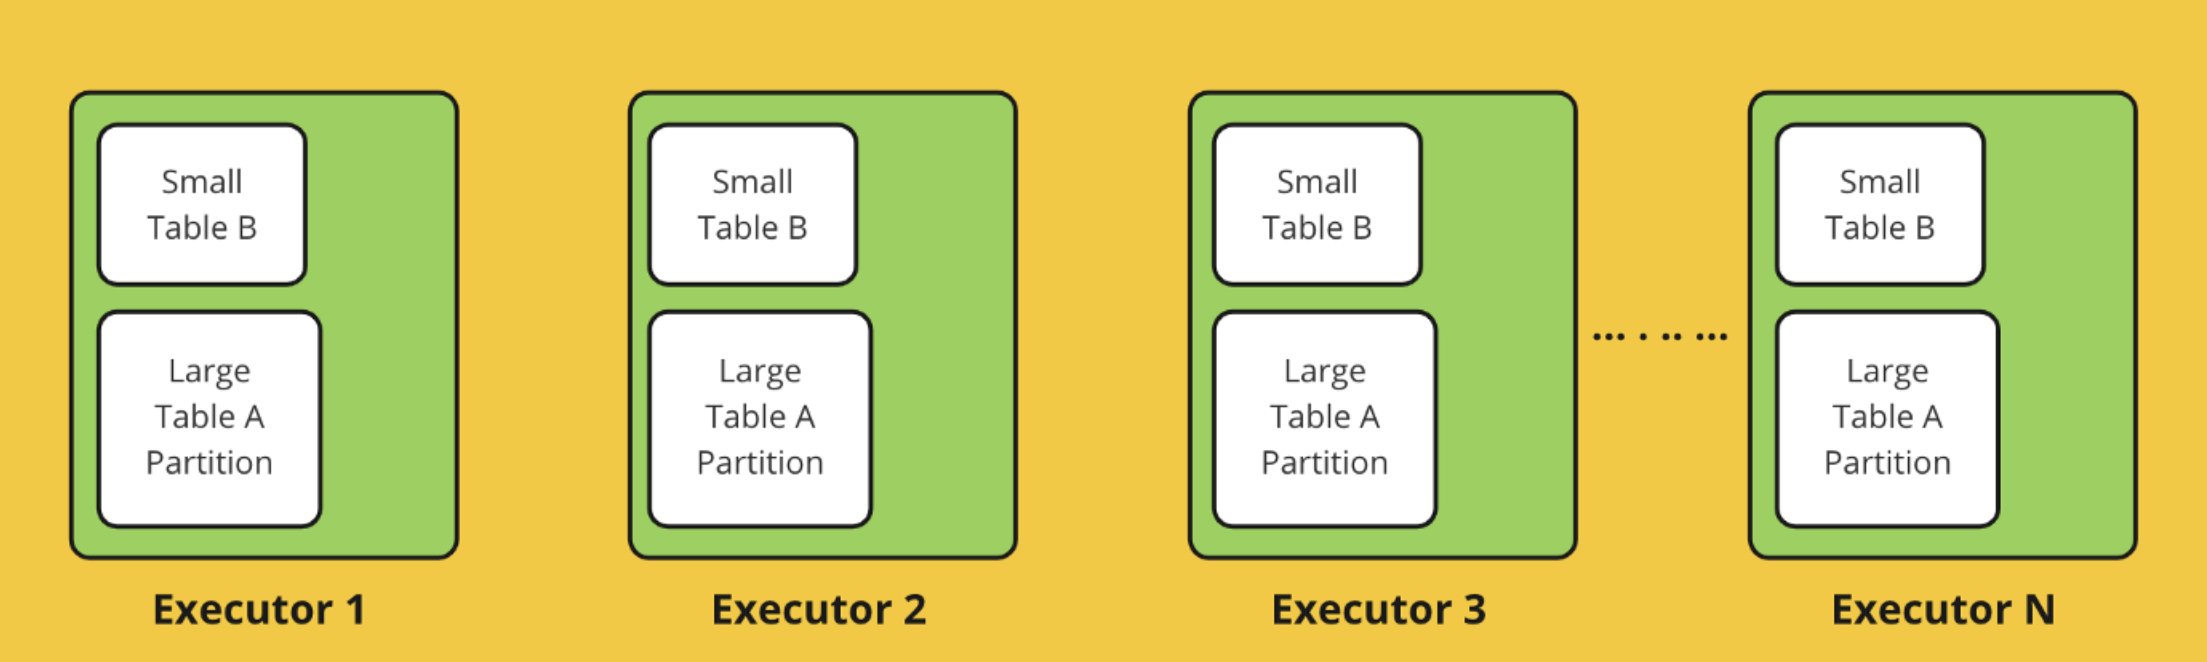
Spark의 Broadcast 기능으로 셔플을 줄이고 join 성능을 높이는 방법을 소개했습니다. 작은 데이터셋에는 자동 broadcast 감지와 설정 조건도 함께 설명했습니다.
Spark에서 파티션이 병렬성, 메모리, 파일 수에 미치는 영향을 설명했습니다. 입력·출력·셔플 파티션 설정을 조정해 성능을 최적화하는 방법을 소개했습니다.
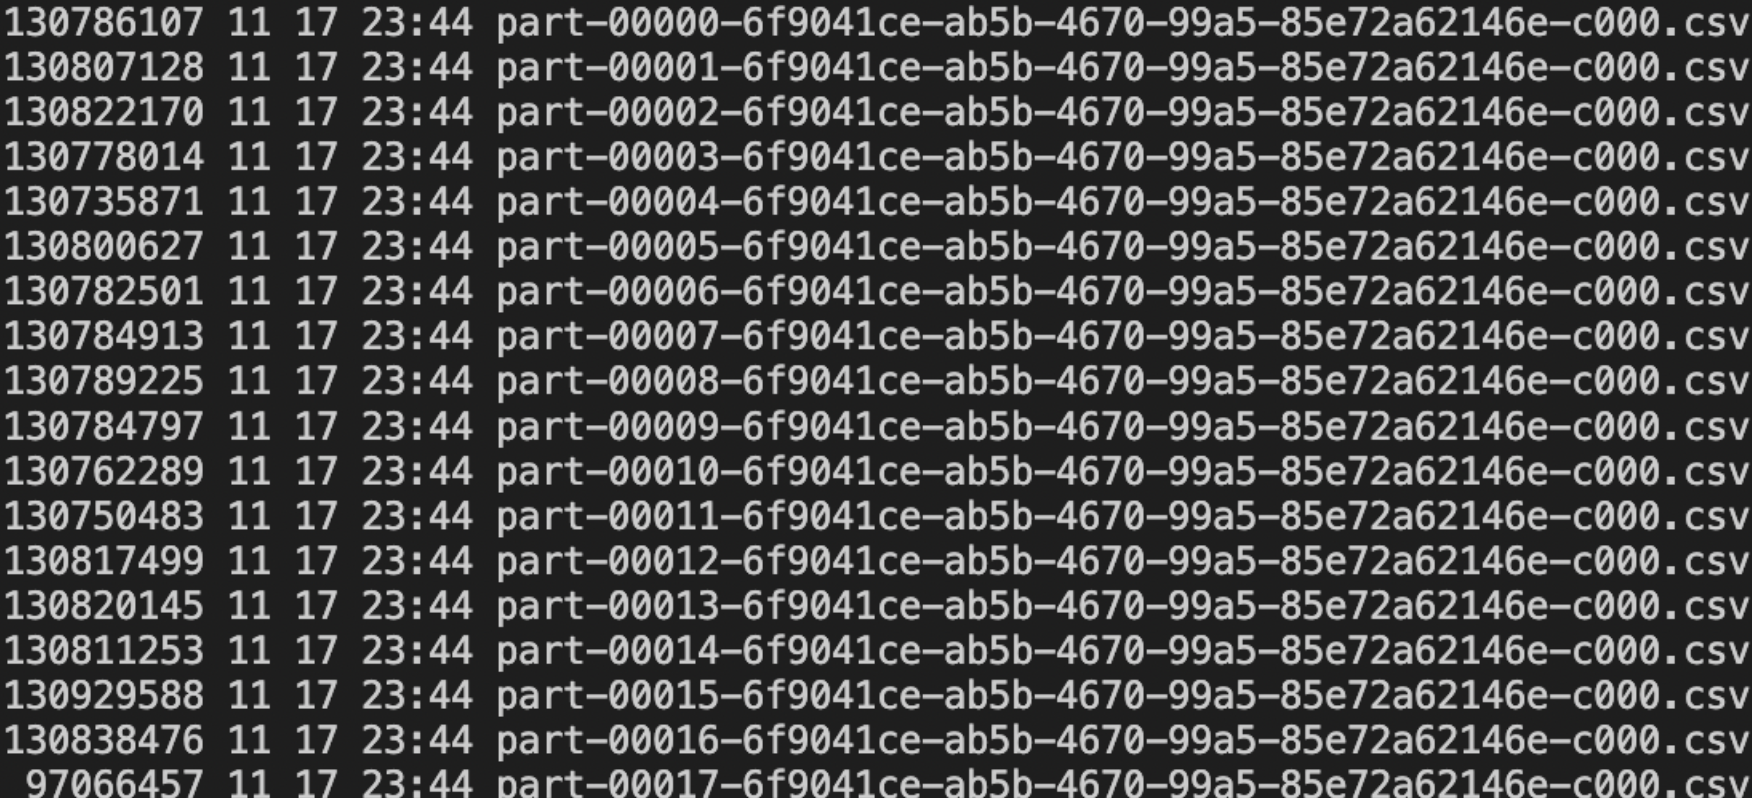
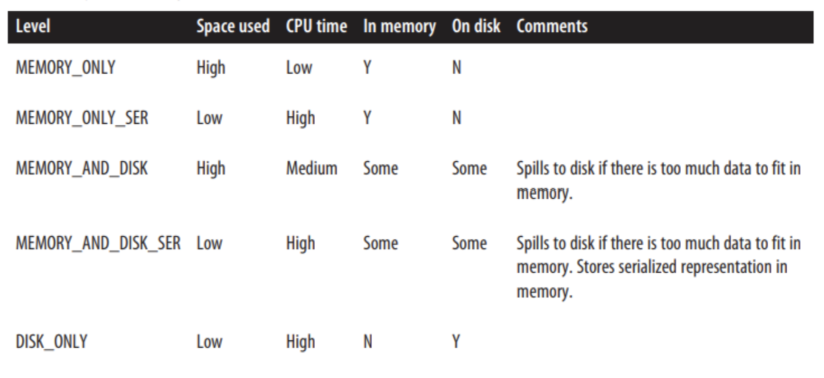
Spark의 Cache와 Persist 개념과 사용 시 주의점을 설명했습니다. 메모리 부족으로 인한 spill over를 줄이는 대응 방법도 소개했습니다.
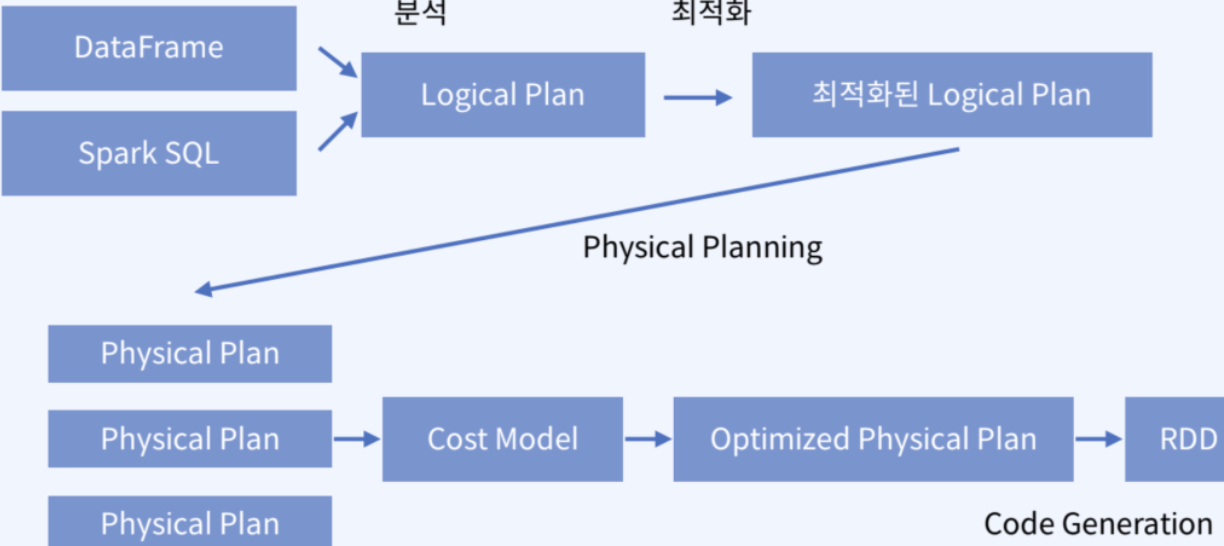
Spark의 동작 방식과 Catalyst, Tungsten 최적화 역할을 소개했습니다. 논리 계획과 물리 계획, Predicate Pushdown 같은 핵심 개념을 설명했습니다.
Spark의 개요와 주요 구성요소, 장점을 정리한 글입니다. 대용량 데이터 처리에서 Pandas보다 Spark가 더 적합한 성능 사례도 비교했습니다.
AWS Parameter Store와 CodeBuild 환경변수를 활용해 EKS에서 단일 애플리케이션을 여러 POD로 다중 배포하는 방법을 소개했습니다. 또한 CodeBuild의 EKS 인증 오류를 IAM 권한 추가로 해결한 과정을 다뤘습니다.

EKS에서 단일 애플리케이션을 환경별 변수만 바꿔 여러 POD으로 배포하는 방식을 소개했습니다. Parameter Store와 CodeBuild 설정, ECR 연동과 빌드 명령 변경 내용을 다뤘습니다.

AWS EKS에서 단일 애플리케이션을 환경 변수만 바꿔 다중 배포하는 방법을 소개했습니다. 또한 Parameter Store, CodeBuild, ECR, Dockerfile 설정 예시를 함께 설명했습니다.

AWS EKS에서 단일 애플리케이션을 환경변수만 바꿔 다중 배포하는 방법을 소개했습니다. React 샘플, CodeCommit 연동, Parameter Store와 CodeBuild 설정 흐름을 정리했습니다.

EC2에서 Docker를 이용해 Jenkins를 쉽게 설치하는 방법을 소개합니다. 컨테이너 기반으로 설치 절차를 단순화하는 접근을 다룹니다.

Kubeflow의 개념을 소개하는 글입니다. MLOps 관점에서 Kubeflow가 무엇인지 간단히 안내했습니다.

LLM 기반 AI 플랫폼에서 LangChain을 활용한 RAG 구성 방법을 소개합니다. RAG 파이프라인을 어떻게 구성하고 적용할지 다룹니다.

쿠버네티스 배포에서 Helm Operator를 소개하는 글입니다. Helm Chart를 단일 파일처럼 관리하고 명령어로 배포하는 방식에 초점을 맞췄습니다.
Kubernetes 패키지 관리자 Helm과 Helm Chart의 기본 개념과 구조를 소개했습니다. 템플릿을 활용해 애플리케이션 설치와 관리를 쉽게 하는 방법을 다뤘습니다.
Kubernetes에서 여러 스케줄러를 구성하고 Pod별로 할당하는 방법을 설명했습니다. 설정된 스케줄러가 실제로 어떻게 동작하는지도 함께 다루었습니다.
Kubernetes DaemonSet의 개념과 활용 사례, YAML 구성을 소개했습니다. 또한 1.12 전후의 동작 방식 차이도 함께 설명했습니다.
Kubernetes에서 Pod를 특정 노드에 배치하는 방법을 다뤘습니다. Node Selector와 Node Affinity, 그리고 Pod 생명 주기별 동작을 설명했습니다.