XSS Filter를 통한 웹 보안 강화 방법
XSS 공격의 개념과 유형을 정리하고, 필터를 활용한 방어 방법을 소개했습니다. Servlet Filter 예시 코드를 통해 요청 래핑 방식도 함께 보여주었습니다.
#XSS#Java#보안
53500

XSS 공격의 개념과 유형을 정리하고, 필터를 활용한 방어 방법을 소개했습니다. Servlet Filter 예시 코드를 통해 요청 래핑 방식도 함께 보여주었습니다.
다중 클러스터 kubeconfig 환경에서 현재 클러스터를 인지시키고 선택 실수를 줄이는 인터랙티브 프롬프트를 소개했습니다. 함께 관련 bash shell 예시와 적용 맥락도 설명했습니다.

Gemma sLLM을 한국어 요약용으로 파인튜닝하는 과정을 Hugging Face와 QLoRA 기반으로 소개했습니다. 데이터셋 준비부터 프롬프트 구성, 학습, 병합 모델 추론까지의 흐름을 정리했습니다.

MWAA에서 Oracle 쿼리 수행 시 발생한 `DPY-3015` 오류의 원인과 해결 방법을 정리했습니다. thin 모드 제약을 피하려면 thick 모드 전환과 Oracle Client 설치가 필요했습니다.

GitLab의 push option을 이용해 CLI에서 Merge Request를 생성하는 방법을 소개했습니다. 브랜치 생성, 커밋, `git push -o` 설정으로 MR 자동화 과정을 정리했습니다.

AWS Lambda와 API Gateway를 연동해 Account Health Event를 슬랙에서 관리하는 방법을 소개했습니다. 슬래시 명령어로 완료 처리, 목록 조회, 삭제까지 수행하는 흐름을 설명했습니다.

AWS Lambda와 EventBridge로 AWS Health Event를 감지해 슬랙으로 전송하는 구성 사례입니다. S3에 이력을 저장하고 매일 09시에 미처리 이벤트를 재전송하도록 구현했습니다.

분산된 데이터 플랫폼의 메타데이터를 통합 관리하는 DataHub의 개념과 주요 기능을 소개했습니다. 검색, 계보 추적, 거버넌스, 접근 제어 관점에서 활용 포인트를 정리했습니다.

데이터레이크 확산으로 데이터 카탈로그와 거버넌스의 중요성을 설명했습니다. 오픈소스 Datahub의 메타데이터 수집, 검색, 리니지, 연동 기능을 소개했습니다.

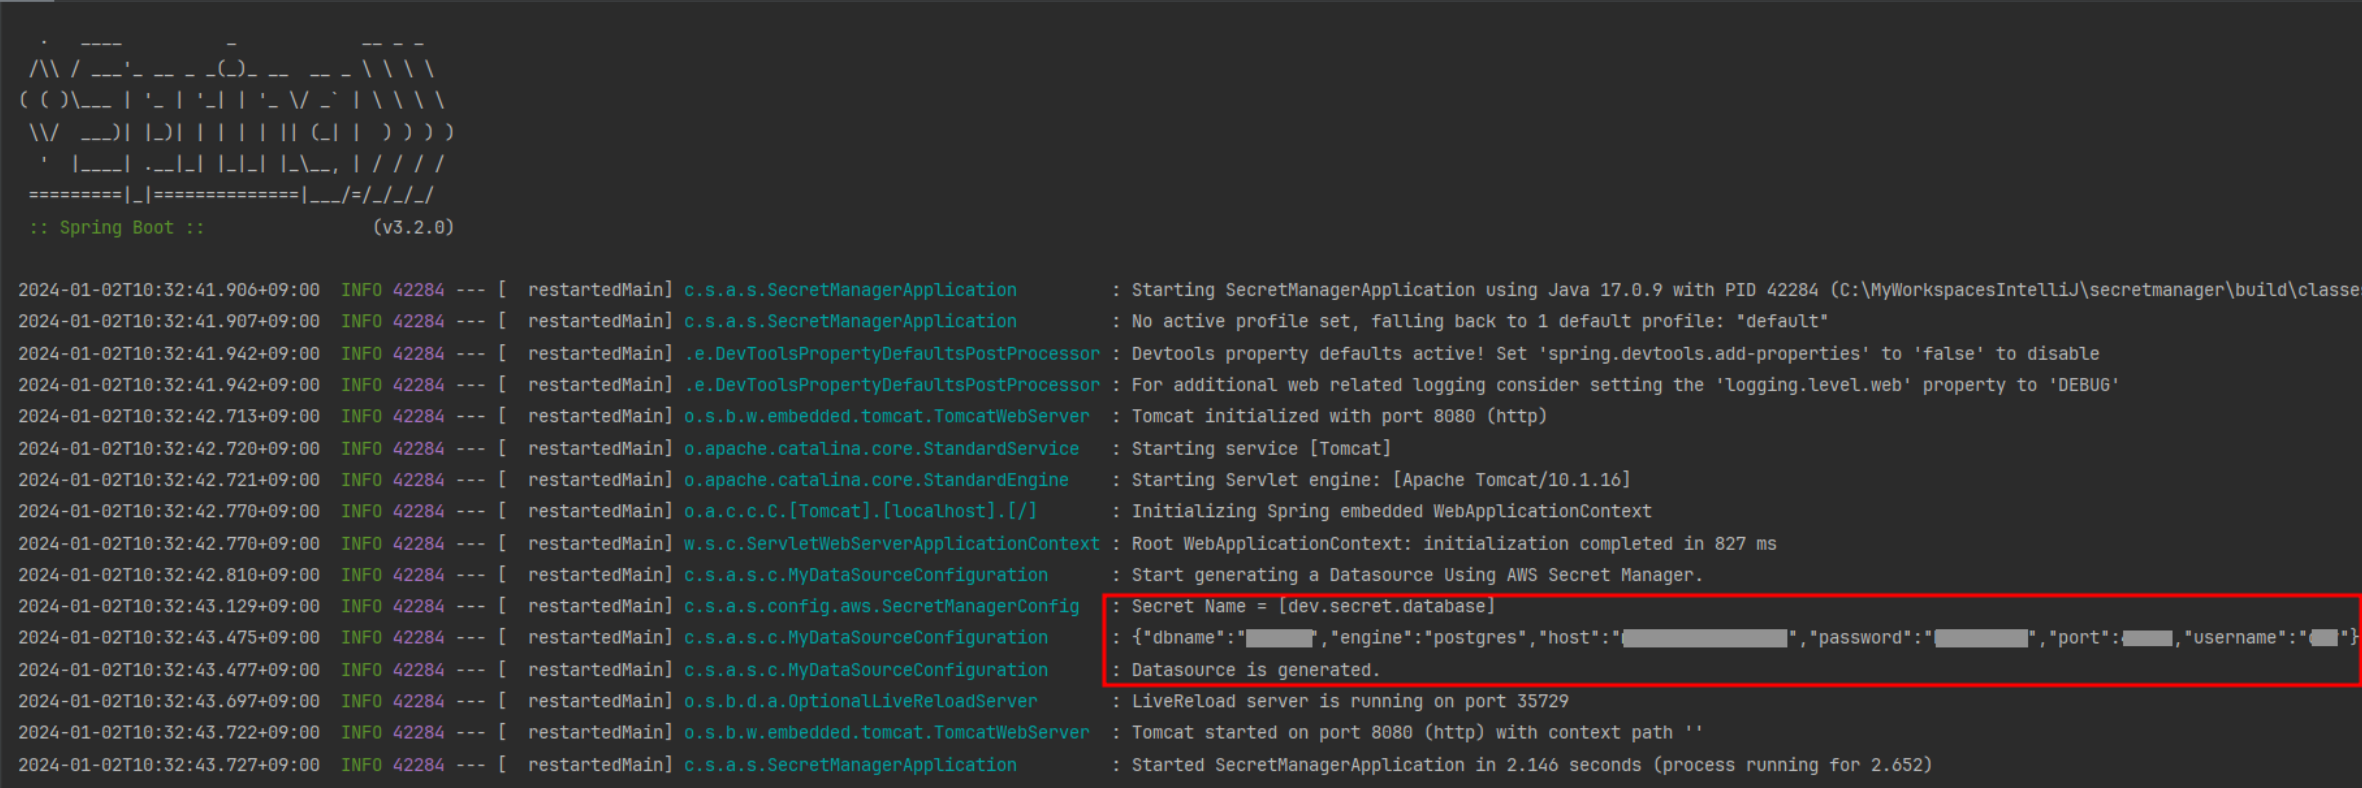
Spring Boot 시작 시 AWS Secrets Manager에서 DB 정보를 조회해 DataSource를 생성하는 방법을 소개했습니다. 자동 설정을 제외하고 Secret JSON을 파싱해 PostgreSQL 연결 정보를 주입하는 예시를 다뤘습니다.
Python의 기본 개념과 특징, 장점을 소개한 글이었습니다. 여러 기업의 활용 사례를 통해 실무 적용 가능성도 함께 설명했습니다.

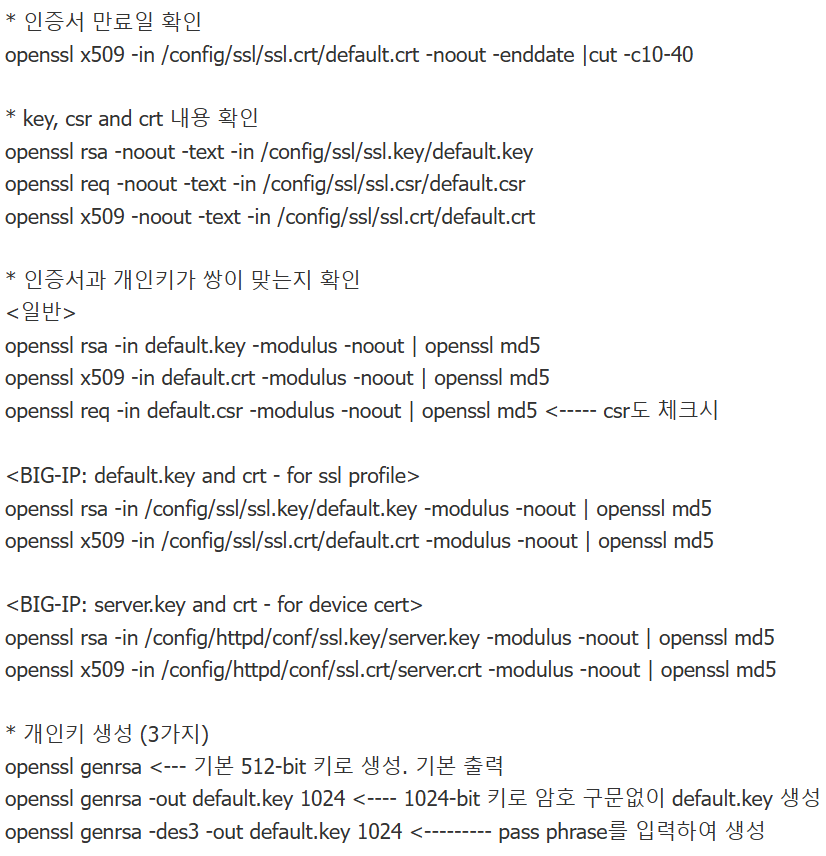
SSL 트러블슈팅에 자주 쓰는 openssl 명령어들을 한눈에 정리했습니다. 인증서 확인, 키 검증, 포맷 변환, 추출과 암복호화 예시까지 담았습니다.
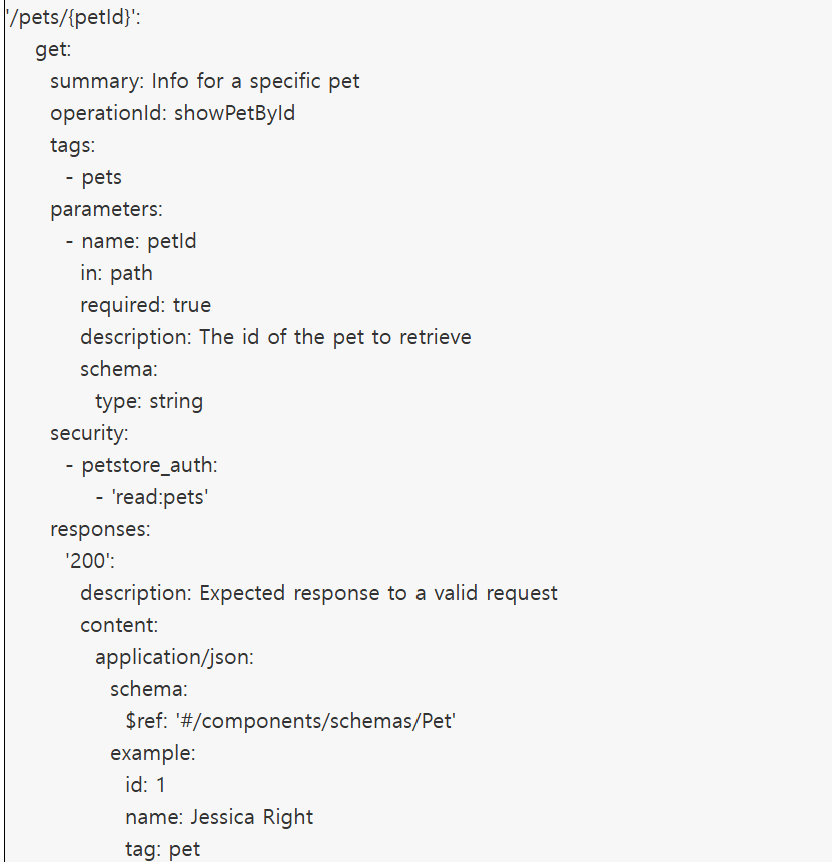
OpenAPI 3.0 스펙을 설계 우선 관점에서 작성하는 원칙과 주의점을 정리했습니다. 보안, 스키마 재사용, 예제, 코드 생성을 통해 API 계약 품질을 높이는 방법을 소개했습니다.
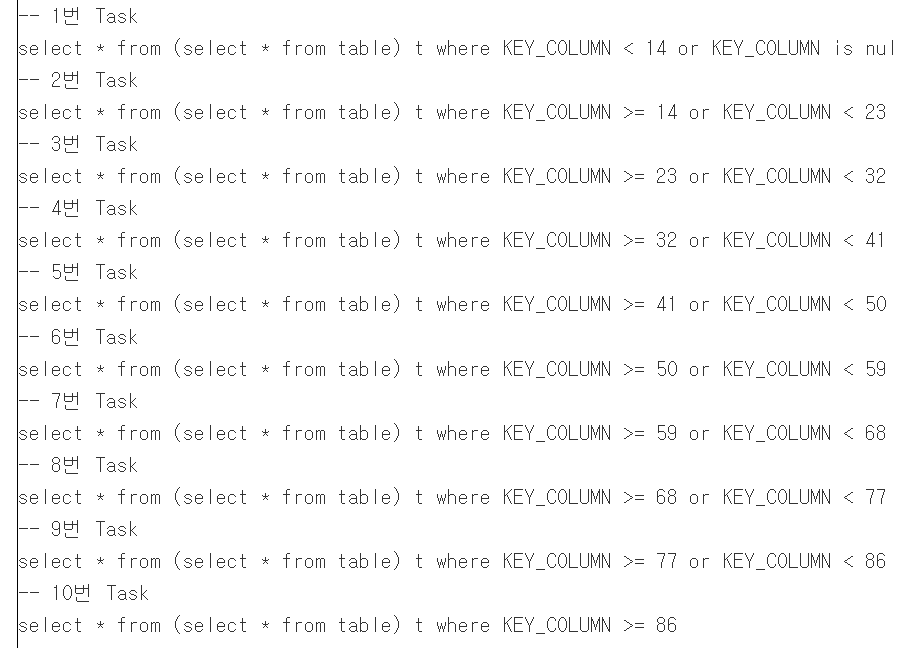
Spark JDBC 병렬처리의 기본 사용법과 파티션 분할 방식의 주의점을 설명했습니다. 소수점 버림으로 인한 skew를 줄이기 위해 upperBound 설정과 컬럼 분포 점검이 필요했습니다.
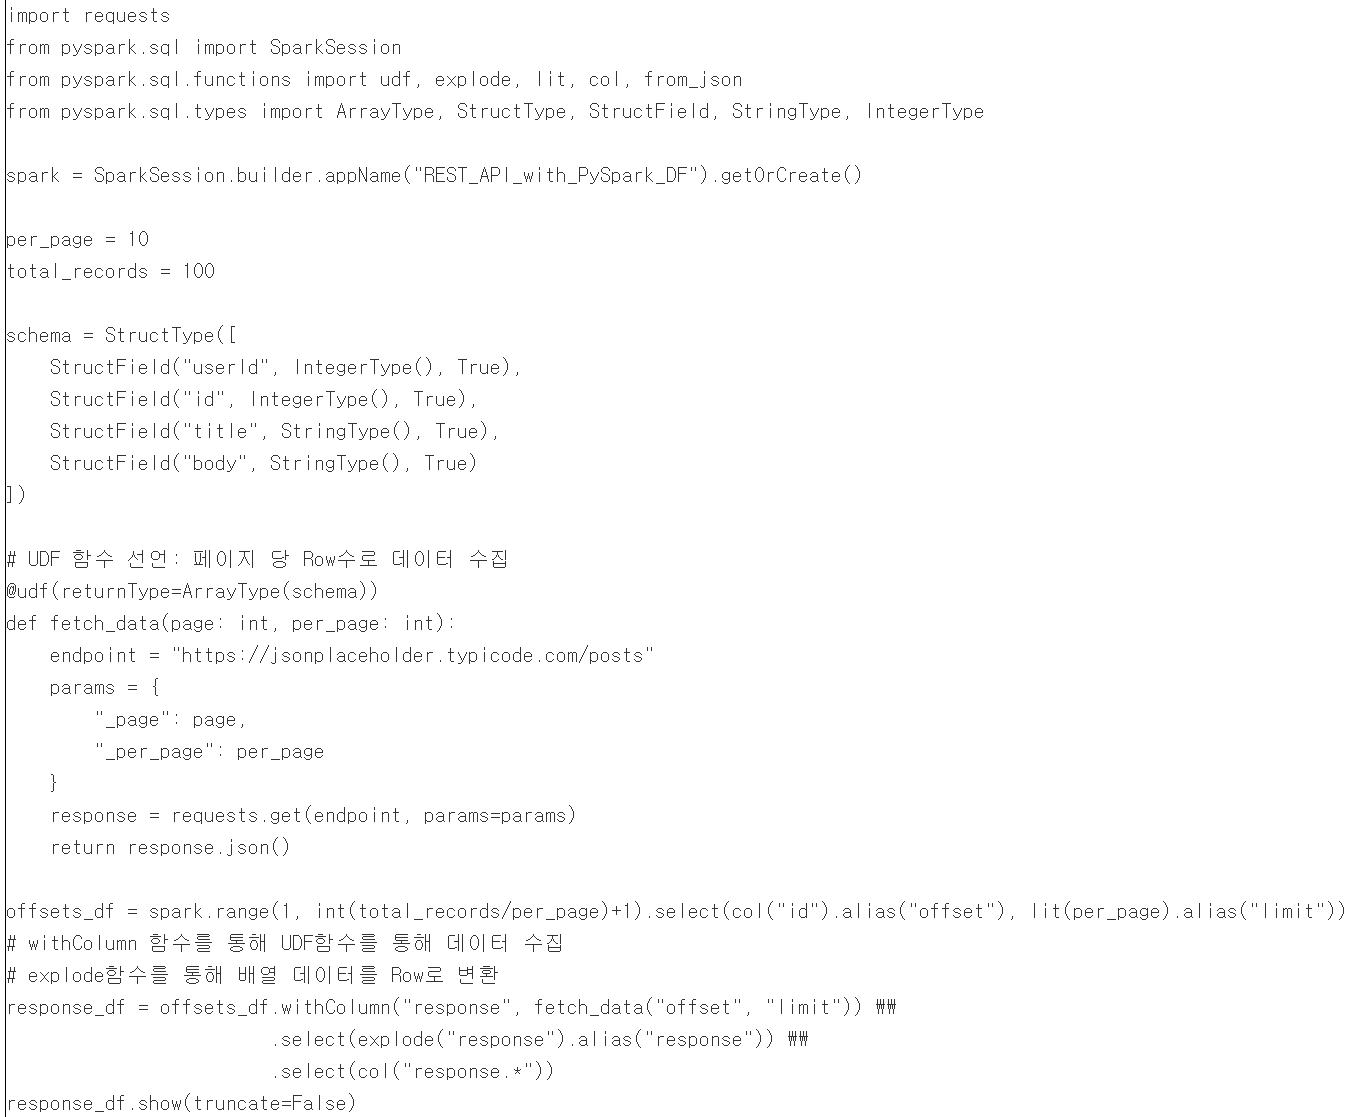
Spark에서 Rest API 데이터를 수집하는 두 가지 방법을 비교했습니다. 단순 requests 방식과 Spark UDF 방식의 장단점 및 대량 데이터 처리 시 고려점을 설명했습니다.
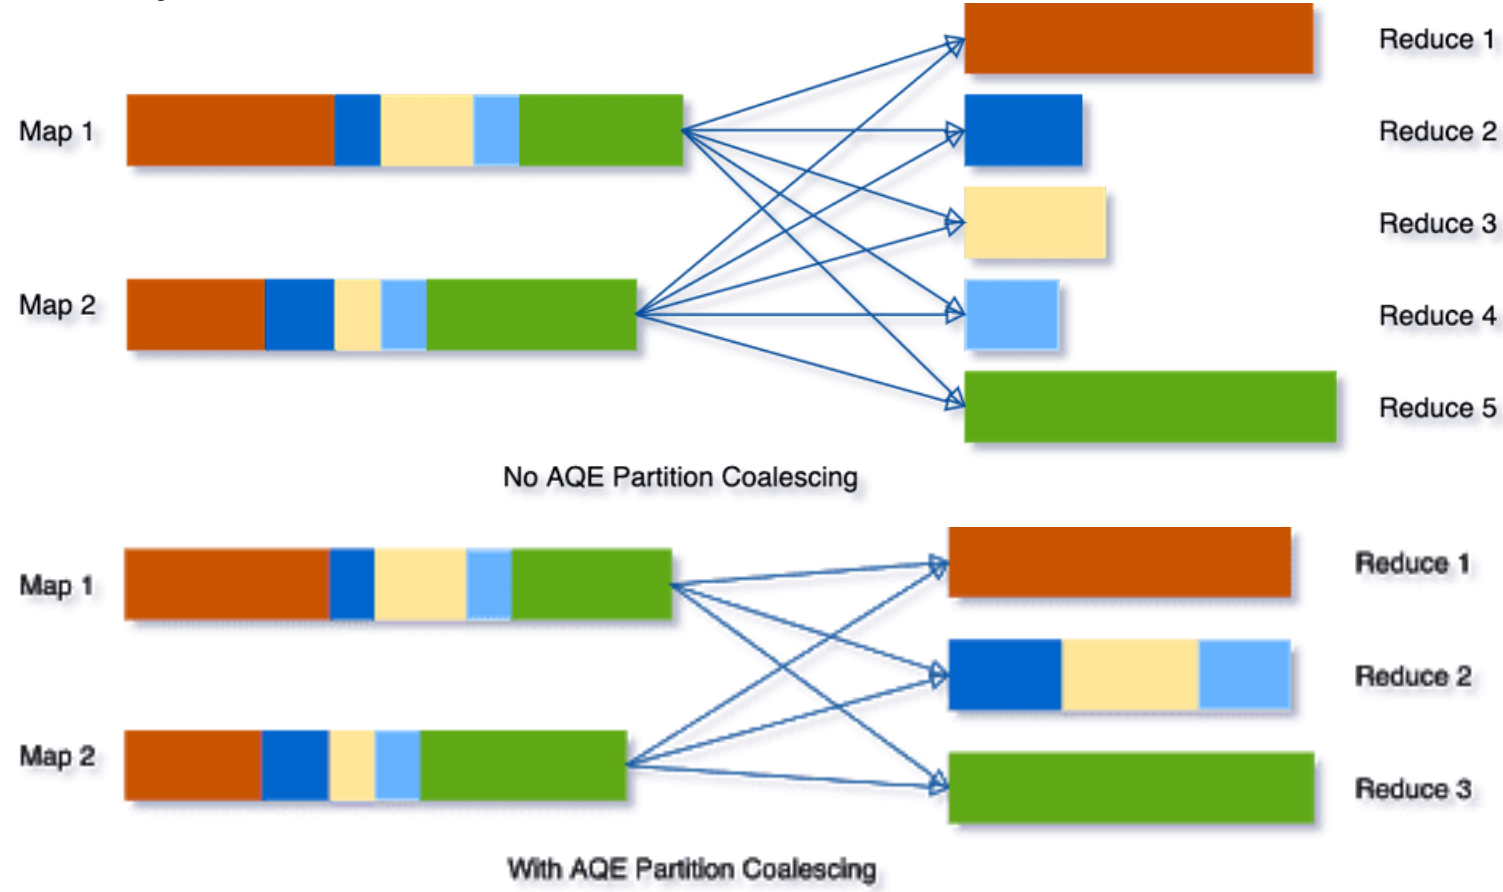
Spark 3.0의 AQE와 coalescePartitions로 셔플 파티션을 동적으로 최적화하는 내용을 소개했습니다. 셔플 파티션 크기에 따른 성능 저하 문제와 파티션 병합 방식도 설명했습니다.
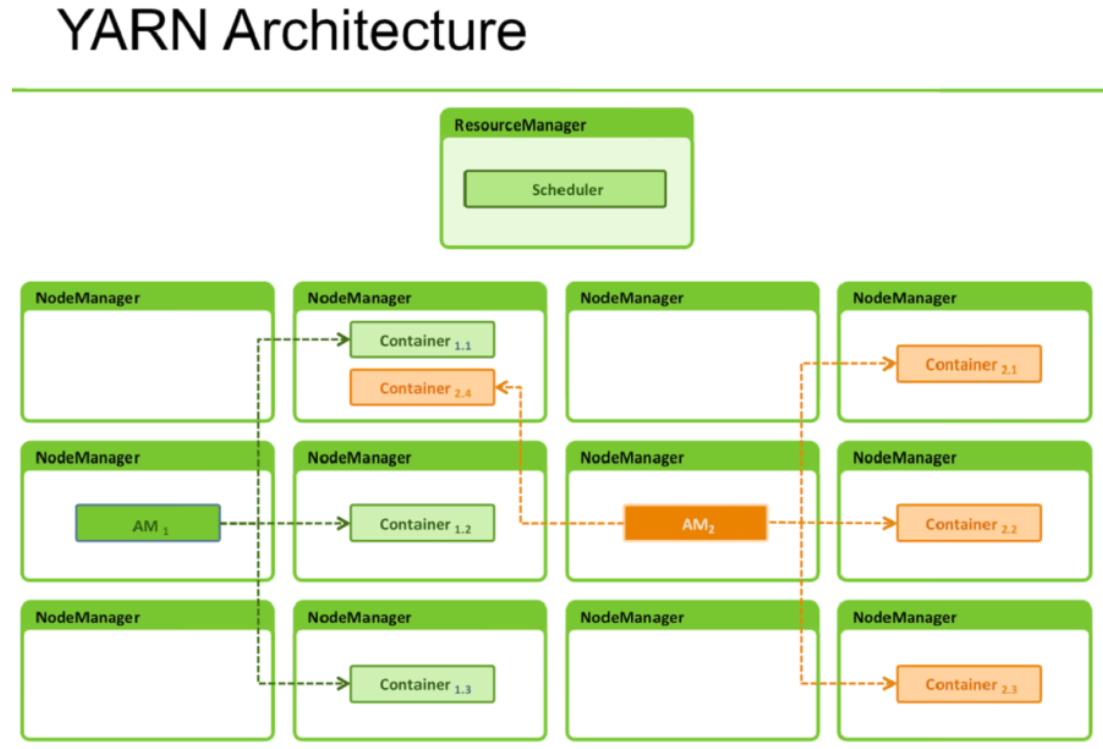
YARN 라벨링으로 Spark의 AM과 Executor를 서로 다른 노드에 배치하는 방법을 소개했습니다. EMR에서 Spot Instance 사용 시 발생하는 장애와 비용 문제를 완화하는 구성도 설명했습니다.
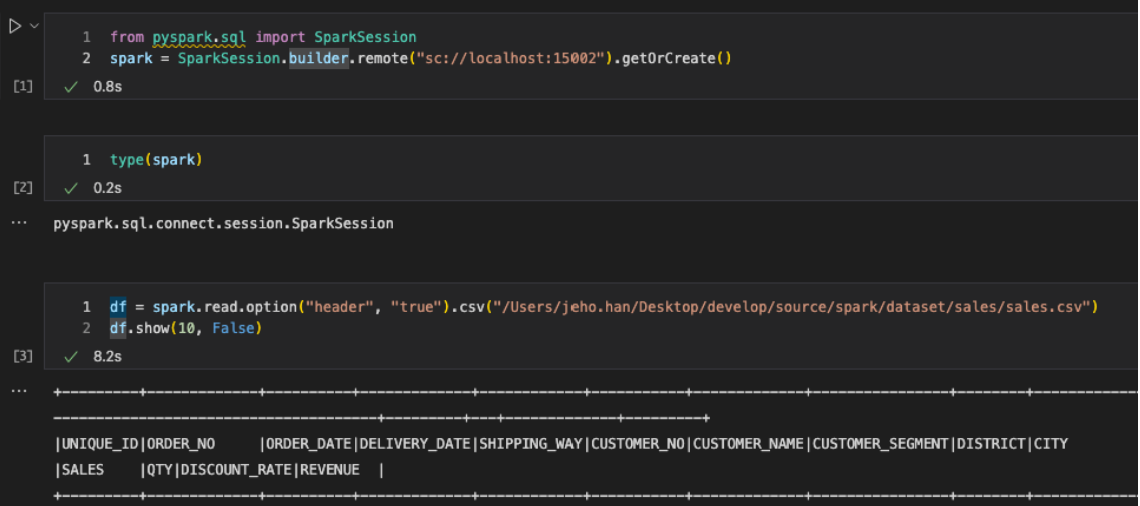
Spark의 원격 연동 한계를 보완하는 Spark Connect의 등장 배경과 동작 방식을 소개했습니다. 서버·클라이언트 환경을 구성해 Jupyter Notebook에서 실제 연결과 실행을 확인했습니다.