
코드 품질 개선 기법 15편: 문법은 이름을 나타낸다
이름은 선언 측의 일관성보다 사용하는 측의 오해 가능성을 줄이는 방향이 중요하다고 설명했습니다. 수식어를 앞에 두는 명명과 언어·플랫폼의 표준 규칙을 따르는 예를 제시했습니다.
#Java#Kotlin
17900

이름은 선언 측의 일관성보다 사용하는 측의 오해 가능성을 줄이는 방향이 중요하다고 설명했습니다. 수식어를 앞에 두는 명명과 언어·플랫폼의 표준 규칙을 따르는 예를 제시했습니다.
태국 현지에서 LINE 앱 영상 통화 품질을 점검하고 경쟁사와 비교한 결과를 정리했습니다. 5G 비트레이트 조정과 혼잡 예측 개선 등 품질 향상 과제도 함께 공유했습니다.

책임을 분리하면 코드가 더 깔끔해질 것 같지만, 제약 조건과 의존성이 오히려 흩어질 수 있었습니다. 클래스 분할뿐 아니라 호출자 부담과 결합도까지 함께 살펴야 했습니다.
회원 인증의 종류와 국내·해외 차이를 정리하고, 가입 흐름을 개선한 사례를 소개했습니다. 인증 방식을 목적별로 묶어 설계하면 부정 사용을 줄이고 이탈률도 낮출 수 있었습니다.
두 상속 트리의 암묵적 대응 관계가 타입 안전성 문제를 만들 수 있음을 설명했습니다. 상속 대신 컴포지션을 쓰거나 제네릭으로 반환 타입을 명시하는 방법을 제안했습니다.
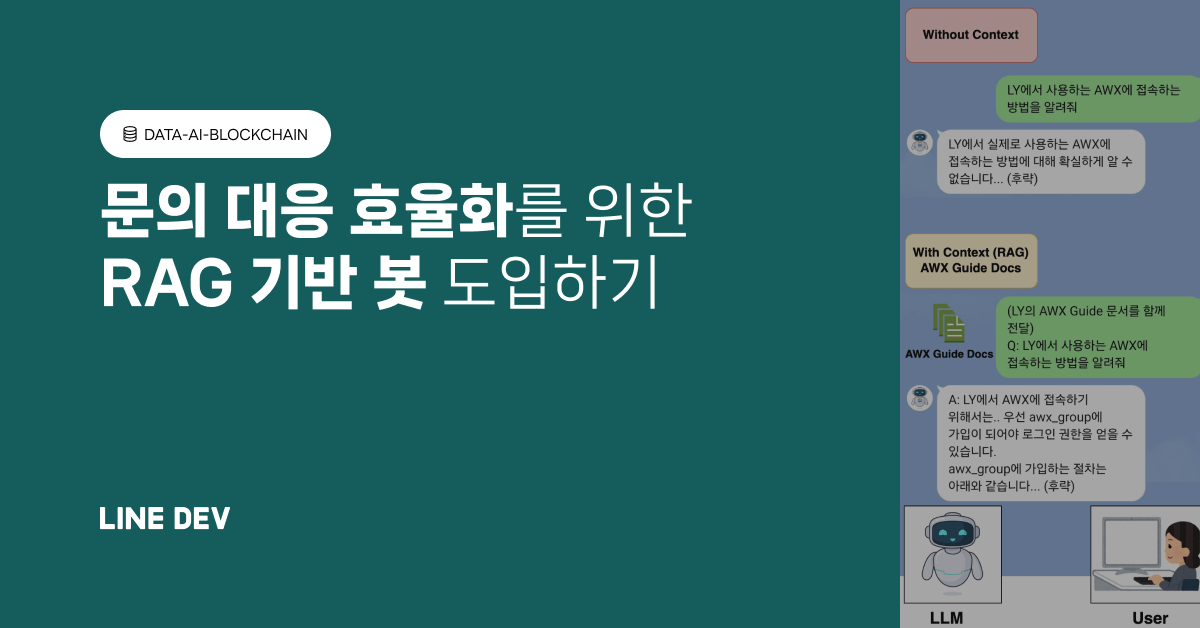
AWX 운영 문의를 줄이기 위해 RAG 기반 지원 봇을 도입한 사례를 소개했습니다. 사내 문서와 Slack 스레드를 벡터 검색해 1차 답변을 제공하고, 필요 시 관리자 호출로 넘기는 흐름을 구성했습니다.
가변 속성을 개별적으로 바꾸면 이전 값이 남아 버그가 생길 수 있었습니다. 정책 객체로 묶어 상태 갱신 시점과 조합을 제한하는 방식이 더 안전했습니다.

인페인팅 기반 배경 인물 제거 결과를 사람 평가와 여러 자동 지표로 비교했습니다. 데이터셋에 따라 Aesthetic Score와 CMMD가 유망한 평가 방법으로 나타났습니다.

수신 객체의 상태를 확인하는 로직은 해당 함수 내부로 옮기는 편이 더 안전할 수 있다고 설명했습니다.콜백보다 반환값으로 결과를 드러내면 호출 흐름도 더 명확해집니다.
생성형 AI 이미지 품질을 자동 평가하고 블랙박스 최적화로 하이퍼파라미터를 탐색한 사례를 다뤘습니다. 수작업을 줄이고 결과 신뢰도를 높였지만, 스타일 판별 지표는 추가 보완이 필요했습니다.
UI와 리포지터리가 최대 개수 규칙을 암묵적으로 공유하는 구조의 문제를 다뤘습니다. `hasMoreItems` 같은 명시적 속성으로 책임을 분리하는 방법을 제안했습니다.
MCP의 개념과 동작 구조를 설명하고, LINE Messaging API로 브로드캐스트용 MCP 서버를 만드는 방법을 소개했습니다. 또한 Claude 데스크톱과 연동해 실제 메시지 전송과 외부 MCP 서버 조합 사례까지 보여주었습니다.
양방향 변환은 한쪽 로직을 기준으로 다른 쪽을 유도하는 편이 안전했습니다. 중복 값과 누락은 테스트로 보강하는 방식이 유효했습니다.

LY Corporation 프런트엔드 조직의 2024년 기술 설문 결과를 정리했습니다. React, Next.js, Jest, Tailwind CSS와 함께 Vite, Vitest 전환 흐름도 확인했습니다.

컬렉션 반환값의 읽기 전용과 변경 가능성은 다를 수 있어 주의가 필요했습니다. 상황에 따라 요소 접근, 스냅샷 복사, 직접 참조 반환을 구분해 사용해야 했습니다.
쿠버네티스의 CPU 요청량, 상한, CFS 스로틀링 관계를 설명하고 상한 제거가 성능에 미치는 영향을 테스트 결과로 정리했습니다. Spring 싱글 테넌시는 상한 제거가 유효했고, Node.js 멀티 테넌시는 일관성 때문에 유지가 적절했습니다.

새 속성을 추가할 때는 기존 이름이 더 이상 적절한지 함께 살펴야 합니다. 이름을 구체화하고 표시 규칙을 분리하면 버그를 줄일 수 있습니다.
생성 이미지 평가는 정답이 없어 품질과 프롬프트 일치율을 함께 보는 접근이 필요했습니다. FID, CLIP Score, Aesthetic Score 등 다양한 지표의 특징과 한계를 정리했습니다.
