초당 100만 건, LINE 앱에 Apache Kafka 종단 간 암호화 적용기
LINE 메신저의 대규모 Kafka 토픽에 종단 간 암호화를 적용한 설계와 운영 경험을 공유했습니다. 공유 KEK, 평문 폴백, 점진적 배포로 무중단 전환과 낮은 성능 오버헤드를 달성했습니다.
#Apache Kafka#보안#encryption
19700
LINE 메신저의 대규모 Kafka 토픽에 종단 간 암호화를 적용한 설계와 운영 경험을 공유했습니다. 공유 KEK, 평문 폴백, 점진적 배포로 무중단 전환과 낮은 성능 오버헤드를 달성했습니다.
Flava DBaaS의 쿠버네티스 기반 아키텍처와 운영 구조를 소개했습니다. 또한 마이그레이션 도구와 서버리스, AI 기반 확장 방향까지 설명했습니다.
LY Corporation의 두 HDFS 플랫폼을 통합 운영하며 겪은 스케일링 문제와 연계 설계를 다뤘습니다.권한 모델, Cross-Realm Kerberos, DistCP를 통해 안전한 데이터 전송 구조를 마련한 과정을 소개했습니다.
Verda와 IMON의 인프라를 OpenTofu와 Terragrunt로 코드화해 GitOps 체계를 구축했습니다. Slack과 AI 에이전트를 연결해 자연어 기반 코드 생성과 변경 자동화까지 확장했습니다.
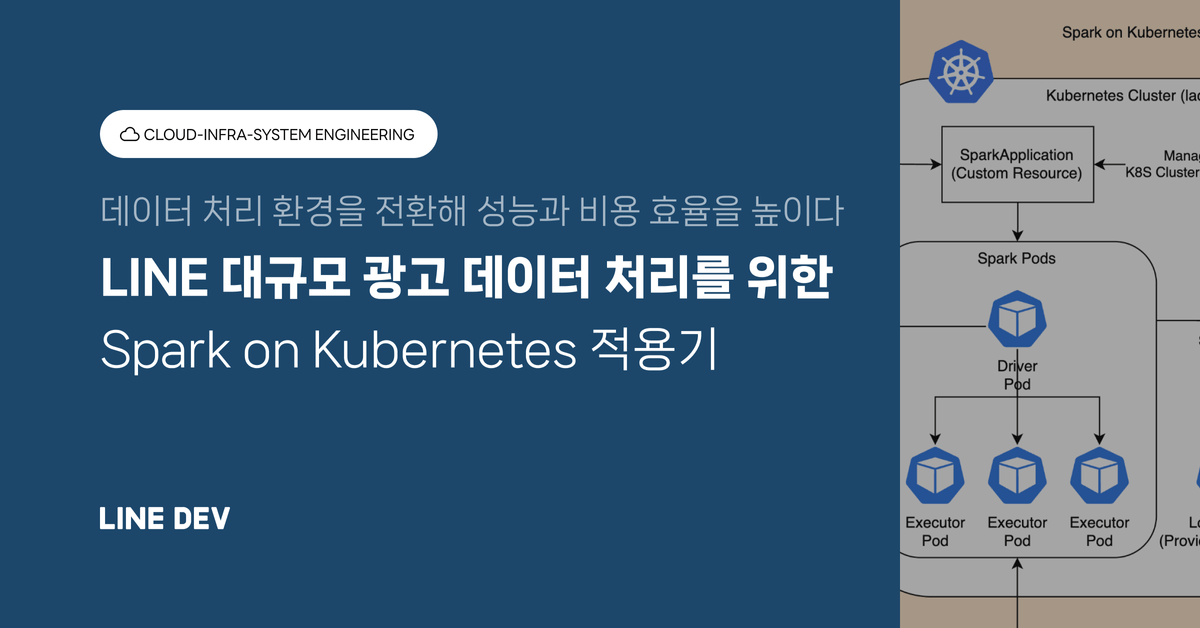
LINE Ads의 대규모 광고 데이터를 처리하기 위해 Spark on Kubernetes를 도입한 사례입니다. 성능 향상, 비용 절감, 버전 유연성을 함께 확보했습니다.
SRE 반복 작업과 문의 대응을 Slack 워크플로 중심의 봇으로 자동화한 개발기입니다. 배포와 일반 요청 처리 시간을 크게 줄이고 운영 가시성도 높였습니다.
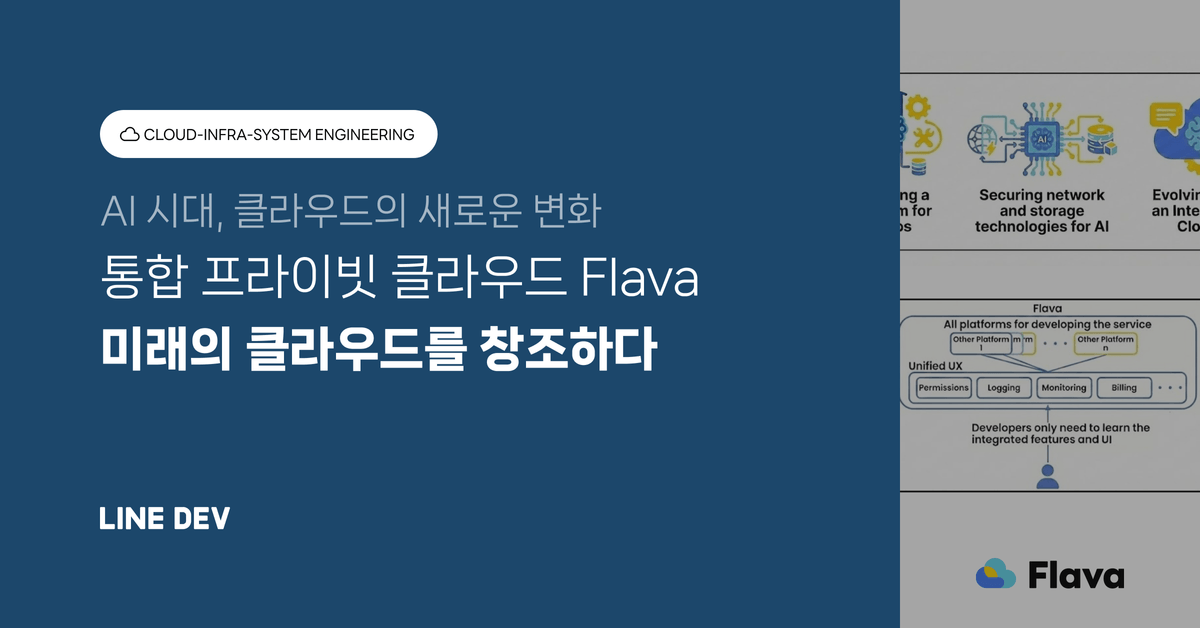
구 LINE과 구 Yahoo Japan의 대규모 프라이빗 클라우드를 Flava로 통합한 아키텍처를 소개했습니다. 단일 리소스 풀, 업스트림 추종, VPC 기본화, 자동화와 관찰 가능성으로 운영 효율을 높였습니다.

LY Corporation의 프라이빗 클라우드 Flava가 향후 어떻게 진화할지 소개했습니다. 개발자 경험, 보안, 스토리지, AI 기반 운영 자동화를 중심으로 미래 방향을 제시했습니다.
Nginx 설정을 공통화하고 멀티사이트 구조로 통합한 인프라 개선 사례를 소개했습니다. Promtail과 Loki, Ansible을 연계해 로그 수집과 배포 자동화까지 확장했습니다.
쿠버네티스의 CPU 요청량, 상한, CFS 스로틀링 관계를 설명하고 상한 제거가 성능에 미치는 영향을 테스트 결과로 정리했습니다. Spring 싱글 테넌시는 상한 제거가 유효했고, Node.js 멀티 테넌시는 일관성 때문에 유지가 적절했습니다.

OBS 플랫폼에 SLI/SLO를 도입해 공용 미디어 플랫폼의 신뢰성을 측정하고 운영에 활용한 사례를 공유했습니다. 로그 기반 메트릭 수집과 Recording Rules로 대시보드 성능을 개선하고 알람 체계를 구성했습니다.
SRE 관점에서 SLI, SLO, SLA의 차이와 필요성을 설명하고 사용자 여정 기반으로 신뢰성을 정량화하는 방법을 소개했습니다. 또한 오류 예산을 활용해 안정성과 개발 속도를 함께 관리하는 운영 방향을 정리했습니다.
Jenkins CI에서 빌드 실패가 급증한 원인을 로그 처리 병목으로 좁혀 분석했습니다. Gradle 로그를 줄여 타임아웃 문제를 해결하고 수행 시간도 단축했습니다.

Playwright와 Jira, Slack 봇을 연계해 장애 알림과 티켓 관리를 자동화한 시스템 구축 과정을 소개했습니다. 쿠버네티스 크론잡과 재시도 튜닝으로 오탐을 줄이고 운영 효율을 높인 사례입니다.

쿠버네티스 컨트롤러로 커스텀 리소스를 선언적으로 관리하는 방법을 설명했습니다. Informer와 WorkQueue를 포함한 내부 동작과 운영 사례도 함께 소개했습니다.

쿠버네티스에서 파드를 분산 배치하는 세 가지 방법과 토폴로지 분배 제약 조건의 핵심 옵션을 설명했습니다. 팀 적용 사례를 통해 고가용성과 운영 안정성을 높이는 설정 방식도 소개했습니다.

쿠버네티스 중계 API 서버를 Python에서 Go로 재구현하고 Informer 캐시를 적용했습니다. 그 결과 800개 노드의 리소스 계산 시간이 약 10초에서 0.2초로 줄었습니다.

쿠버네티스 네이티브 워크플로와 LitmusChaos로 Flink 스트리밍 파이프라인의 카오스 테스트를 자동화한 사례를 소개했습니다. 네트워크 지연, 파드 삭제, 노드 실패를 검증하며 복구 전략과 운영 개선점을 정리했습니다.