
풀필먼트 입고 서비스팀에서 분산락을 사용하는 방법 - Spring Redisson
풀필먼트 입고 서비스의 동시성 문제를 해결하기 위해 Redisson 기반 분산락을 적용한 사례를 소개했습니다. AOP와 어노테이션으로 락을 추상화하고 트랜잭션 커밋 이후 해제로 정합성을 보장했습니다.
#Spring Boot#Redis#Redisson
4800
풀필먼트 입고 서비스의 동시성 문제를 해결하기 위해 Redisson 기반 분산락을 적용한 사례를 소개했습니다. AOP와 어노테이션으로 락을 추상화하고 트랜잭션 커밋 이후 해제로 정합성을 보장했습니다.
헤이조이스가 코로나19 대응을 위해 자체 웨비나 시스템을 2주 만에 구축한 과정을 소개했습니다. AWS IVS, Sendbird, 서버리스 구성으로 운영 효율과 확장성을 확보한 사례입니다.
뷰티 개인화를 위한 프로필 입력을 첫 방문·재방문 상태에 맞춰 단계형과 목록형으로 설계했습니다. 개인정보 동의 흐름을 검토하고, 진입률과 추천 이용 확대를 위한 개선 방향을 제시했습니다.

뷰티컬리의 <나의 컬리 스타일>은 사용자를 더 잘 이해해 맞춤 추천을 강화하기 위한 프로필 기능으로 소개했습니다. 첫 진입과 재방문에 따라 화면 구조를 다르게 설계하고, 동의 프로세스는 협업과 실험으로 개선했습니다.
뷰티 상품 탐색 경험 개선을 위해 웹 필터를 확장하고 React Query를 도입했습니다. URL 상태 저장과 서버 상태 동기화로 탐색 편의성과 데이터 최신성을 높였습니다.

뷰티 필터 프로젝트에서 React Query로 서버 상태 관리를 전환하고 필터 경험을 웹으로 확장했습니다. 고객 탐색 경험 개선과 API 호출 감소, 팀 문화 강화까지 이어졌습니다.
iOS에서 site 전환 구조와 공통 구좌 모델링으로 뷰티 컬리 출시를 지원했습니다. 오픈 후 서비스 상태 관리와 이벤트 처리로 로딩을 개선하고 유입 UI를 데이터로 검증했습니다.

컬리 앱에서 뷰티 컬리 런칭 과정과 전환 구조 개선 사례를 공유했습니다. 초기 오픈과 이후 전환율 개선까지 협업과 데이터 기반 대응이 중심이었습니다.
준실시간 수요예측을 위해 Apache Beam 기반 GCP Dataflow 파이프라인을 도입한 배경과 동작 구조를 설명했습니다. Flex 템플릿·CI/CD 배포 과정과 스트리밍, 권한, 비용 관련 운영 팁을 정리했습니다.
컬리의 준실시간 수요 예측 모델을 위해 Dataflow 파이프라인을 도입한 배경과 전체 동작 방식을 설명했습니다. Beam, Flex 템플릿, CI/CD, 권한 설정 등 실무 적용 포인트도 함께 정리했습니다.
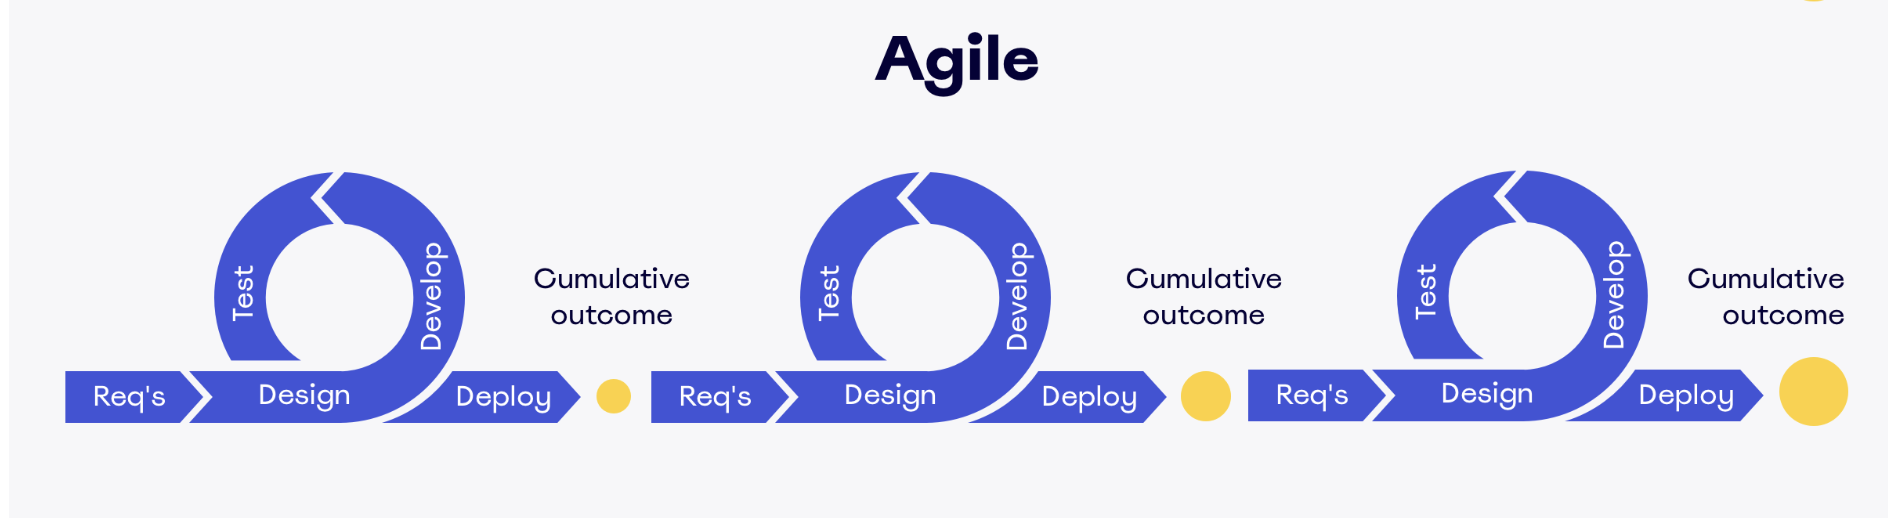
딜리버리프로덕트팀이 9개월간 애자일 코칭으로 교차기능 스쿼드와 스크럼 운영을 정착시킨 경험을 공유했습니다. 릴리스 주기 단축과 협업 개선을 얻었으며, 지속적인 합의와 회고가 필요함을 강조했습니다.
딜리버리프로덕트팀이 9개월간 애자일 코칭을 통해 스쿼드와 스크럼 기반 협업을 정착시킨 과정을 공유했습니다. 릴리스 단축, 팀워크 향상, 지속적 개선의 중요성을 경험으로 정리했습니다.
ProductCon London 2023을 동료들과 원격으로 함께 시청한 학습 이벤트를 소개했습니다. 실시간 번역 도구와 토론을 활용해 프로덕트·애자일 관점의 학습 효과를 높였습니다.
동료들과 ProductCon London 2023를 원격으로 함께 보며 주요 세션과 화두를 정리했습니다. 혼자보다 함께 볼 때 질문과 토론이 늘어 학습 효과가 커졌습니다.
Testcontainers로 Kafka·PostgreSQL·Spring 애플리케이션을 함께 구동해 사용자 시나리오 통합 테스트를 구성했습니다. GitHub Actions 트리거로 배포 이미지 생성 뒤 테스트를 실행해 QA 부담을 줄이는 방식을 소개합니다.
Testcontainers로 Kafka, PostgreSQL, Spring 앱을 함께 띄워 실제 사용자 흐름에 가까운 통합테스트를 구성했습니다. 서버 간 제약 불일치로 생길 수 있는 버그를 QA 전에 조기에 찾고, 배포 후 자동 검증까지 연결했습니다.
BigQuery 기반 CDC 파이프라인으로 정형·비정형 데이터를 Final 테이블에 동기화했습니다. Merge와 리소스 분리로 적재 시간·조회 응답 시간·비용을 개선했습니다.

BigQuery 도입으로 정형·비정형 데이터 파이프라인을 분리해 구축하고, CDC 기반 적재와 Merge Procedure로 원본 정합성을 맞췄습니다. 또한 데이터 레이크하우스화, 쿼리 성능 개선, 비용 절감 효과를 얻었습니다.