
Nx에서 Bun 더 잘 사용하기: Nx 18 -> 21 마이그레이션
Nx 18에서 Bun을 쓰면 lock file 감지와 파싱 문제로 마이그레이션이 꼬일 수 있었습니다. Bun 1.2.x와 Nx 21.4+로 올려 `bun.lock`을 쓰자 빌드와 CI가 안정화되었습니다.
#Nx#Bun#webpack
6000
Nx 18에서 Bun을 쓰면 lock file 감지와 파싱 문제로 마이그레이션이 꼬일 수 있었습니다. Bun 1.2.x와 Nx 21.4+로 올려 `bun.lock`을 쓰자 빌드와 CI가 안정화되었습니다.
로그 레벨을 ERROR와 WARN으로 재정의하고, 상황별 임계치 기반 알람을 구성했습니다. 알람 피로를 줄이면서 운영 문제를 빠르게 인지하도록 로그를 지속 관리했습니다.

관리형 Airflow를 Kubernetes로 이관하며 CPU 급등, OOM, 로그 누락 문제를 분석·개선했습니다. 리소스 격리와 Worker 확장으로 안정성을 높이고 비용을 약 50% 절감했습니다.

관리형 서비스의 Airflow를 Kubernetes로 전환하며 스케줄러 CPU 과부하, 워커 OOM, 로그 누락 문제를 해결한 운영 경험을 공유했습니다. 자원 제한과 노드 분리를 통해 안정성을 높이고 비용도 줄인 사례입니다.
후기 서비스의 조회 병목을 해결하기 위해 AWS Opensearch를 도입한 사례를 정리했습니다. CQRS와 이벤트 기반 구조로 전환하고 성능 테스트와 모니터링까지 함께 적용했습니다.
컬리의 준실시간 수요 예측 모델을 위해 Dataflow 파이프라인을 도입한 배경과 전체 동작 방식을 설명했습니다. Beam, Flex 템플릿, CI/CD, 권한 설정 등 실무 적용 포인트도 함께 정리했습니다.
AWS MLOps 분산학습 워크숍에 참가한 후기를 공유했습니다. SageMaker 기능과 분산학습 트렌드, 데이터 드리프트 모니터링에 대한 인사이트를 얻었습니다.
Datadog Dash 2022에서 모니터링 신기능과 핸즈온 워크숍을 경험했습니다. OpenTelemetry 연동과 서비스·비용·데이터 흐름 관리 기능을 소개합니다.

쿠브플로우 도입 배경과 세이지메이커 비교, 그리고 운영을 위한 초기 설정 팁을 정리했습니다. 데이터 사이언티스트 친화적인 MLOps 환경을 만들기 위한 실무 사례를 소개했습니다.

컬리의 MLOps 구축 초기에 GPU 노드 자동화와 Karpenter 도입 과정을 소개했습니다. NVDP, affinity, consolidation 이슈까지 포함해 운영 포인트를 정리했습니다.

Stage·QA 환경의 반복적인 인프라 작업을 줄이기 위해 Terraform을 도입한 과정을 공유했습니다. tfstate 관리와 리소스 의존성, 협업 검증의 중요성을 시행착오로 정리했습니다.

환경 증가와 반복 작업 문제를 해결하기 위해 Terraform 기반 IaC를 도입한 경험을 공유했습니다. tfstate, 리소스 의존성, 수동 변경 동기화와 협업 검증의 중요성을 설명합니다.
복잡한 Legacy 주문 조회를 Kafka·Elasticsearch·Kibana 기반 실시간 모니터링으로 이전했습니다. 비동기 전송의 flush, ack, 로그 ID를 통해 데이터 유실과 중복 문제를 보완했습니다.
레거시 주문 검색의 성능·정합성 문제를 Kafka와 Elasticsearch 기반 모니터링으로 이전했습니다. 비동기 전송의 flush, ack, 멱등성 설정으로 데이터 유실과 중복 문제를 보완했습니다.
Redis 키 만료·재적재 시 동시 요청으로 발생한 성능 저하를 API 부하 테스트로 재현했습니다. 컬렉션 선택과 캐시 장애 시 DB 부하 대응, 리소스 모니터링의 중요성을 확인했습니다.
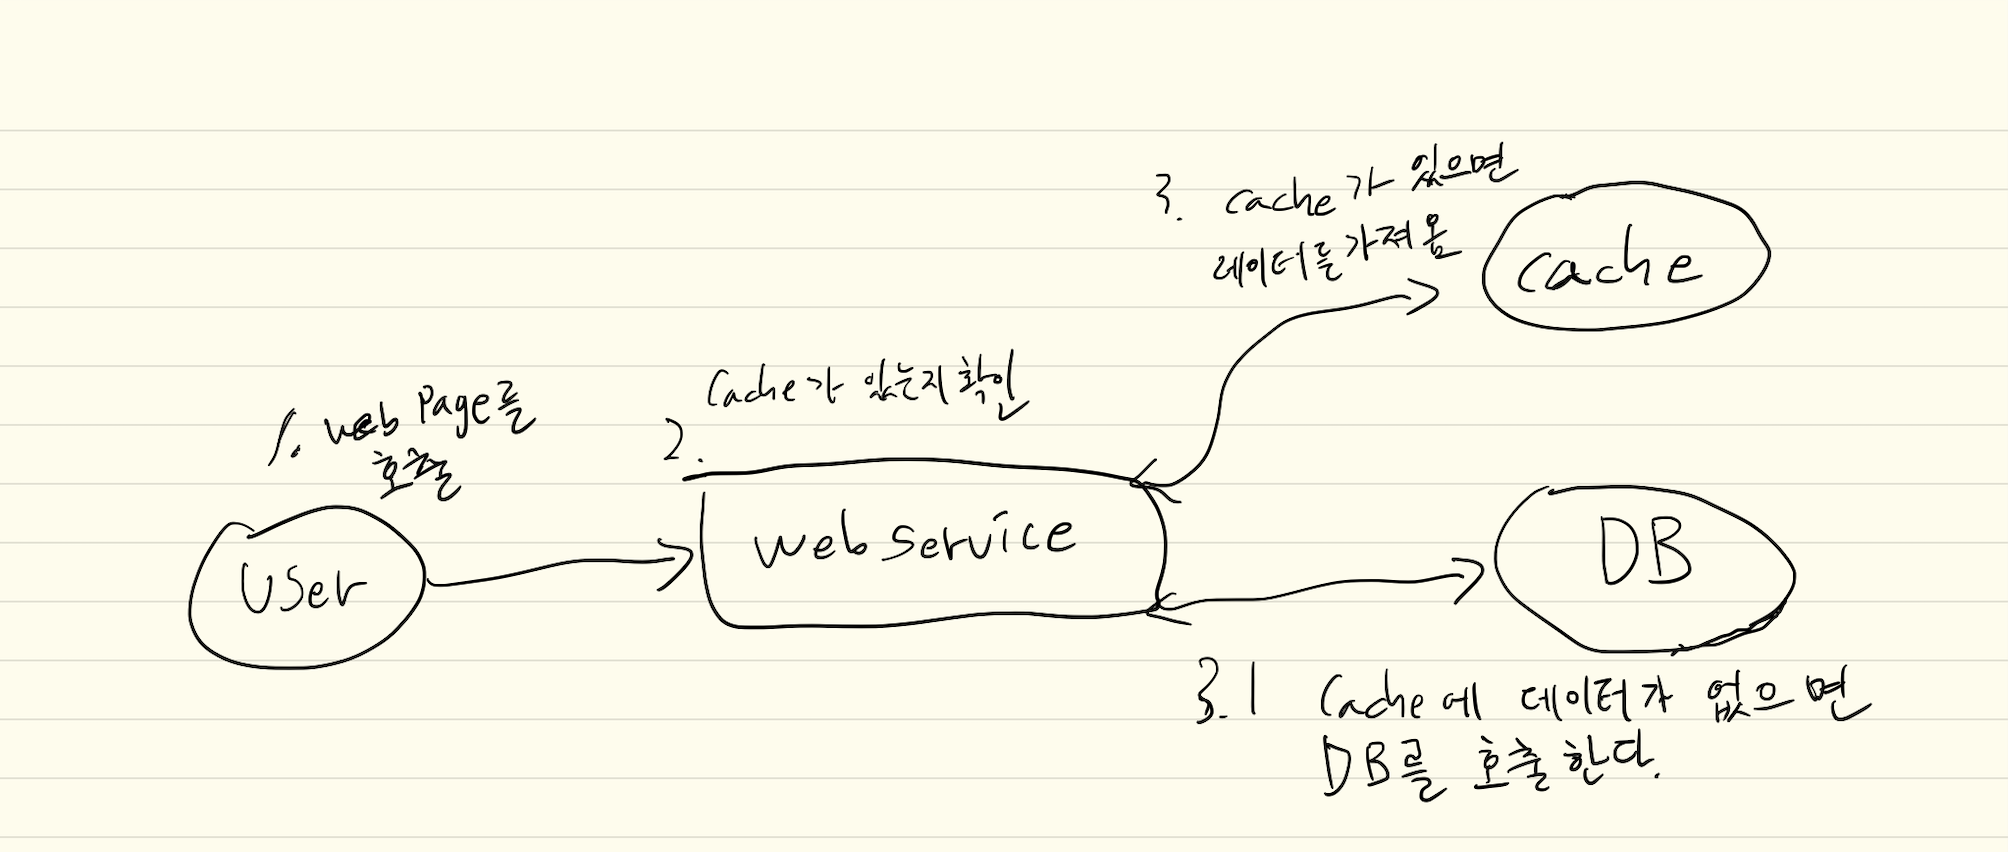
Redis 키 만료 시 동시 GET·SET이 집중되는 장애 상황을 API와 nGrinder로 재현했습니다. 반복 조회 로직 제거로 CPU 사용률과 TPS 저하를 완화하고 운영 주의점을 정리했습니다.
멈춰 있던 기술 블로그를 PR·코드 리뷰 중심의 실험적 저장소로 재정비했습니다. 작성 환경과 튜토리얼을 마련해 조직의 지식 공유 문화를 만들고자 했습니다.
